
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель научили продолжать длинное математическое рассуждение, сохраняя сжатую историю вместо всех прошлых токенов. В препринте Princeton University и Microsoft Research, который не проходил рецензирование, все числа получили сами авторы. AbridgeKV сохранил качество полной истории, оставляя четверть постоянного кэша.
Как блок рассуждения превращается в несколько строк кэша
При генерации трансформер хранит для каждого прошлого токена кэш ключей и значений (KV-кэш), чтобы не пересчитывать всю последовательность на каждом шаге. Чем длиннее рассуждение, тем больше памяти занимает этот кэш; в итоге доступная память ограничивает число запросов, которые GPU может обрабатывать одновременно.
AbridgeKV делит ответ на блоки по 512 токенов. После завершения блока модель запускает набор обучаемых токенов паузы: они читают весь блок, но не выводят текст. Их строки в KV-кэше остаются как сжатое представление, а исходные строки блока освобождаются.
Запрос пользователя при этом хранится без изменений. Токены текущего блока видят запрос, сжатые представления предыдущих блоков и уже написанную часть текущего рассуждения. Поэтому текст остаётся обычным и доступным для проверки, хотя модель продолжает генерацию уже не по его полному кэшу.
Сжатие обучают вместе с моделью на обычной задаче предсказания следующего токена. Ошибка в поздней части ответа проходит назад к токенам паузы и учит их сохранять сведения, которые понадобятся через несколько блоков. Отдельные текстовые резюме, модель-учитель и дополнительная функция потерь не нужны.
Качество обеспечили три решения. Строки сжатого кэша получают позиции внутри заменённого блока, а не после него: так расстояния до более поздних токенов остаются близкими к исходным. Позиции распределяют по всему блоку в особом порядке, поэтому даже небольшой набор строк покрывает его равномерно.
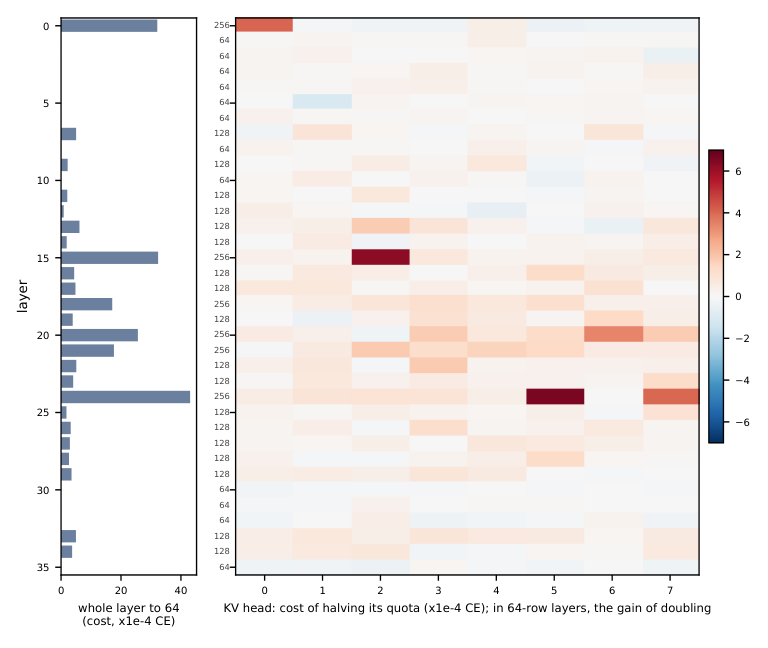
Бюджет также распределяют между слоями не поровну. Сначала модель обучают с одинаковым лимитом, затем у каждого слоя отдельно сокращают доступный кэш и смотрят, насколько хуже он предсказывает следующий токен. Слои, где ошибка растёт сильнее, получают больше строк; у слоёв почти без реакции бюджет забирают.
В vLLM это даёт физическую экономию памяти, а не только логическую маску. Для разных лимитов создают отдельные пулы страниц, поэтому неиспользуемые строки не выделяются, а страницы завершённого блока возвращаются другим запросам.
Удаление старых токенов экономит меньше, чем кажется
Обычные методы освобождают кэш по давности или прошлому вниманию модели. Но промежуточный результат может снова понадобиться далеко впереди, а удалённый токен не оставляет после себя представления. Модель не обучалась работать с такими пробелами и часто компенсирует потерю более длинным ответом, съедая часть экономии.
Проверка охватила 446 задач из математических соревнований при лимите генерации 32K токенов. Точность AbridgeKV отличалась от модели с полным кэшем на 0,8 процентного пункта, и эта разница оказалась в пределах погрешности. Длина ответов также сохранилась.
С учётом незавершённого текущего блока кэш одной последовательности занимал в 3,5 раза меньше памяти. На насыщенном H100 сервер завершал задачу в 3,2 раза быстрее: меньший кэш позволил держать больше параллельных запросов. Именно рост параллельности, а не ускорение вычислений одного токена, дал основной выигрыш.
Все основные модели обучали на базе Qwen3-4B-Base на двух миллиардах токенов математических решений. Сравнение проводили с моделью, обученной на тех же данных, но сохраняющей полный кэш. На коде авторы выполнили только прототипную проверку, поэтому перенос результата на агентов и другие домены пока не подтверждён в том же масштабе.
Для внедрения придётся менять обучение и сервер
AbridgeKV нельзя подключить к готовой модели как политику очистки памяти. Модель должна ещё во время обучения привыкнуть читать сжатые блоки, а сервер — поддерживать разные лимиты кэша по слоям и освобождать исходные страницы после каждого блока. Для существующего продукта это означает новый цикл обучения, проверку качества и доработку vLLM.
Для новой модели с длинными рассуждениями подход меняет расчёт инфраструктуры. Если память под KV-кэш ограничивает размер пакета запросов, обучаемое сжатие может увеличить пропускную способность без скрытого роста длины ответа. При коротких ответах выгода будет меньше: текущий блок всё равно хранится полностью, а токены паузы требуют отдельного прохода.
Работа не показывает, сохранится ли эффект после дообучения готовой модели с подкреплением. Кроме того, каждый блок получает фиксированный бюджет независимо от количества полезной информации. Поэтому метод стоит рассматривать как архитектурное решение для собственного конвейера обучения, а не как универсальную замену очистки кэша в уже работающем API.
Источники
Иллюстрация: рисунок из статьи «AbridgeKV: Compressing Long Reasoning into the KV Cache of Learned Pause Tokens», Jack Cai, Lijie Yang, Vasilis Kontonis и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


