Блог.
Как мы собираем приложения, внедряем AI и почему каждую пятницу что-то выходит.
Все материалы
Сначала новые
Почему хорошей задачи недостаточно для самообучения LLM
HeirCommit проверяет результат обучения на новых задачах, а EvoHeir позволяет сохранить полезный опыт, не наследуя параметры модели, которая его получила.
Кто платит за безопасность LLM: поставщик или его клиенты
Модель рынка показывает, почему конкурирующие клиенты LLM могут вкладывать в безопасность больше оптимального, а поставщик — меньше, и как на этот баланс влияют тарифы и…
Memorilla сжимает внешнюю память LLM до 16 токенов
Memorilla собирает сведения из всей коллекции документов в фиксированный набор скрытых токенов и сокращает контекст без дообучения основной языковой модели.
GPU-оценщик ускорил обучение Lean-прувера без отказа от точной проверки
Каскад из двух моделей предсказывает вердикты Lean на GPU и подменяет медленные проверки при обучении, сокращая шаг GRPO на 31%.
Внутреннюю оценку LLM отделили от формулировки ответа
Метод KAIST извлекает оценку LLM из скрытого состояния и сохраняет точность, когда отрицание вопроса или смена значений ответов сбивает обычный классификатор.
Ансамбль LLM-судей улучшил обучение моделей по рубрикам
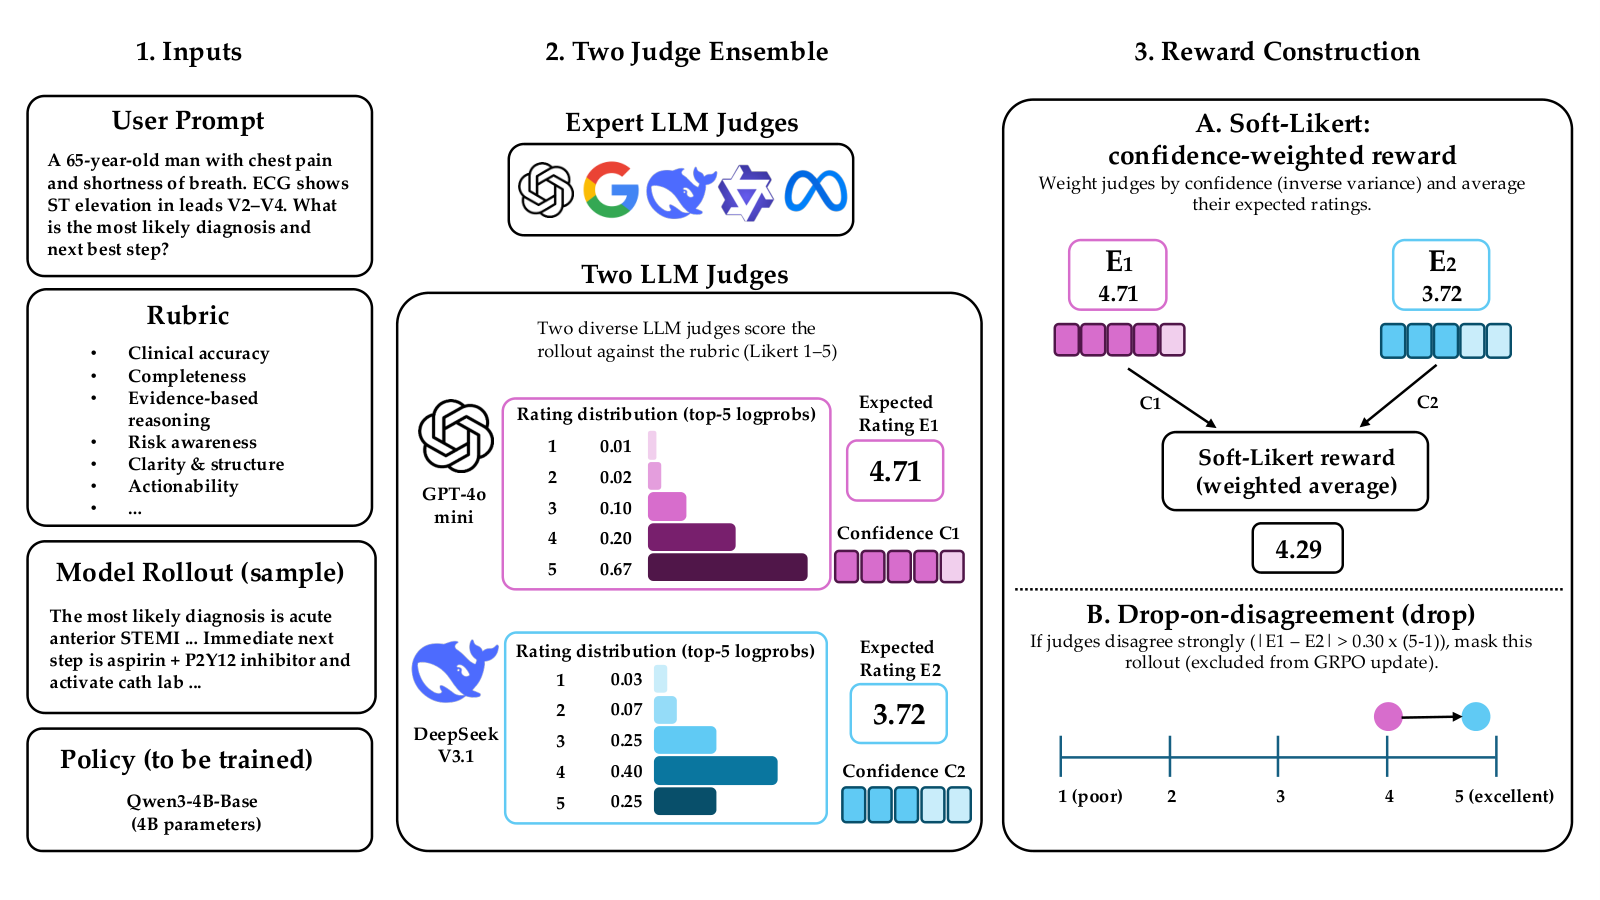
RaRE объединяет оценки LLM-судей с учётом их уверенности и отбрасывает спорные примеры, улучшая обучение Qwen3-4B-Base на медицинских и научных задачах.
KL-UCB-Transfer учится на логах неизвестного алгоритма
KL-UCB-Transfer сокращает исследование вариантов по историческим данным с неизвестной стратегией сбора, но требует надёжно ограничить различие между прошлой и текущей средой.
Маленькая LLM обошла универсальные модели в оптимизации GPU-ядер
Специализированную LLM обучили строить и улучшать сценарии GPU-оптимизации целиком, используя результаты поиска компилятора и обратную связь от выполнения.
Короткая черновая модель сохраняет ускорение на контексте до двух миллионов токенов
Ограничение кэша внимания и перенос позиционных индексов позволяют использовать готовую короткоконтекстную черновую модель на последовательностях до двух миллионов токенов.
RoLaQ сжимает KV-кэш MLA-моделей до 2 бит
RoLaQ совместно настраивает представление и диапазон квантования KV-кэша, увеличивая его вместимость и скорость обработки длинного контекста.
Промежуточное обучение улучшило кодовых агентов Nemotron после SFT
NVIDIA показала, как обучение на репозиториях и траекториях агентов перед SFT улучшает кодовые модели и почему базовые метрики плохо предсказывают результат.
