
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Обычные языковые модели удалось перевести на генерацию, при которой они восстанавливают сразу несколько позиций и могут пересматривать ранние варианты ответа. В препринте, который не прошёл рецензирование и основан на замерах самих авторов, перевод каждой модели занял от 3,1 до 4 часов на одной GPU. Это делает эксперименты с диффузионной генерацией доступнее, но пока не даёт основания заменять ею авторегрессионную модель в рабочем продукте.
Как готовую модель учат восстанавливать весь ответ
Авторегрессионная модель пишет текст слева направо по одному токену и видит только предыдущие позиции. Диффузионная модель начинает с замаскированного блока, несколько раз восстанавливает его и может учитывать контекст с обеих сторон.
Ruurd J. A. Kuiper и Robert A. Bagheri назвали свой рецепт BYOD. Они применили его к Gemma 2 9B, Llama 3.1 8B, Qwen2.5 7B и Ministral 8B. Во всех случаях исходные параметры оставались замороженными, а обучались только LoRA-адаптеры в механизме внимания.
Адаптеры составили 4,1–5,8% итоговых параметров. Их добавили к проекциям запросов и значений, а причинную маску внимания заменили двунаправленной: позиции ответа получили доступ и к предыдущим, и к последующим токенам. Словарь и выходной слой исходной модели не меняли.
Во время обучения инструкция оставалась видимой, а токены ответа случайно скрывались. Модель училась восстанавливать исходный токен в той же позиции, а не предсказывать следующий. На каждый перевод потребовалось не более 102,4 млн токенов из общей смеси инструкций, задач с вариантами ответа, математики и кода.
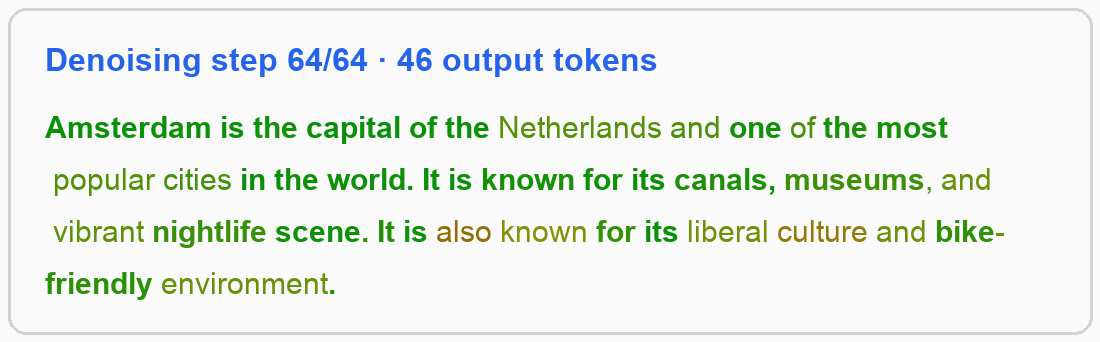
Генерация начинается с полностью скрытого блока фиксированной длины. На каждом шаге модель предсказывает все закрытые позиции, сохраняет наиболее уверенные варианты и повторно маскирует остальные. Качество открытого текста проверяли при ответе длиной 128 токенов за 64 прогона сети.
Знания сохранились лучше, чем качество свободного текста
BYOD-Gemma показала среднюю точность 50,6% на задачах по знаниям, рассуждениям, математике и программированию. LLaDA 8B Instruct в том же наборе и с тем же кодом оценки получила 51,9%. При этом исходные авторегрессионные модели в среднем остались сильнее своих преобразованных версий, особенно в математике и генерации кода.
Разрыв заметнее в свободной генерации. Перплексия — оценка предсказуемости текста внешней моделью, где меньшее значение лучше, — составила у вариантов BYOD 8,3–11,1. У LLaDA она равнялась 4,1, а у исходных авторегрессионных моделей находилась в диапазоне 2,2–3,0.
Контролируемая проверка подтвердила, что преобразование действительно меняет направление внимания. Все четыре модели реагировали на подсказку, расположенную после восстанавливаемой позиции. Однако они не всегда правильно копировали нужный токен: информация доходила до позиции, но модель не всегда использовала её верно.
Проверка охватывала четыре близкие по масштабу модели, дообученные на инструкциях. Для каждой использовали один рецепт и сопоставляли результат с её неизменённым родителем; LLaDA отдельно прогнали в том же контуре оценки. Такая схема показывает, что метод переносится между семействами, но не отделяет влияние архитектуры от исходного качества модели, её токенизатора и объёма адаптера.
Для исследований планы меняются, для внедрения — пока нет
BYOD снижает порог для команды, которая хочет проверить диффузионную генерацию на знакомой архитектуре. Не нужно обучать отдельную базовую модель или менять все её веса: достаточно подготовить набор инструкций, обучить адаптер и переключить внимание на двунаправленный режим. После обучения адаптер можно объединить с исходными проекциями, убрав отдельную ветвь LoRA.
Это полезно для сравнения модельных семейств и экспериментов с генерацией, где порядок заполнения позиций не обязан идти слева направо. Метод также позволяет отдельно исследовать число шагов восстановления, повторное маскирование и работу с заранее заданным блоком ответа.
Для продуктовой архитектуры работа пока не доказывает ускорение. Авторы считали прогоны сети, а не задержку по часам: каждый диффузионный шаг обрабатывает весь блок ответа, поэтому меньше последовательных шагов не означает меньшую задержку или стоимость. Качество текста также падает именно при небольшом бюджете прогонов, который должен был бы дать преимущество.
Экономия относится только к преобразованию уже обученной модели. Она не включает стоимость создания исходной LLM, а перебор конфигураций и оценка всех вариантов потребовали существенно больше вычислений, чем один итоговый запуск. Практический вывод узкий: BYOD подходит для недорогого прототипа и исследований, но выбор диффузионной генерации для рабочей системы всё ещё требует собственных замеров качества, задержки и стоимости на целевом оборудовании.
Источники
Иллюстрация: рисунок из статьи «BYOD: Build Your Own DLM - Efficient Autoregressive-to-Diffusion Language Model Conversion», Ruurd J. A. Kuiper, Robert A. Bagheri, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


