
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Разрыв между генератором ответов и обучающим контуром LLM оказалось полезно делить на постоянную ошибку вычислений и растущее отставание весов. В препринте Yu Li, Yufa Zhou и Tian Lan, который не рецензирован и опирается на замеры самих авторов, коррекция DLC удержала обучение Qwen3-1.7B около траектории обучения на данных текущей модели, тогда как обычное перевзвешивание отклонилось от неё на 115 уровней случайного разброса. Для асинхронного RL это даёт основание синхронизировать веса по состоянию обучения, а не только через фиксированный интервал.
Как один разрыв разделили на две причины
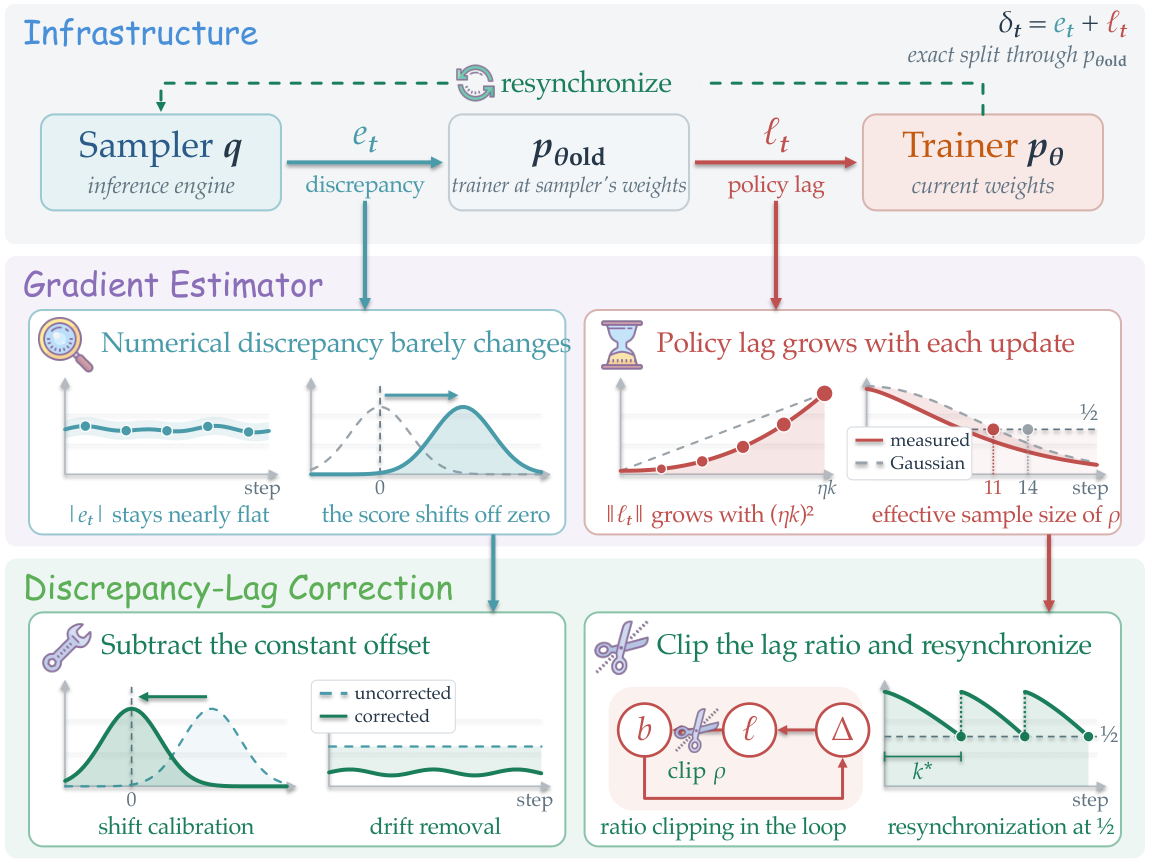
При обучении с подкреплением генератор создаёт ответы, а отдельный процесс считает градиенты. Даже при одинаковых весах они могут назначать токенам разные вероятности: влияют вычислительные ядра, точность чисел и квантование. В асинхронной системе добавляется другая причина — генератор продолжает работать со старой копией весов, пока обучающий процесс уже обновил модель.
Работа разделяет эти эффекты через дополнительный проход обучающего процесса на весах генератора. Разница между вероятностями обучающего процесса и генератора при одинаковых весах становится числовым расхождением. Разница между текущими и старыми весами внутри обучающего процесса становится отставанием политики.
Это разделение важно из-за разной динамики. Числовое расхождение остаётся примерно постоянным и сдвигает обновление в одну сторону. Его ведущую ошибку можно убрать, если вычесть средний градиент логарифма вероятности токена для каждого префикса.
Отставание весов растёт из обновлений самой модели. Остаточная ошибка попадает в следующий шаг, увеличивает новое расхождение и замыкает положительную обратную связь. Поэтому одного вычитания среднего уже недостаточно.
Авторы проверяли подход на Qwen3-0.6B и Qwen3-1.7B в задаче Countdown. Они сравнили генератор в BF16, его квантованную версию в FP8, генератор с устаревшими весами и сочетание обоих источников расхождения. Обучение длилось 40 шагов и повторялось в нескольких запусках, поэтому результаты описывают короткий контролируемый эксперимент, а не длительное обучение на разнообразных задачах.
DLC синхронизирует веса до срыва перевзвешивания
DLC применяет отдельную поправку к каждой причине. Для числового расхождения метод центрирует оценку токена. Для отставания весов он перевзвешивает токены по отношению вероятностей текущей и старой модели, ограничивает слишком большие коэффициенты и следит за эффективным размером выборки.
Эффективный размер выборки показывает, сколько равноценных наблюдений осталось после перевзвешивания. Если почти весь вес сосредоточился на нескольких токенах, формально большой пакет уже даёт мало независимой информации. DLC копирует текущие веса в генератор, когда эта величина падает ниже половины пакета.
На Qwen3-1.7B обычное перевзвешивание пересекло этот порог на шаге 11 и тогда же вышло за пределы случайного разброса между независимыми запусками. Это связывает момент ухудшения не с заранее выбранным интервалом синхронизации, а с измеряемым состоянием распределения весов.
DLC завершила эксперимент с точностью 51,9% против 57,6% у обучения на ответах текущей модели. Поправка без повторной синхронизации иногда разрушала обучение, хотя расхождение на префиксах старого генератора оставалось небольшим.
Причина обнаружилась в собственных ответах обучаемой модели: при срыве до 90% расхождения приходилось на токены, которые старая модель почти не выбирала. Метрика на префиксах генератора не видит такие ветви, потому что он на них не попадает. Повторная синхронизация возвращает эти ответы в область, которую может наблюдать и корректировать генератор.
Что менять в контуре обучения
Работа не предлагает считать любое расхождение одной ошибкой и лечить его общим коэффициентом. Если генератор синхронен, но отличается точностью вычислений, основной кандидат — центрирование числового сдвига. Если ответы приходят от устаревшей копии модели, нужен отдельный коэффициент отставания и правило повторной синхронизации.
Для внедрения такого контроля генератор должен сохранять версию весов, вероятности выбранных токенов и сами идентификаторы токенов. Обучающему процессу потребуется вычислять вероятности на старых весах. Без этого числовое расхождение нельзя отделить от движения модели, а единое отношение вероятностей скрывает источник ошибки.
Сначала стоит устранить расхождения на уровне инфраструктуры. Генератор должен сообщать то распределение, из которого действительно выбирал токен; повторное разбиение текста на токены не должно менять последовательность; состав пакета не должен зависеть от награды ответа. DLC рассчитана на оставшиеся после этого различия в вычислениях и версиях весов.
Для асинхронного контура работа поддерживает пилот динамической синхронизации вместо жёсткого расписания. Контроль нужно вести не только по расхождению на старых префиксах, но и по ответам текущей модели, иначе уход в редко наблюдаемые токены останется незаметным. Решение о переносе в длительное обучение стоит принимать после проверки на собственных задачах, наградах и профиле задержек: в статье подход проверен на двух размерах Qwen3 и одной математической среде.
Источники
Иллюстрация: рисунок из статьи «On the Origin and Evolution of Training-Inference Mismatch in LLM Reinforcement Learning», Yu Li, Yufa Zhou, Tian Lan, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


