
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковую модель научили обновляться по незавершённым цепочкам рассуждений, не доводя каждый ответ до итоговой проверки. В препринте Kaiyue Wen, Luke Bailey, Arvind Mahankali и Tengyu Ma, который не прошёл рецензирование и приводит замеры самих авторов, алгоритм AC2 достиг лучшего результата GRPO при в 2,5 раза меньших вычислениях на генерацию токенов. Это позволяет иначе планировать обучение на длинных ответах: полный прогон перестаёт быть обязательной единицей работы.
Как критик заменяет финальную награду
GRPO генерирует несколько полных ответов на одну задачу, проверяет каждый и сравнивает итоговые награды. Все токены ответа получают одну оценку, поэтому правильное рассуждение с ошибкой в конце целиком считается неудачным. Кроме того, модель обязана завершить каждый прогон, даже если полезный для обучения фрагмент закончился гораздо раньше.
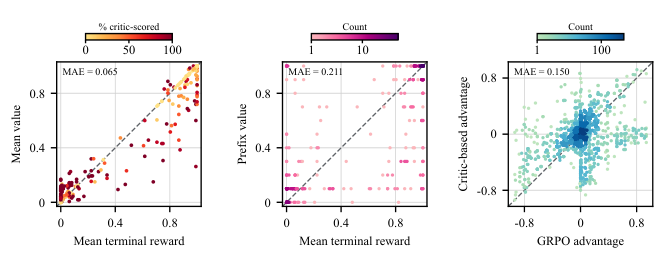
AC2 начинает с префикса, взятого из буфера прошлых траекторий, и генерирует несколько коротких продолжений. Критик — модель ценности — оценивает состояние рассуждения в конце каждого продолжения: насколько вероятно, что из него получится правильный полный ответ. Алгоритм сравнивает эти оценки внутри группы и обновляет только новые токены, а сохранённый префикс использует как контекст.
Критик работает не на каждом отдельном токене. Основная конфигурация оценивает фрагменты длиной до 10 тысяч токенов при бюджете полного ответа до 50 тысяч. Такой фрагмент уже содержит законченную часть рассуждения, которую проще оценить содержательно.
Алгоритм не доверяет критику сразу и одинаково на всех задачах. Сначала он продолжает ответы до конца, сравнивает прогноз с наградой проверяющей системы и переключает конкретную задачу на короткие фрагменты только после того, как ошибка критика становится достаточно малой. Если модель раньше нашла правильное решение, его также передают критику как ориентир.
Полные ответы из процесса не исчезают. Они пополняют буфер траекторий, обучают критика на новых задачах и периодически проверяют, сохранил ли он точность. Отличие от обычной схемы в том, что итоговая награда больше не нужна для каждого обновления политики.
Экономия появилась и между шагами, и внутри шага
Метод проверяли на Qwen3-4B: модель обучали доказывать олимпиадные утверждения на FineProofs-RL, а качество измеряли на 60 задачах IMO-ProofBench. Награду можно было вычислить только для законченного доказательства, поэтому эксперимент соответствует сценарию, где особенно дорого генерировать длинные ответы.
Лучший средний результат GRPO составил 18,50%. AC2 не только достиг этой отметки с меньшими затратами, но и поднялся до 20,57%. Экономия сложилась из двух частей: алгоритму потребовалось на 25% меньше шагов обучения, а на каждом шаге он генерировал более короткие продолжения.
Проверки отдельных компонентов показывают, что результат нельзя свести к одному удачному параметру. Без локальной проверки готовности критика обучение рано выходило на плато. Более короткие фрагменты также останавливали рост качества раньше, а правильное решение в контексте снижало ошибку критика.
Границы эксперимента узкие: одна модель, олимпиадные доказательства, автоматически проверяемая итоговая награда и обучение с повторными проходами по задачам. Именно повторные проходы нужны, чтобы сначала получить полные ответы, оценить критика, а затем вернуться к задаче с короткими продолжениями. Работа не показывает, как сохранить эту схему при единственном проходе по постоянно меняющемуся потоку данных.
Планы меняются только для длинных проверяемых ответов
Для обучения коротким ответам AC2 добавляет буфер траекторий, отдельные обновления критика и контроль его ошибки, но экономит мало токенов. Метод становится практичным кандидатом там, где ответ длинный, его конец можно надёжно проверить, а генерация занимает заметную долю вычислительного бюджета: в математике, коде и других задачах с формальной проверкой результата.
Главное изменение для планирования — критик теперь можно рассматривать не только как поправку к итоговой награде. Он способен временно заменить её на тех задачах, где уже доказал точность. Это открывает промежуточный режим между двумя крайностями: полным прогоном каждого ответа и рискованной оценкой каждого токена.
Переносить AC2 в рабочий контур целиком пока рано. Разумный эксперимент начинается с существующего проверяющего механизма и архива полных траекторий: поверх них можно обучить модель ценности, сравнить её прогнозы с конечными наградами и определить, для какой доли задач безопасно обрывать генерацию раньше. Если критик остаётся точным только на знакомых задачах, вычислительная экономия потребует повторного использования обучающего набора.
Работа меняет прежде всего устройство бюджета. Команде, которая обучает LLM на длинных проверяемых цепочках, стоит отдельно считать полные прогоны, короткие продолжения и стоимость поддержки критика, а не оценивать обучение только числом шагов. Результат AC2 показывает, что генерацию до финала можно сделать выборочной, но не отменить.
Источники
Иллюстрация: рисунок из статьи «Trust the Critic More», Kaiyue Wen, Luke Bailey, Arvind Mahankali и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


