
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Влияние ранних ошибок в длинном диалоге можно снизить, если заново собрать задачу из сообщений пользователя, а прошлые ответы проверить отдельно. AC3 закрыл 55–84% разрыва между полной историей и эталонным вариантом на трёх задачах Lost in Conversation; работа University of California, San Diego и Microsoft Research не рецензирована, а числа получили сами авторы. Метод можно добавить на уровне системы, которая управляет вызовами модели, без её дообучения.
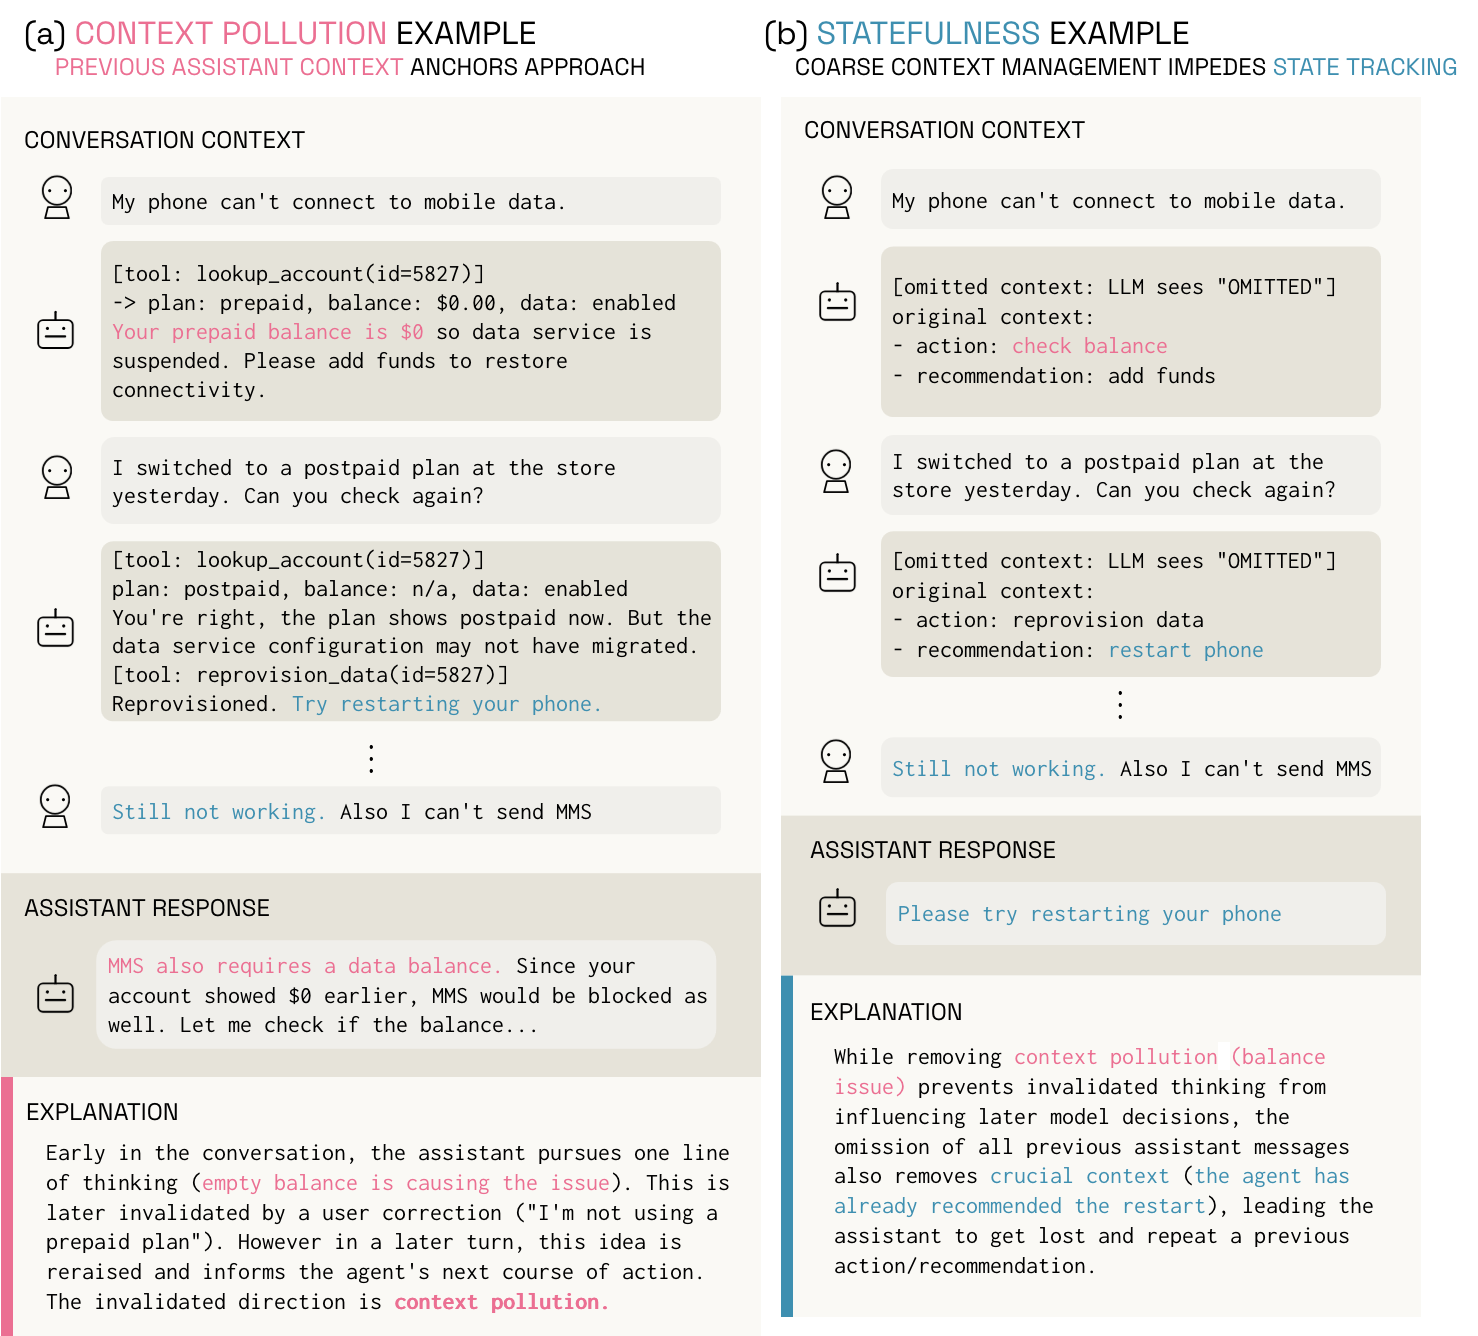
Собственные ответы модели закрепляют неверную трактовку
В многошаговом диалоге модель читает не только требования пользователя, но и свои предыдущие ответы. Если она рано поняла задачу неправильно, её рассуждение остаётся в истории и продолжает влиять на следующие шаги — даже после того, как пользователь уточнил условие.
Простое решение — убрать из контекста все сообщения ассистента. Оно работает, когда сообщения пользователя вместе содержат полную постановку: например, вопрос постепенно раскрывают по частям, но ответ не зависит от созданного моделью черновика.
В рабочих продуктах диалог часто устроен иначе. Фразы «сократите второй абзац» или «добавьте поле в этот запрос» ссылаются на результат, который есть только в ответах ассистента. У агента там же могут находиться результаты вызовов инструментов и уже принятые решения. Полное удаление такой истории очищает ошибочную трактовку, но одновременно уничтожает нужное состояние.
Поэтому задача состоит не в том, чтобы сократить контекст, а в том, чтобы разделить три сущности: исходные требования пользователя, подтверждённую работу ассистента и рассуждения, которые последующие уточнения сделали неверными.
Как анализатор собирает спецификацию без подсказок ассистента
AC3 запускает отдельный анализатор перед очередным ответом. Сначала он получает только системное сообщение и реплики пользователя, объединяет требования и учитывает поздние исправления. Сообщения ассистента на этом этапе исключают программно, а не инструкцией в запросе.
Такое разделение оказалось существенным. Когда анализатор видел рассуждения ассистента, он сам привязывался к ошибочной версии задачи и на двух из трёх заданий работал хуже обычного полного контекста. Просьба игнорировать прежние ответы не устранила эффект.
На следующем шаге анализатор получает собранную спецификацию и всю историю. Теперь он проверяет прошлую работу ассистента относительно независимого описания задачи: отмечает подходящие результаты и находит расхождения.
После проверки AC3 может изменить контекст тремя способами. Augment добавляет разбор к исходной истории, но оставляет ошибочные сообщения на месте. Reset заменяет диалог шаблоном со спецификацией и подтверждённой работой. Rewrite просит ещё один вызов LLM перестроить историю, что даёт больше свободы, но может потерять детали при пересказе.
Эксперименты с искусственно добавленными ошибками показали, что Reset и Rewrite не вырезают только вредные фрагменты. Они удаляют почти всю сторону ассистента и восстанавливают задачу заново. Поэтому AC3 следует рассматривать не как точечный редактор истории, а как механизм аварийной пересборки контекста.
Когда AC3 меняет архитектурный план
На Lost in Conversation, где пользовательские сообщения полностью задают задачу, результат на программировании вырос с 15,8% до 64,4%. На реальных диалогах WildChat модель-оценщик GPT-5-mini предпочитала ответы с AC3 полной истории и удалению сообщений ассистента, однако другие оценщики не всегда подтвердили этот выбор. На CollabLLM результаты зависели от модели и задания.
В tau2-bench полное удаление ответов ассистента дало 0%: вместе с сообщениями исчезали результаты инструментов. AC3 продолжал выполнять задачи, но уступил полной истории на 7–12 процентных пунктов. Для агентов с состоянием это аргумент не в пользу автоматического внедрения AC3, а против грубой очистки истории.
Работу проверяли на Lost in Conversation, WildChat, CollabLLM и tau2-bench. Первые три набора охватывают задачи по математике, коду, базам данных и обычным диалогам; последний проверяет работу с инструментами. Большая часть опытов использует заранее выбранные сложные истории или имитацию пользователя, поэтому результаты ещё не показывают, как метод поведёт себя в долгих производственных сессиях.
Для чат-систем, где пользователь постепенно уточняет требования, AC3 даёт практический шаблон: хранить исходную историю, отдельно собирать актуальную спецификацию и сбрасывать контекст только после обнаружения расхождения. Дообучать базовую модель не требуется, но каждый анализируемый ход добавляет два или три вызова LLM, а значит — задержку и расходы.
Для инструментальных агентов план менять рано. Сначала нужно измерить, какая доля следующих действий зависит от результатов, записанных только в сообщениях ассистента. Чем таких зависимостей больше, тем консервативнее должен быть оператор: полную историю стоит сохранять, пока собственные тесты не покажут пользу пересборки.
Источники
Иллюстрация: рисунок из статьи «Agentic Context Management for Multi-Turn Human-AI Conversations», Matthew Ho, Chenglong Wang, Baolin Peng и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


