
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Одну и ту же длинную историю диалога или набор документов научились передавать между LLM разного размера без повторной обработки целевой моделью. ACCT сохранил или улучшил качество целевой модели при сокращении кэша на 75%, а преобразование контекста длиной около 19 тысяч токенов шло в 6,5–21,2 раза быстрее его повторной обработки, хотя работа не рецензирована и числа получили сами авторы. Это позволяет отделить модель, которая читает контекст, от модели, которая отвечает на запрос.
Как кэш одной модели превращают в память другой
Во время обработки контекста LLM сохраняет для каждого токена кэш ключей и значений (KV-кэш). При генерации модель обращается к этим состояниям через механизм внимания и поэтому не пересчитывает предыдущие токены заново.
Обычный KV-кэш привязан к параметрам и устройству конкретной модели. Даже две модели из одной линейки записывают состояния в несовместимых форматах: у них могут различаться число слоёв, размер представлений и количество голов внимания. Простое копирование кэша между ними не работает.
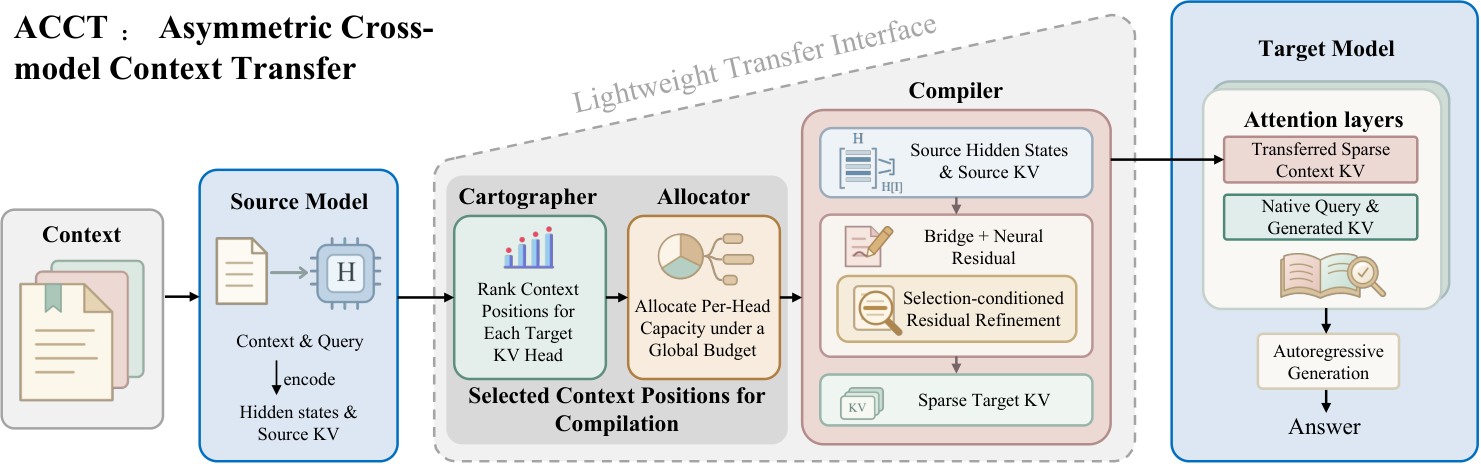
ACCT строит промежуточный интерфейс из трёх компонентов. Cartographer оценивает полезность каждого токена отдельно для каждого слоя и каждой головы целевой модели. Оценка зависит от запроса: один и тот же фрагмент контекста можно сохранить для вопроса о фактах и отбросить для вопроса о выводах.
Allocator распределяет общий бюджет памяти между слоями и головами. Он не выдаёт всем одинаковое число токенов, а учится оставлять больше места тем частям модели, которым контекст нужнее. Последние 32 токена контекста резервируются в каждом блоке, чтобы ближайший к запросу фрагмент не исчез из-за ранжирования.
Compiler преобразует выбранные состояния исходной модели в ключи и значения, которые понимает целевая. Линейное отображение задаёт основу преобразования, а дополнительная сеть исправляет его с учётом всего контекста. Целевая LLM получает готовый разреженный кэш, обрабатывает только запрос и затем генерирует ответ обычным способом.
Исходную и целевую модели при обучении не меняют. Сначала интерфейс учится ранжировать токены по тому, насколько их удаление меняет внимание модели, затем распределяет ёмкость по качеству правильных ответов и в конце подгоняет преобразованные состояния под родной кэш цели.
Отбор токенов оказался важнее полного переноса
Метод проверили в обоих направлениях между Qwen3-4B и Qwen3-8B, Llama-3.2-3B и Llama-3.1-8B, а также Qwen2.5-7B и Qwen2.5-32B. В оценку вошли шесть направленных пар, 11 задач и фиксированный набор из 10 000 примеров. Модели внутри каждой пары использовали общее соответствие токенов числовым идентификаторам.
Набор охватывал общие тесты HellaSwag, Winogrande, MMLU, PIQA и WikiText2, а также задачи, где ответ сильнее зависит от переданного контекста: SearchQA, TriviaQA, BoolQ, RACE, WikiHop и PubMedQA. Эталоном служила целевая модель, которая сама читала полный исходный контекст.
ACCT приблизился к этому эталону на многих задачах и превзошёл его на части тестов. Лучше всего перенос проявил себя в вопросах по открытым источникам. На чтении с пониманием, многошаговых рассуждениях и некоторых задачах языкового моделирования разрыв с полной обработкой контекста сохранялся.
Полный перенос не всегда оказался лучшим вариантом. На задачах с открытыми вопросами выборочный кэш при половине и четверти исходного объёма работал лучше, чем перенос всех состояний без Cartographer и Allocator. Случайный выбор токенов резко ухудшал результаты, а равномерное распределение памяти между слоями уступало обученному на нескольких тестах.
Интерфейс обучали только на SearchQA, но перенос также улучшал отдельные результаты на TriviaQA, MMLU, WikiText2 и PubMedQA. Это показывает переносимость за пределы обучающей задачи, однако эффект зависел от модели, направления и типа теста.
Когда ACCT меняет архитектурный план
Метод подходит к системам, которые направляют запросы между моделями разного размера, но часто используют одну историю диалога, найденные документы или состояние процесса. В такой схеме небольшая модель может первой обработать контекст, после чего более крупная получит его внутреннее представление без собственного полного прохода.
ACCT пока нельзя рассматривать как универсальный формат кэша. Перенос проверяли только внутри одного семейства, а для каждой пары моделей и каждого направления обучали отдельный интерфейс. Замена Qwen3-4B на Qwen3-8B требует одного преобразователя, обратный переход — другого; перенос между Qwen и Llama работа не проверяет.
Заявленное ускорение также нельзя напрямую подставлять в расчёт задержки всего запроса. Оно сравнивает преобразование готовых состояний с повторной обработкой контекста целевой моделью. Исходная модель всё равно должна прочитать контекст и запрос, поэтому выигрыш зависит от того, была ли эта работа нужна системе независимо от переноса и можно ли повторно использовать её результат.
Для проектирования это скорее основание добавить экспериментальную ветку, чем менять рабочий стек. Проверять стоит конкретную пару моделей, типичные длины контекста, качество на собственных задачах и полную задержку с исходной обработкой. Если маршрутизация уже ограничена моделями одной линейки, ACCT показывает технически правдоподобный способ не платить второй раз за чтение длинного контекста.
Источники
Иллюстрация: рисунок из статьи «ACCT: Asymmetric Cross-LLM Context Transfer», Yuzhe Liu, Haolin Tian, Tonghan Wang, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


