
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Ручную проверку ML-меток можно направлять не на самые сомнительные ответы классификатора, а на данные, способные изменить итоговый научный вывод. ACORN приблизил оценки присутствия видов к результатам полной ручной разметки при меньшем числе проверок, хотя препринт не рецензирован и все числа получены самими авторами. Такой подход меняет сам критерий отбора: эксперт проверяет не ошибку модели, а важное для решения наблюдение.
Как проверка метки превращается в проверку вывода
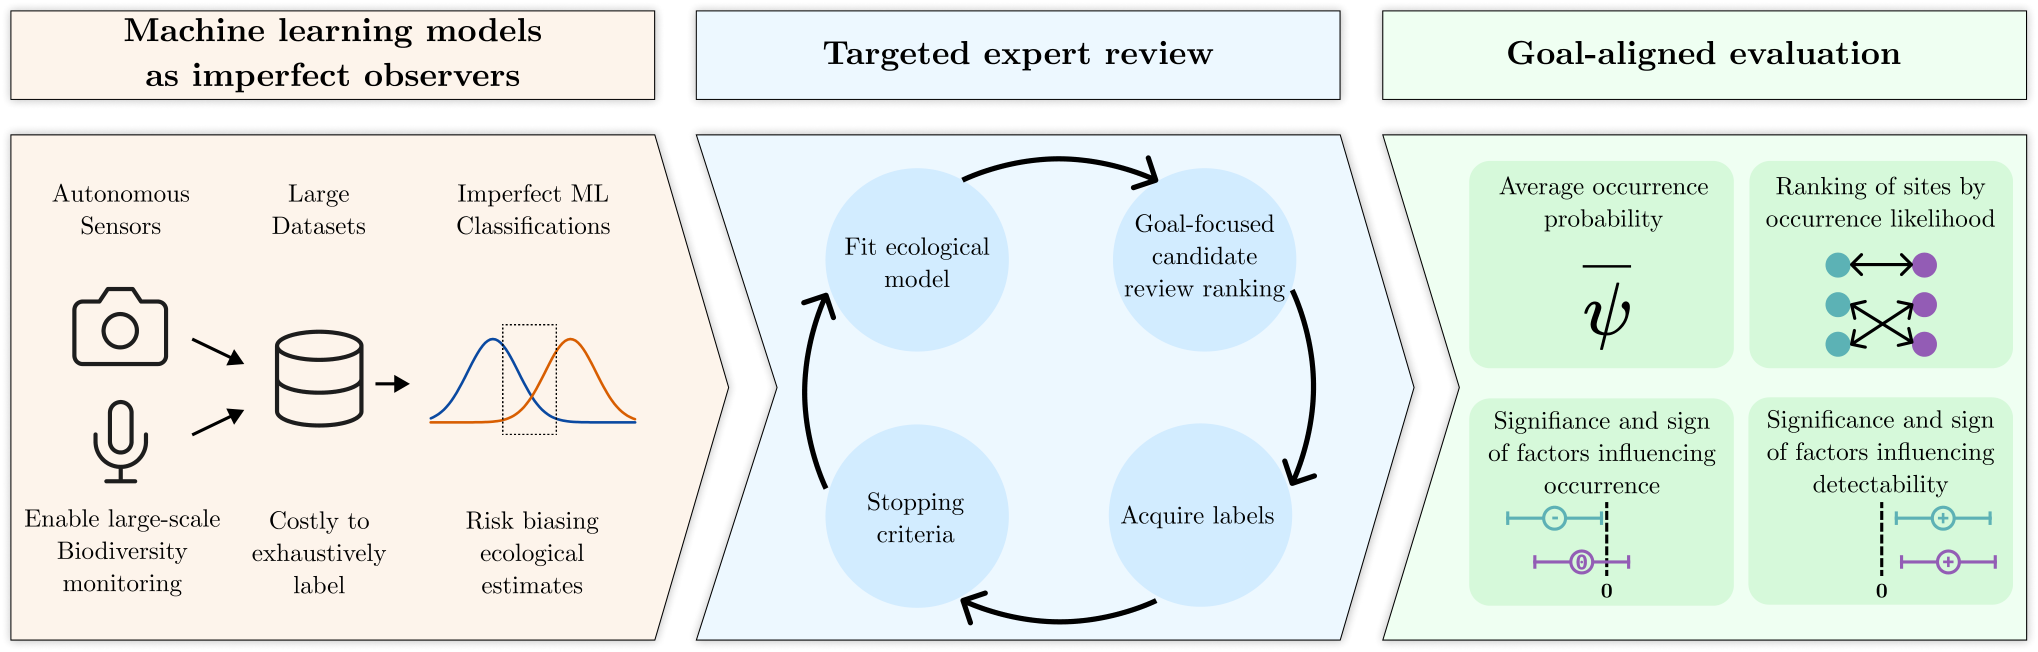
Работа MIT, Google Research и The Institute for Bird Populations посвящена экологическим наблюдениям с фотоловушек и акустических датчиков. Классификатор ищет вид на изображении или в записи, но исследователю обычно нужно другое: оценить вероятность присутствия вида в конкретном месте и понять, как она зависит от температуры, высоты или других условий.
Обычный конвейер сначала превращает оценку классификатора в ответ «вид есть» или «вида нет», а затем передаёт эти ответы статистической модели. Порог отбрасывает часть информации. Кроме того, одна ошибка может непропорционально повлиять на вывод, если она пришлась на важное место, время или редкий набор условий.
ACORN сохраняет непрерывную оценку классификатора и связывает её с моделью присутствия вида. Эта модель раздельно учитывает два события: вид действительно обитает на участке и датчик сумел его зарегистрировать. Поэтому низкая оценка классификатора не становится автоматически доказательством отсутствия.
- Задать конечную величину. Система должна знать, что требуется уточнить: вероятность присутствия, порядок участков по этому показателю либо влияние природных условий на присутствие и обнаружение.
- Передать исходные оценки. Вместо жёстких меток модель получает оценки классификатора по всем наблюдениям и подтверждённые экспертом ответы по уже проверенной части.
- Оценить пользу кандидатов. Для каждой непроверенной записи ACORN рассматривает возможные ответы эксперта и вычисляет, насколько они сократят неопределённость выбранного научного результата.
- Проверить наиболее полезную запись. Полученная метка обновляет модель присутствия, после чего ценность остальных кандидатов рассчитывается заново. Так система учитывает контекст и не тратит работу на дублирующие наблюдения.
- Остановиться по ценности следующего шага. Проверку можно завершить, когда ожидаемый прирост информации стал мал либо новые метки почти перестали сдвигать итоговые оценки.
Где целевой отбор обошёл проверку по точности
Метод проверили на двух типах данных: акустических записях для 50 видов и снимках iWildCam для 25 видов. Эксперименты охватывали распространённые и редкие классы, а также разные природные факторы, связанные с присутствием и обнаружением животных.
ACORN сравнили с пятью стратегиями отбора, включая случайную проверку и правила, ориентированные на классификатор. Эталоном служила модель, построенная по полностью проверенным человеком меткам.
Качество оценивали по четырём сторонам итогового вывода: вероятности присутствия, порядку участков, влиянию условий на присутствие и влиянию условий на обнаружение. ACORN по этим критериям приближался к эталону при меньшем объёме ручной проверки, чем нецелевые стратегии.
Точность классификатора объясняла согласие с экологическим эталоном лишь частично. Хорошее распознавание отдельных записей ещё не гарантировало правильных выводов по участкам и природным факторам. Это и есть основной результат работы: полезность метки зависит не только от уверенности классификатора, но и от её места в последующей статистической модели.
Когда команде стоит менять план проверки
Работа меняет план, если ML-разметка служит входом для расчёта риска, рейтинга, прогноза или другого агрегированного показателя. В таком продукте выбор записей по неуверенности классификатора оптимизирует промежуточную метрику, которая может слабо совпадать с целью системы.
Первое практическое изменение — хранить исходные оценки модели, а не только метки после порога. Второе — описать конечный расчёт как вероятностную модель, чтобы система могла оценить влияние новой проверки на результат. Без такого слоя целевой отбор сводится к эвристике.
Третье изменение касается бюджета экспертов. Фиксированную долю ручной проверки можно заменить правилом остановки, которое сопоставляет ожидаемую пользу следующей метки с её стоимостью. Порог придётся выбирать по допустимому риску: ранняя остановка экономит работу, но может оставить нестабильными выводы о влияющих факторах.
Переносить ACORN в любой конвейер без дополнительной проверки рано. Эксперименты относятся к моделям присутствия отдельных видов по данным стационарных датчиков; более сложные пространственные модели и совместное распределение бюджета между видами авторы оставляют для дальнейшей работы. Для продуктовых команд ценность препринта пока не в готовом универсальном компоненте, а в архитектурном принципе: ручную проверку следует оптимизировать под решение, которое принимает вся система.
Источники
Иллюстрация: рисунок из статьи «Targeted Review for AI-Assisted Biodiversity Surveys: Active Continuous-Score Occupancy Modeling», Timm Haucke, Lauren Harrell, Justin Kay и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


