Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
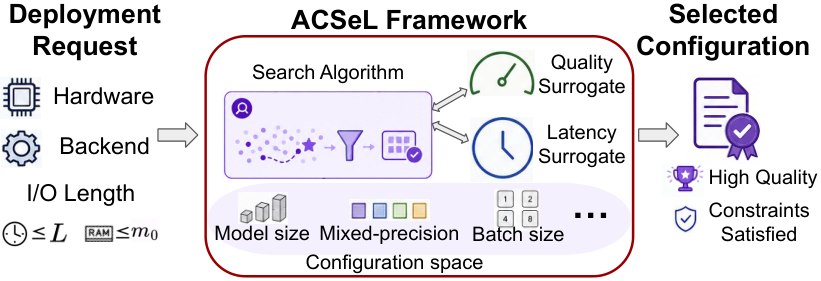
ACSeL автоматически выбирает размер LLM, пакет обработки и схему квантования так, чтобы модель уложилась в память и задержку устройства и сохранила максимально возможное качество. В препринте UT Austin, который не прошёл рецензирование и опирается на замеры самих авторов, калибровка задержки увеличила долю строго подходящих конфигураций на NVIDIA Jetson Thor в 2,5 раза. Для команды это превращает настройку локального развёртывания из ручного перебора в поиск по заданным ограничениям, но не отменяет контрольный запуск на целевом оборудовании.
Качество оценивают без полного запуска бенчмарков
Команде приходится одновременно выбирать размер модели, число запросов в пакете, способ квантования и разрядность отдельных слоёв. Квантование снижает разрядность весов и промежуточных значений, чтобы сократить расход памяти и ускорить вычисления. Если соседние группы слоёв используют разные форматы, число возможных конфигураций быстро растёт: для моделей Qwen3 и GPU архитектуры Ampere пространство поиска достигает порядка 107 вариантов.
ACSeL сначала отбрасывает варианты, которые не помещаются в память или, согласно прогнозу, нарушают ограничения по времени до первого токена и времени на каждый следующий токен. Среди оставшихся система ищет конфигурацию с наименьшей ожидаемой потерей качества.
Чтобы не прогонять каждую модель по полному набору задач, авторы ввели относительное ухудшение качества модели (RMQD). Метрика сравнивает распределение вероятностей следующего токена у сжатой модели и у крупнейшей полноразрядной модели того же семейства. Чем меньше различие распределений на небольшом калибровочном корпусе, тем лучше конфигурация сохраняет поведение эталона.
Такое сравнение всё ещё требует запуска модели, поэтому поверх RMQD обучают линейный прогноз. Он получает размер модели, алгоритм квантования, разрядность и расположение слоёв с разной точностью. Затем BandPareto перебирает не произвольные комбинации, а полосы соседних слоёв и оставляет варианты с лучшим соотношением качества, памяти и задержки.
На одной из проверок вычисление RMQD оказалось в 91,6 раза быстрее прямой оценки ответов на GSM8K. Выигрыш появляется потому, что модель обрабатывает готовые последовательности параллельно, а не генерирует ответ токен за токен с последующей проверкой.
Небольшая калибровка исправляет прогноз задержки
Исходная модель задержки AIConfigurator складывает время отдельных операций по заранее собранной таблице. Для смешанной разрядности этого недостаточно: вариант может пройти расчётный фильтр, но нарушить целевую задержку после запуска. ACSeL корректирует прогноз по нескольким сквозным измерениям на конкретном сочетании GPU и серверной системы.
Для эксперимента прогноз качества обучили на 226 конфигурациях, а задержку откалибровали по 30 запускам. Проверка охватывала рабочую станцию с NVIDIA RTX A6000, пограничную платформу NVIDIA Jetson Thor и системы vLLM, SGLang и TensorRT-LLM. Запросы различались длиной входа и ответа, размером модели и допустимой задержкой.
Калибровка снизила типичную относительную ошибку прогноза времени до первого токена со 113% до 30,6%. При допуске в 10% к целевой задержке BandPareto с калибровкой нашёл реально подходящую конфигурацию для 84% запросов на A6000 и 64% на Thor. При строгой границе доля успешных результатов тоже выросла на обеих платформах, хотя ошибки около порога сохранились.
BandPareto показал лучшую выполнимость среди проверенных способов поиска и чаще случайного поиска либо подъёма к локальному оптимуму сохранял качество смешанной разрядности. Эталоном служила лучшая конфигурация среди вариантов, которые команда уже измерила в экспериментальном наборе, а не доказанный глобальный оптимум всего пространства.
ACSeL полезен после выбора оборудования, а не вместо него
Работа меняет планы команд, которым нужно поддерживать несколько моделей, устройств или профилей нагрузки. Вместо отдельной ручной настройки каждого сочетания можно один раз обучить прогноз качества, а затем переносить его между платформами. Затраты на сравнение с эталонной моделью также можно распределить между последующими поисками.
Прогноз задержки переносится хуже. Для нового GPU, серверной системы или режима нагрузки придётся собрать таблицу операций и провести несколько сквозных измерений. Результат поиска всё равно нужно запустить на устройстве: даже после калибровки часть вариантов нарушала строгую границу задержки.
Если продукт работает на одном заранее известном устройстве и использует одну фиксированную модель, прямое профилирование небольшого числа конфигураций может оказаться проще. ACSeL становится полезнее, когда меняются ограничения по памяти и времени ответа, а слой за слоем вручную подбирать разрядность уже дорого.
Метрика RMQD тоже не заменяет продуктовую проверку. Она хорошо отражала общий тренд на использованных задачах, но измеряет сходство распределений токенов с крупной эталонной моделью. Для медицинского устройства, автомобиля или специализированного помощника итоговую конфигурацию нужно дополнительно проверить на собственных сценариях и критериях качества.
Источники
Иллюстрация: рисунок из статьи «ACSeL: Adaptive Configuration Search for Hardware-Constrained LLM Inference», Bokun Wang, Hung-Yueh Chiang, Diana Marculescu, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.