
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
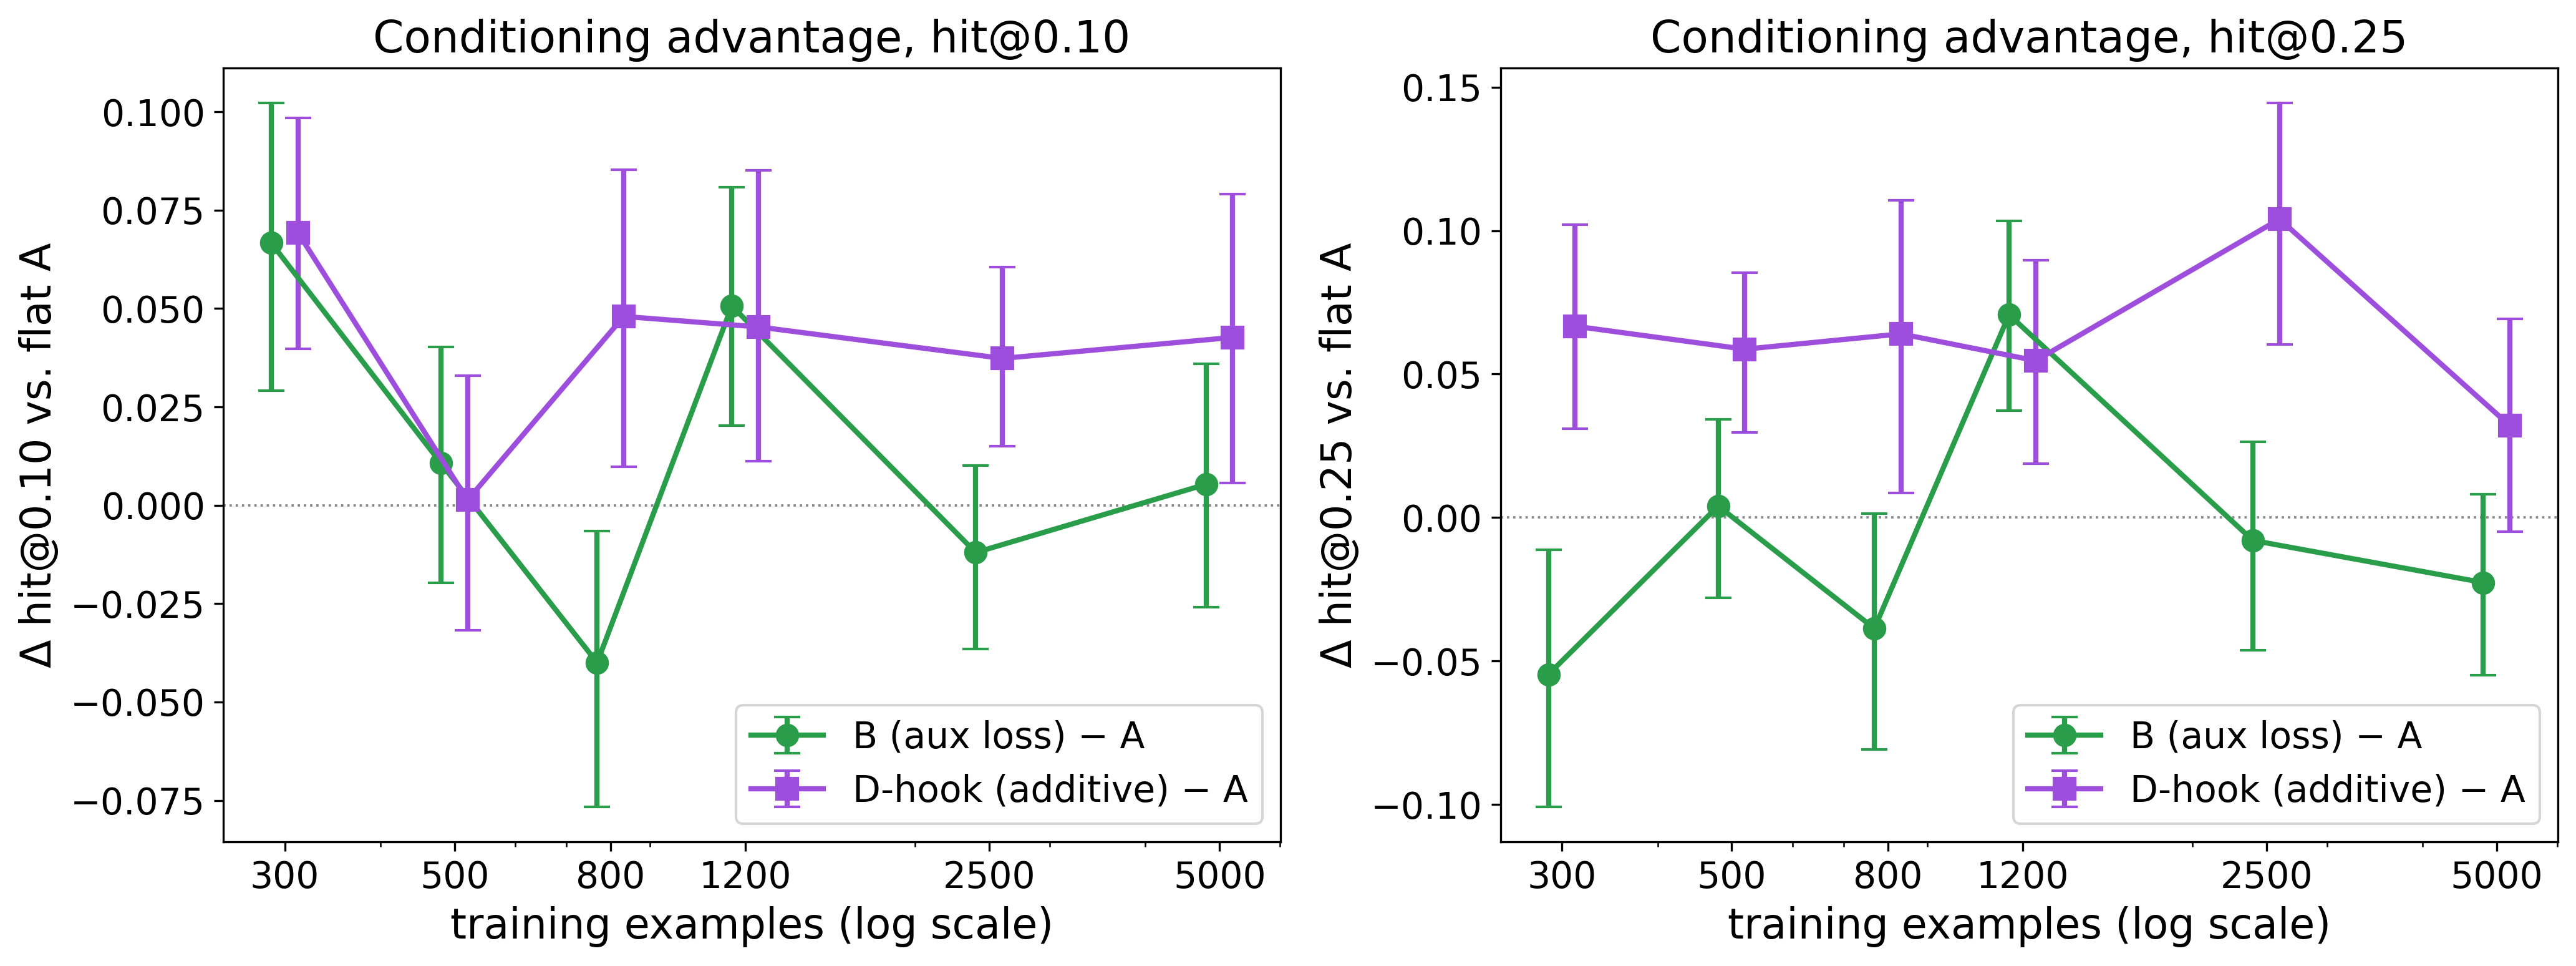
Тип действия помогает небольшому GUI-агенту находить цель на экране, но почти весь выигрыш исчезает после исправления подготовки данных. В препринте Stanford University, который не проходил рецензирование и содержит замеры самих авторов, три способа передачи типа прибавили 5–7 процентных пунктов. Для архитектуры агента это не довод в пользу отдельного механизма: сначала стоит проверить разметку, а затем попробовать обычное слово в запросе.
Как тип действия передавали модели
GUI-агент решает две разные задачи: выбирает действие и определяет место на экране. Например, сначала решает нажать, прокрутить или ввести текст, а затем выдаёт координату. Работа Aadi Chauhan и Arthur Ilyasov проверяет, как передать первое решение небольшой модели, которая отвечает за второе.
Основой служила Qwen2-VL-2B с адаптерами LoRA. Модель обучали на Android in the Wild: основная выборка включала 1200 шагов для обучения и 250 для проверки. В поток входили нажатия, прокрутки и ввод текста; модели не получали историю предыдущих действий.
Базовая версия видела снимок экрана и инструкцию, но не знала выбранный тип. С ней сравнили пять вариантов. Тип добавляли как отдельную задачу при обучении, жёстко ставили слово действия перед координатой, прибавляли обучаемый вектор ко входу, помещали обучаемый токен в начало запроса или прямо писали действие обычным словом.
Все варианты получали одинаковые данные, порядок примеров, вычислительный бюджет и способ декодирования. Главная метрика hit@0.10 показывает долю ответов, где предсказанная точка находится достаточно близко к цели: расстояние не превышает десятую часть нормализованного размера экрана.
Выигрыш создала координата несуществующего касания
На смешанном потоке базовая модель правильно локализовала 22,9% целей. Дополнительная задача подняла результат до 29,3%, обучаемый добавочный вектор — до 28,2%, а слово в запросе — до 30,2%. Жёсткая маршрутизация и отдельный токен не дали статистически подтверждённого преимущества.
Однако эти результаты описывают не столько полезный пространственный сигнал, сколько защиту от дефекта подготовки данных. Android in the Wild хранит для ввода текста точку касания за пределами экрана. Преобразователь разметки прижимал её к началу координат, поэтому все события ввода получали одну и ту же фиктивную цель.
Базовая модель не знала, что пример относится к вводу текста, и переносила эту закономерность на обычные нажатия: её предсказания смещались к углу экрана. Когда события ввода убрали из обучения, результат базовой версии вырос почти на семь пунктов, а ни один способ передачи типа уже не превзошёл её по основной метрике. На отдельном потоке только из нажатий и прокруток тип действия тоже не помог.
Отдельный токен сначала выглядел неудачной архитектурой, но причина оказалась в режиме обучения. Его вектор почти не менялся при общей скорости обучения. Когда для него выбрали более высокую скорость, результат сравнялся с тремя работающими вариантами, хотя преимущество над базовой моделью осталось недоказанным.
Планы стоит менять в пайплайне, а не в архитектуре
Для прикладной команды самый безопасный первый вариант — написать тип действия в запросе. Он не добавляет параметров и в этом эксперименте работал не хуже дополнительной задачи и обучаемого вектора. Если тип нужен лишь как обучающий сигнал, дополнительная задача удобнее: во время работы модели отдельный классификатор ей не требуется.
Нельзя оценивать такой механизм только с правильным типом действия. Классификатор первого этапа достиг точности 84%, но весь двухэтапный конвейер не показал надёжного преимущества над базовой моделью. При ошибочном типе все варианты, которые использовали его во время работы, резко теряли точность.
Работа также показывает, зачем проверять вмешательства после обучения: подставлять правильный, ошибочный и пустой сигнал. Так можно выяснить, читает ли модель добавленный вектор и насколько зависит от него. Без этой проверки улучшение легко принять за эффект архитектуры, хотя его создаёт разметка.
Ещё один сбой возник при передаче готовых векторных представлений вместо идентификаторов токенов. Qwen2-VL молча переключала визуальные токены на одномерные позиции и теряла девять пунктов. Сохранение обычного пути входных идентификаторов устранило провал; такой тест стоит включить в проверку любого кода, который вмешивается во входные представления мультимодальной модели.
Вывод относится к одной модели, адаптерам LoRA, небольшим срезам Android in the Wild и одному режиму обучения. Проверка на Mind2Web оказалась слишком сложной для использованного масштаба, поэтому работа не показывает, как способы передачи типа поведут себя на более крупной модели или другом наборе интерфейсов. Но она уже меняет порядок экспериментов: аудит координат и классов должен предшествовать усложнению архитектуры.
Источники
Иллюстрация: рисунок из статьи «Decoupling What from Where: How Should a Small GUI Grounding Model Receive the Action Type?», Aadi Chauhan, Arthur Ilyasov, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


