
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Порядок учебных задач для улучшения ИИ-агента можно менять по ходу работы, направляя следующие запуски на ещё не исправленные слабости. В препринте POSTECH, KAIST и Microsoft, который не проходил рецензирование и где числа получили сами авторы, ActiveSaddler обошёл заранее заданный порядок сценариев на обоих проверенных наборах задач. Для команд это превращает подбор учебных примеров в отдельную часть архитектуры оптимизатора, а не в одноразовую подготовку датасета.
Слабость обвязки становится учебной целью
Обвязка агента задаёт инструкции, доступные инструменты и правила, по которым система контролирует выполнение задачи. Автоматический оптимизатор запускает агента на учебных сценариях, разбирает неудачные траектории и меняет эту обвязку, не обновляя веса самой модели.
Обычно сценарии ставят в очередь до начала оптимизации. Такой порядок не учитывает, что после каждого исправления полезность задач меняется: один дефект уже устранён, другой сохранился, а несколько разных сценариев могут указывать на одну и ту же проблему.
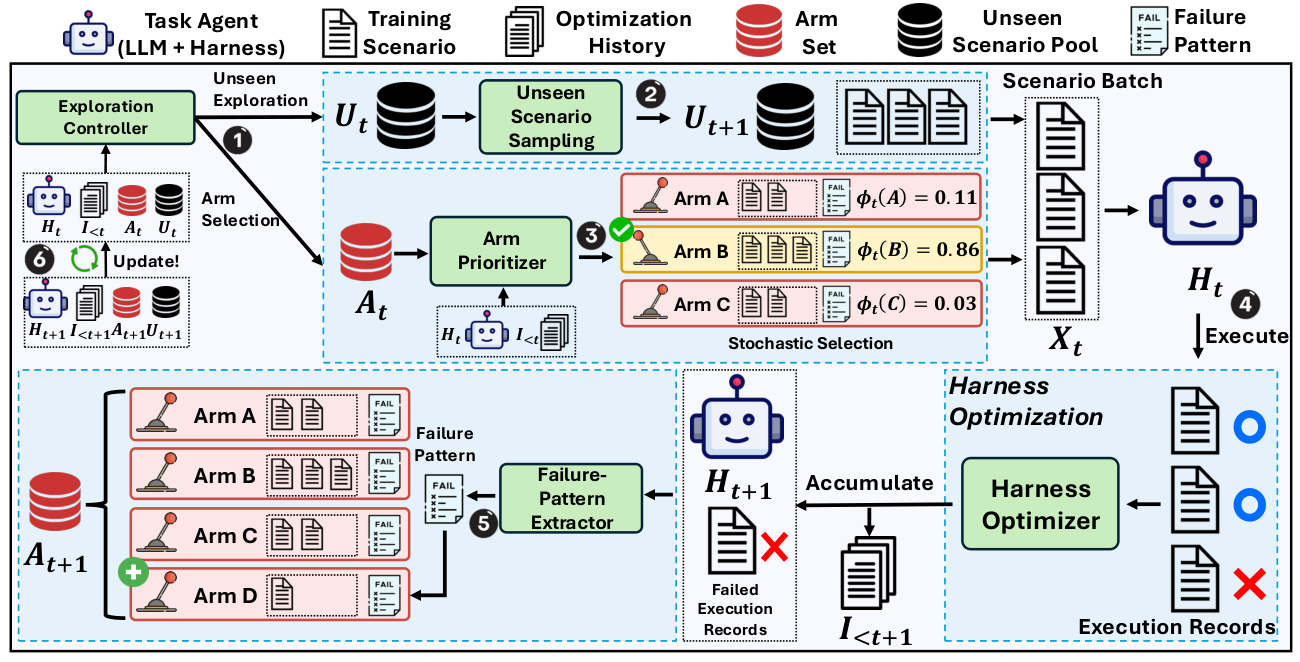
ActiveSaddler вместо отдельных неудачных запусков ведёт реестр повторяющихся схем отказа. Система извлекает из траектории симптом, сопоставляет его с известными схемами и либо добавляет свидетельство к существующей цели, либо создаёт новую. У каждой цели остаются описание слабости, связанные с ней сценарии и история попыток исправления.
Перед следующим шагом система выбирает между двумя действиями. Она может вернуться к известной слабости и собрать пакет из связанных сценариев либо запустить ещё не просмотренные задачи, чтобы найти новые дефекты. Поэтому учебный план меняется вместе с обвязкой.
Известные слабости оценивает LLM. Она учитывает серьёзность дефекта, вероятность исправления, охват сценариев и риск побочных эффектов. Оценка не остаётся постоянной: успешное исправление снижает ценность следующей попытки, а повторное появление ошибки даёт основание снова поднять цель в очереди.
Авторы описывают эту схему как выбор между несколькими вариантами, ценность которых меняется со временем. Важна не математическая формулировка сама по себе, а разделение обязанностей: существующий оптимизатор по-прежнему решает, как менять обвязку, а ActiveSaddler определяет, на каких данных делать следующий шаг.
Фиксированный бюджет принёс больше решений с первой попытки
На GAIA2 ActiveSaddler повысил Pass@1 — долю задач, решённых с первой попытки, — на 4,4 процентного пункта относительно того же оптимизатора с заранее установленным порядком сценариев. На Terminal-Bench 2.0 разница составила 7,5 пункта. Бюджет запусков агента оставался одинаковым для сравниваемых вариантов.
Эксперименты выделяли на оптимизацию 1 400 запусков для GAIA2 и 490 для Terminal-Bench 2.0. Разбор отдельных компонентов показал, что результат зависел сразу от трёх решений: группировки ошибок по схемам отказа, пересчёта их приоритета и перехода между повторной работой над известными проблемами и поиском новых.
Проверка охватывает два набора агентных задач и автономную оптимизацию до внедрения. В GAIA2 учебные, проверочные и тестовые задачи разделяли по персонажам, чтобы тест отличался по распределению. Terminal-Bench 2.0 содержит 89 задач, поэтому его разделили случайно. Это проверяет перенос исправлений за пределы учебной части, но не показывает, как метод поведёт себя при непрерывных изменениях производственной среды.
Учебный план стоит вынести в отдельный слой
Работа меняет планы команд, которые уже автоматически улучшают инструкции, инструменты или управляющую логику агента. Фиксированного списка задач для такого контура недостаточно: после каждого изменения нужно заново решать, какой сценарий даст наиболее полезную обратную связь.
Для внедрения не требуется заменять сам механизм исправлений. Поверх него нужен слой, который хранит версии обвязки, связывает неудачные траектории с общими схемами отказа и учитывает результат каждой попытки. Без такой истории система не сможет отличить актуальную слабость от уже устранённой.
Практический эксперимент стоит строить как сравнение при равном бюджете запусков. Базовый вариант проходит сценарии в заранее заданном порядке, второй выбирает их по текущим ошибкам. Оценивать следует итоговую обвязку на отдельном тестовом наборе, а не число исправлений: частые изменения сами по себе не означают, что агент лучше решает новые задачи.
ActiveSaddler добавляет собственные обращения к LLM для разбора ошибок и выбора целей. Поэтому выигрыш в запусках агента ещё не гарантирует меньшую полную стоимость. Команде придётся учитывать весь контур: диагностику, ведение реестра, создание исправлений и проверку кандидатов.
Если процесс пока сводится к ручному редактированию одной инструкции, отдельный планировщик будет преждевременным. Метод становится уместен, когда есть повторяемый набор сценариев, автоматическая оценка результата, раздельные учебная и проверочная части и ограниченный бюджет экспериментов. Тогда порядок задач действительно становится управляемым ресурсом наравне с выбором модели и логикой оптимизатора.
Источники
Иллюстрация: рисунок из статьи «ActiveSaddler: Automated Curriculum Learning for Agent Harness Optimization», Sungho Park, Wonjoong Kim, Jue Zhang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


