
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
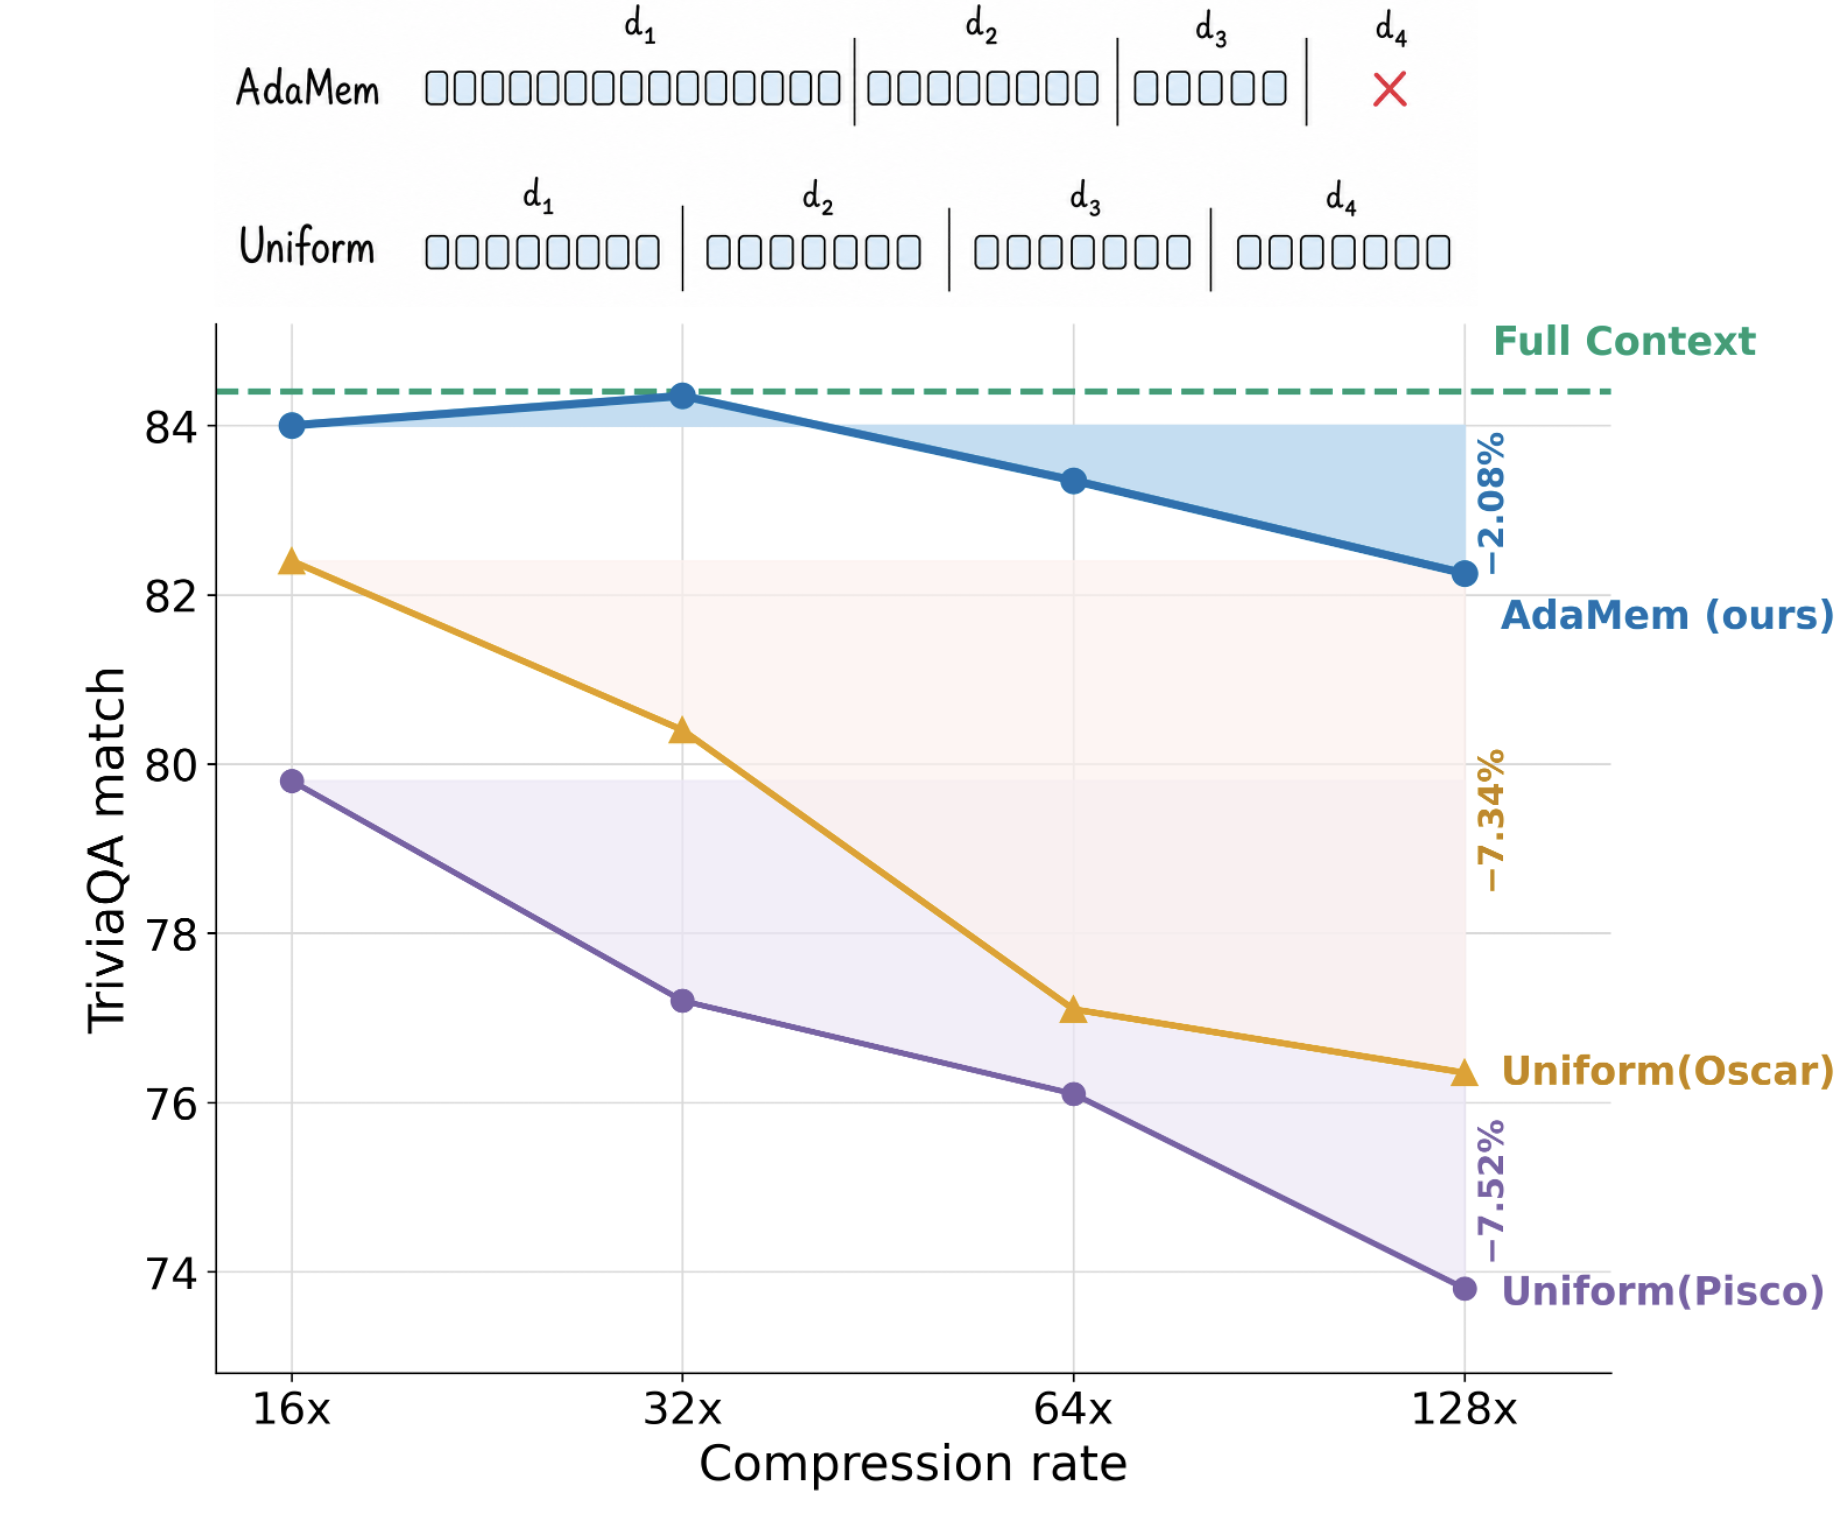
Систему с поиском по внешним документам научили тратить контекст прежде всего на фрагменты, которые помогают ответить на конкретный запрос. В нерецензированном препринте, где все числа получили сами авторы, AdaMem обошла равномерное распределение памяти в среднем на 14,6% при самом жёстком режиме сжатия. Это позволяет расширять поиск по документам, не увеличивая контекст генератора вслед за числом найденных фрагментов.
Как релевантность превращается в бюджет памяти
В RAG языковая модель получает запрос и найденные во внешней базе документы. Чем больше документов передаёт поиск, тем дороже генерация и тем выше риск, что второстепенные фрагменты отвлекут модель от ответа.
Мягкое сжатие (soft compression) заменяет исходный текст короткой последовательностью непрерывных векторов. Декодер читает их как токены памяти: они не содержат доступного человеку текста, но сохраняют информацию, нужную для ответа.
Близкий метод OSCAR уже оценивал релевантность документов, однако использовал эту оценку только для сортировки и отбора. Каждый оставшийся документ получал одинаковую долю памяти независимо от того, содержал ли он прямой ответ или лишь дополнительный контекст.
AdaMem меняет именно это место. Общий компрессор за один проход строит векторы документа и выставляет ему оценку с учётом запроса. Затем система нормирует оценки и делит фиксированный общий бюджет: полезные документы получают больше токенов памяти, второстепенные — меньше, а фрагменты с нулевой долей исключаются.
Дробные доли переводятся в целое число токенов детерминированно, поэтому итоговый контекст всегда укладывается в заданный бюджет. Параметр температуры управляет концентрацией: высокое значение приближает распределение к равномерному, низкое направляет почти всю память в верхние документы.
Для каждого запроса система обрабатывала пул из 25 найденных фрагментов. Пару «запрос — документ» обрезали до 128 токенов ещё до компрессии, поэтому метод распределяет ограниченную ёмкость между короткими представлениями, а не сжимает произвольные документы целиком.
Преимущество растёт вместе с дефицитом контекста
Метод проверили на шести англоязычных наборах вопросов и ответов: TriviaQA, HotpotQA, Natural Questions, PopQA, ASQA и BioASQ. Основной показатель — совпадение подстроки: правильным считают ответ, в котором встречается эталонная формулировка.
При 16-кратном сжатии AdaMem превзошла OSCAR в среднем на 3,4%. При 64-кратном сжатии разрыв вырос, а на PopQA преимущество достигло 19,7%. Равномерное распределение быстрее теряло качество, когда каждому документу переставало хватать памяти.
Сравнение с OSCAR изолирует эффект самого распределения: методы использовали общий компрессор, одинаковые этапы обучения, данные и бюджет. AdaMem не получила дополнительный контекст — она иначе поделила тот же объём между найденными фрагментами.
Результат объясняет поведение системы при глубоком поиске. Дополнительные документы помогают только тогда, когда модель может сохранить подробное представление главных свидетельств и оставить второстепенным минимальную долю. При равномерной схеме каждый новый фрагмент отнимает одинаковую часть контекста у более полезных документов.
Когда AdaMem меняет архитектурный план
Работа касается команд, которые управляют собственной связкой компрессора и генератора. Токены памяти нельзя передать произвольной модели через обычный текстовый API: декодер должен принимать непрерывные представления и быть адаптирован к ним.
Обучение тоже нельзя свести к установке новой формулы поверх готового ранжировщика. Сначала компрессор учат кодировать текст в пригодные для декодера представления, затем адаптируют к запросам и найденным документам, а в конце совместно настраивают генерацию, оценку релевантности и распределение бюджета. Оценки релевантности переносят с отдельной модели, которая сопоставляет запрос и документ.
Для собственной RAG-платформы вывод практический: если стоимость создаёт длинный контекст, а поиск возвращает смесь прямых свидетельств и фоновых документов, стоит сравнивать не только способы отбора. Распределение ёмкости после отбора может дать больший запас для сокращения контекста, чем ещё один порог удаления документов.
На TriviaQA система при 32-кратном сжатии сравнялась по качеству с передачей полного контекста и работала вчетверо быстрее. Это результат одного экспериментального контура, а не готовая оценка задержки для другой модели, оборудования или корпуса.
Работу проверяли на открытых вопросах и ответах, фиксированном поисковом пуле и одной паре компрессора с декодером. Поэтому она обосновывает прототип для подобных RAG-систем, но не заменяет замеры на документах продукта: выигрыш зависит от того, насколько найденные фрагменты различаются по полезности и насколько тесен бюджет контекста.
Источники
Иллюстрация: рисунок из статьи «AdaMem: Adaptive Memory Token Allocation for Soft Compression in Retrieval-Augmented Generation», Artem Sakhno, Grigorii Davydenko, Omar Zoloev и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


