
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
После дообучения отдельные ответы модели могут стать точнее, а голосование по множеству ответов — хуже. Jonathan Williams, Esin Tureci и Karthik R. Narasimhan из Princeton University показали этот эффект на моделях Qwen и Llama, хотя препринт не рецензирован и все числа получили сами авторы. Если продукт выбирает самый частый ответ из нескольких попыток, бюджет обучения стоит распределять между адаптерами, а не вкладывать целиком в один.
Почему точные ответы складываются в плохое решение
Авторы изучали сочетание двух распространённых приёмов. Первый — обучение с подкреплением по проверяемой награде, RLVR: модель получает награду, когда её итоговый ответ проходит автоматическую проверку. Второй — голосование большинства: система генерирует несколько решений и возвращает ответ, который встречается чаще других.
Обычная схема выглядит логично: сначала один LoRA-адаптер обучают на всём доступном бюджете, затем через него получают много ответов. LoRA-адаптер хранит небольшую обучаемую добавку к замороженной модели, поэтому не требует менять все её параметры.
Проблема возникает из-за одинаковых ошибок. Голосование помогает только тогда, когда неверные ответы расходятся: несколько независимых попыток могут компенсировать неудачную. RLVR сужает распределение ответов, поэтому модель чаще повторяет не только верное рассуждение, но и один и тот же сбой.
В эксперименте сравнили полностью обученный адаптер с «зарослью» адаптеров. Данные делили на непересекающиеся случайные части, на каждой обучали отдельный LoRA-адаптер, а затем объединяли их ответы. Суммарные данные и вычисления при обучении оставались прежними; на каждую задачу все варианты генерировали один и тот же пул из 160 ответов.
Чтобы отделить пользу нескольких адаптеров от простой пользы ранней остановки, в сравнение добавили один адаптер, остановленный после такого же числа шагов, сколько получал участник группы. Важность разнообразия измеряли через связь между ошибками: чем чаще два участника ошибаются на одних и тех же задачах, тем меньше голосование может исправить.
Распределённый бюджет сохранил разнообразие
Полное обучение одного адаптера повысило точность отдельного ответа на каждой модели. Но на большинстве моделей итог голосования оказался хуже, чем у исходной модели без RLVR: максимальный проигрыш составил 4,8 процентного пункта.
Эффект накапливался во время обучения. Точность отдельных ответов в целом росла, ошибки становились всё более связанными, а качество голосования достигало максимума рано и затем падало вплоть до 7 процентных пунктов. Поэтому контроль только по точности одного ответа скрывает ухудшение всей системы.
Группы адаптеров обошли полностью обученный одиночный адаптер во всех 16 сочетаниях модели и размера группы. Начиная с четырёх участников, их результат оставался не дальше 0,8 процентного пункта от исходной модели либо превосходил её. Полнота пула — наличие хотя бы одного правильного решения среди всех попыток — также была выше во всех сравнениях с полностью обученным адаптером.
Ранняя остановка одного адаптера оказалась сильной альтернативой для небольших групп. Когда участников становилось больше, распределённое обучение чаще сохраняло прирост точности отдельного ответа и одновременно оставляло ошибки менее похожими. Разделять данные по предметным темам не потребовалось: случайные непересекающиеся части работали не хуже.
Когда архитектуру обучения стоит менять
Работа меняет планы только для систем, которые действительно генерируют несколько решений и агрегируют их голосованием. Если продукт возвращает одну генерацию, полностью обученный адаптер остаётся разумным вариантом: в опытах точность одного ответа после RLVR выросла на всех моделях.
Для голосующей системы метрика обучения должна совпадать с тем, что получает пользователь. Вместо одной только точности отдельной генерации стоит отслеживать качество итогового голосования и то, насколько совпадают ошибки разных ответов. Иначе команда может выбрать позднюю контрольную точку, которая лучше выглядит в обычной проверке, но хуже работает в готовом конвейере.
Практический вариант — обучать несколько LoRA-адаптеров на случайных непересекающихся частях данных, сохраняя общий бюджет запусков RLVR. Это не увеличивало число ответов при проверке в эксперименте, но в продукте потребует загружать и обслуживать несколько адаптеров. Альтернатива проще: заранее выбрать раннюю остановку по качеству голосования, хотя тогда часть предусмотренного бюджета обучения останется неиспользованной.
Проверка охватила три Qwen2.5-Instruct и Llama-3.1-8B-Instruct. Голосование измеряли на пяти математических наборах, где ответы можно привести к сопоставимому виду; задачи на программирование участвовали только в оценке точности одной попытки, полноты пула и связи ошибок. Основные опыты повторяли с тремя начальными состояниями, а сравнение случайного и тематического разделения данных провели с одним.
Из работы не следует, что несколько адаптеров всегда лучше одного. Она показывает более узкую границу: когда итог выбирает большинство, дополнительное обучение одного участника может уничтожить разнообразие, ради которого система вообще генерирует несколько ответов.
Источники
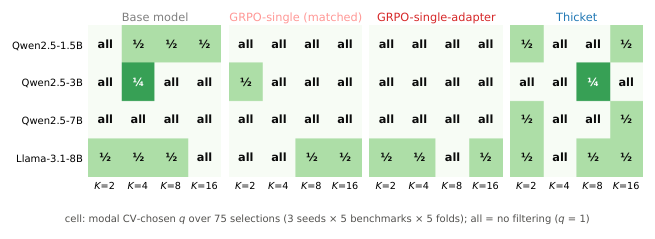
Иллюстрация: рисунок из статьи «Adapter Thickets: Splitting an RLVR Budget Beats Concentrating It», Jonathan Williams, Esin Tureci Karthik R. Narasimhan, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


