
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
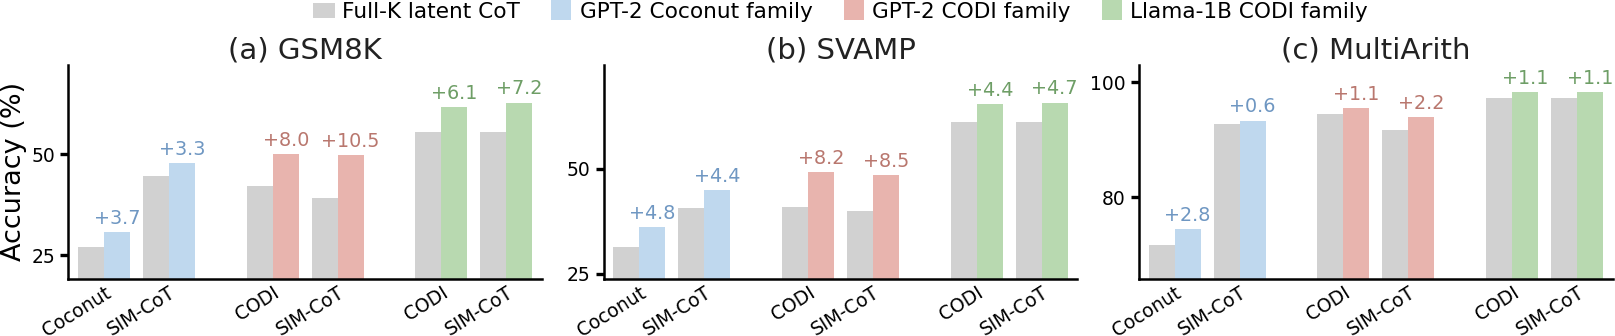
Одинаковое число скрытых шагов для каждой задачи может ухудшить ответ: модель успевает найти верное решение, а затем заменяет его ошибочным. Адаптивная остановка повысила точность до 7,2 процентного пункта в работе National University of Singapore, которая не прошла рецензирование, а числа в ней получили сами авторы. Одновременно метод сократил скрытые вычисления до 29%, поэтому фиксированный бюджет шагов больше не выглядит безопасным значением по умолчанию.
Почему дополнительные шаги стирают правильный ответ
Скрытая цепочка рассуждений (latent CoT) переносит промежуточные вычисления внутри непрерывных представлений модели, а не записывает каждый шаг словами. Обычно такая система выполняет заранее заданное число шагов и только потом формирует ответ.
Работа показывает, что польза от этих шагов распределена неравномерно. Сначала модель продвигает границу рассуждения: создаёт новые промежуточные варианты и приближается к ответу. Затем она преимущественно упорядочивает уже найденные варианты, а на поздней стадии пересматривает их.
Именно пересмотр создаёт проблему. Правильный кандидат может уже занимать первое место, но последующие шаги продолжают перераспределять поддержку между готовыми ответами. В результате верный вариант теряет лидерство, хотя новых полезных промежуточных состояний почти не появляется.
Авторы проверили роль ранней стадии отдельным вмешательством. Они превращали текущее скрытое состояние в один явный токен, добавляли его в контекст и продолжали вычисление. Это задерживало движение к правильному ответу, тогда как сопоставимое по величине возмущение непрерывного состояния сохраняло дальнейший ход рассуждения.
Просто следить за тем, насколько сильно меняется скрытое состояние, недостаточно. Поздний пересмотр тоже создаёт заметные изменения, хотя уже не продвигает границу решения. Уверенность и стабильность ответа дают полезный сигнал, но описывают текущее состояние, а не пользу будущих шагов.
Как оценили оставшийся прогресс
Для каждой глубины авторы оценивают качество ответа, который модель могла бы выдать в этой точке. Лучшее качество среди уже пройденных точек образует текущую границу рассуждения. Конструктивным считается только шаг, который сдвигает эту границу, а не возвращает ранее достигнутый результат после колебаний.
Оставшийся прогресс — разница между текущей границей и лучшим результатом, который траектория достигнет до полного заданного предела. Во время обычного запуска будущее неизвестно, поэтому напрямую вычислить эту величину нельзя.
Для обучения небольшой модели-оценщика сначала полностью выполняют фиксированные траектории. Из каждой промежуточной точки формируют ответ, оценивают его правильность и получают целевой оставшийся прогресс. Оценщик учится предсказывать его по уже пройденной части траектории: краткосрочным изменениям в прогнозах модели и наблюдаемому скрытому состоянию.
Во время работы предсказание сравнивают с заранее зафиксированным распределением для конкретной модели рассуждения. Чем выше оставшийся прогресс относительно этого эталона, тем большую часть доступного бюджета система оставляет. Метод не пытается угадать единственный идеальный момент остановки, а распределяет больше вычислений туда, где они вероятнее дадут новый результат.
Основную LLM дообучать не нужно, но настройка всё же требуется. Команде придётся собрать полные траектории, получить промежуточные ответы, обучить отдельный оценщик и откалибровать правило продолжения для выбранной модели.
Меняет ли работа планы разработчиков
Метод проверяли на обученных вариантах CODI, Coconut и SIM-CoT с основами GPT-2 и Llama-1B. Задачи ограничены арифметическими наборами GSM8K, SVAMP и MultiArith; структуру стадий дополнительно разбирали на ProsQA. Результаты относятся к системам скрытого рассуждения с доступом к внутренним состояниям, а не ко всем приложениям LLM.
Сигнал оставшегося прогресса оказался полезнее перенесённых правил, которые смотрят на вопрос, текущее состояние или уверенность ответа. На связке GPT-2, SIM-CoT и GSM8K при сопоставимом среднем числе шагов точность составила 39,2% против 34,3% у лучших из двух таких правил — разрыв 4,9 процентного пункта.
Для команды, которая уже использует фиксированный предел скрытых шагов, практический вывод состоит не в том, чтобы просто уменьшить его. Один общий короткий предел будет преждевременно обрывать задачи, где граница ещё движется. Нужен контроллер, который оценивает будущую отдачу отдельно для каждой траектории.
Менять архитектуру продукта только по этим результатам рано, если она работает с более крупными моделями или неарифметическими задачами. Но фиксированный предел стоит перестать считать нейтральным параметром: его нужно сравнивать с адаптивной остановкой одновременно по точности и числу выполненных шагов.
Источники
Иллюстрация: рисунок из статьи «Rethinking Fixed-Horizon Latent Reasoning», Tianxiang Chen, Jingyuan Zhou, Weiming Yang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


