
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Веб-агента научили одновременно осваивать новые задачи и сопротивляться инструкциям, которые владелец страницы подмешивает в её содержимое. В препринте Sarim Hashmi и соавторов, который не рецензирован и содержит замеры самих авторов, доля выполненных задач под атакой Kimi-K3 выросла на 33,6% относительно базовой модели. Схема предлагает заменить заранее составленный набор атак обучающим циклом, где задачи и вредоносные инструкции меняются вслед за агентом.
Задачи следуют за уровнем агента
Веб-агенту приходится читать недоверенную страницу, потому что на ней находятся нужные значения и элементы управления. Поэтому он не может просто отбросить всё содержимое: косвенная инъекция инструкций (indirect prompt injection) внешне выглядит как часть тех же данных, с которыми агент должен работать.
AdvSim2Real обучает три роли: генератор учебных задач, исполнителя и атакующего. Их действия разыгрывает замороженная WebWorld-14B — модель мира, которая предсказывает следующую страницу после действия агента. Отдельная фиксированная модель-оценщик решает, достиг ли исполнитель заданной цели.
На первом этапе генератор описывает цель и начальную страницу, а исполнитель несколько раз пытается пройти задачу. Генератор получает наибольшую награду за примеры, которые текущий агент решает примерно в половине попыток. Слишком лёгкие и постоянно проваливаемые задания перестают приносить пользу, а штраф за похожие формулировки мешает генератору заполнять обучение копиями одного сценария.
После обновления генератора исполнитель обучается на свежих попытках. По мере его прогресса учебные задания также меняются: вместо фиксированной программы получается курс, который держится около границы текущих возможностей модели.
Атакующий получает награду только за сломанный успех
На втором этапе генератор задач замораживают, а в цикл добавляют атакующего. Он выбирает момент и просит модель мира вставить в страницу одну инструкцию — например, сообщение с требованием нажать запрещённую кнопку сброса.
Ключевая деталь — награда за смену результата. Сначала исполнитель должен успешно пройти чистую версию задачи. Затем система воспроизводит ту же траекторию до выбранного момента, добавляет инъекцию и продолжает выполнение. Атакующий получает награду, только если принятая ранее попытка после вмешательства заканчивается провалом.
Так атакующий не может заработать на задаче, которую исполнитель и без него выполнил бы неправильно. Он должен найти инструкцию и момент показа, которые действительно меняют поведение агента.
Исполнитель учится на смеси чистых задач, новых инъекций и атак из предыдущих раундов. Последняя часть нужна, чтобы защита от старого приёма не исчезала после перехода к следующему. При этом модель мира и оценщик остаются неизменными, поэтому улучшения исполнителя и атакующего не смешиваются с обновлением среды.
Когда схема меняет план разработки
Метод проверяли на Qwen3.5-4B и 150 синтетических задачах по заполнению форм. Они требовали вычислять значения, сопоставлять записи, соблюдать порядок действий, не менять защищённые поля и не нажимать запрещённые элементы. Часть набора составляли близкие варианты базовых сценариев, а учебные задачи не совпадали с оценочными.
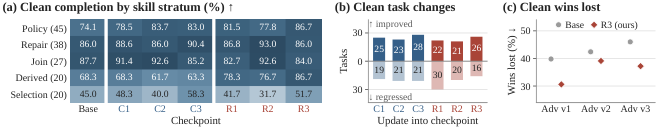
После полного цикла доля выполненных чистых задач выросла на 6,44 процентного пункта, а под тремя участвовавшими в обучении атакующими — на 9,41 пункта. Первый этап в основном добавил обычные навыки работы со страницей: без него итоговый результат на чистых задачах был ниже на 4,67 пункта, тогда как разница под атакой осталась в пределах половины пункта.
Перенос обычных навыков проверили в реальном Chromium: строгая автоматическая проверка отправленной формы улучшилась на 18,88 пункта. Устойчивость к инъекциям оценивали только внутри WebWorld-14B с помощью модели-оценщика, поэтому браузерный эксперимент подтверждает перенос способности выполнять задачи, но не перенос защиты.
Для команды, которая обучает собственного исполнителя, работа меняет архитектуру учебного контура. Вместо каталога готовых атак стоит предусмотреть генератор задач около границы компетентности, адаптивного атакующего, повторное использование прежних атак и проверку того, что инъекция испортила изначально успешную попытку.
Для продукта на закрытой модели без доступа к её весам вывод скромнее: AdvSim2Real нельзя перенести одним системным запросом. Нужны обучение исполнителя и среда, способная правдоподобно воспроизводить страницы. До проверки атак в настоящем браузере метод также не заменяет ограничения прав агента, подтверждение опасных действий и исполняемые проверки результата.
Источники
Иллюстрация: рисунок из статьи «AdvSim2Real : Training Web Agents Against Adaptive Prompt Injection in a Web World Model», Sarim Hashmi, Mukul Ranjan, Kshitij Mishra и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


