
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Кодовую модель научили собирать редактируемые плакаты, слайды и панели по текстовому заданию, не копируя ошибки изображения-референса. Хотя работа не прошла рецензирование и числа получили сами авторы, AesCode-8B улучшила оценку визуального качества на 31,1 процентного пункта относительно исходной Qwen3-VL-8B. Для команд, которые обучают генераторы интерфейсов и документов, работа предлагает практичную схему: проверять код правилами, а субъективные свойства — отдельной моделью-оценщиком.
Как разделили содержание и визуальный замысел
Изображение хорошо передаёт композицию, но может исказить текст, числа или связи между элементами. Код сохраняет структуру и позволяет проверить результат, однако модель пишет его построчно и не всегда понимает, как вся страница выглядит после отрисовки.
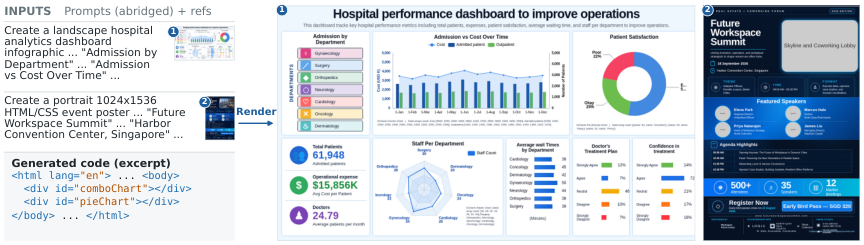
AesCode получает текстовое задание и созданное по нему изображение. Задание остаётся источником требований к содержанию, а изображение подсказывает расположение блоков, интервалы и оформление. Модель не должна воспроизводить референс по пикселям: допустим любой вариант, который передаёт нужные сведения и использует визуальные идеи исходного изображения.
Команда Xin Gao представила цель как граф дизайна. Его узлы обозначают текст, таблицы, диаграммы, карточки и контейнеры, а связи задают вложенность, порядок, выравнивание и соседство. У каждого узла отдельно хранятся содержание, геометрия и оформление, поэтому ошибочный текст из референса можно отбросить, не теряя удачную композицию.
Из сгенерированного HTML/CSS система извлекает дерево элементов, стили, распознанный текст и координаты после отрисовки. Так один и тот же объект можно проверить по коду и по тому, что действительно оказалось на холсте.
Что отдали правилам, а что — модели-оценщику
Шесть детерминированных проверок отвечают за свойства, которые можно вычислить однозначно. Они проверяют, запускается ли код, присутствует ли требуемый текст, не выходят ли элементы за границы, правильно ли устроены таблицы и диаграммы, совпадает ли расположение смысловых блоков с референсом и как распределено пустое пространство.
Проверка таблиц и диаграмм смотрит не только на картинку. Таблица должна оставаться HTML-структурой, а диаграмма — рабочим объектом ECharts с нужными рядами данных. Статическая имитация не получает ту же награду, даже если визуально похожа на требуемый элемент.
Оформление, иерархию и сложные пространственные связи оценивает визуально-языковая модель VLM. Вместо общей просьбы выставить балл система строит для каждого примера список вопросов с ответом «да» или «нет»: выровнены ли конкретные блоки, читается ли заголовок как главный, сохранена ли связь между элементами. Вопросы привязаны к узлам и связям графа, поэтому неудачную часть макета можно локализовать.
Всего обучение использует семь каналов награды. GDPO нормализует каждый канал отдельно внутри группы вариантов и только затем объединяет сигналы. Благодаря этому частая и почти всегда успешная проверка текста не перекрывает редкую награду за удачную композицию, как это может происходить при сложении всех оценок до нормализации.
Когда схема меняет план разработки
При одинаковых референсах AesCode-8B обошла свою основу по визуальной оценке на 31,1 процентного пункта, а AesCode-32B — на 22,4. Обе версии приблизились по внешнему виду к GPT-5.5 и Claude Opus 4.8, одновременно лучше выполняя формально проверяемые требования.
Раздельная нормализация тоже повлияла на результат: GDPO добавила 5,12 пункта визуальной оценки относительно GRPO, где награды сначала сводятся вместе. В проверке автоматических критериев людьми совпадение достигло 93,3%, поэтому результат нельзя объяснить только предпочтениями одной модели-оценщика.
Работу проверяли на генерации информационно насыщенных страниц в HTML/CSS: плакатов, слайдов, панелей и веб-страниц. Основной тест включал 300 заданий с референсами от GPT-Image-2; моделями-основами служили Qwen3-VL-8B и Qwen3-VL-32B. Это подтверждает подход для статичных визуальных материалов, но не для интерактивных приложений с переходами, состояниями и пользовательскими сценариями.
Команде, которая обучает собственную модель, стоит пересмотреть единый итоговый балл. Содержание, исполняемость и структуру лучше проверять кодом, а визуальную часть разбивать на короткие критерии для VLM; затем каждый тип награды нужно нормализовать отдельно. Такая архитектура также упрощает диагностику: падение проверки таблицы указывает на данные или разметку, а провал визуального критерия — на композицию.
Если команда только вызывает готовую модель через API, AesCode не требует немедленно менять стек. Полезнее сначала добавить изображение-референс и независимые проверки результата: в работе референсы помогли всем протестированным моделям, но величина выигрыша различалась. Сам граф дизайна и обучение с несколькими наградами становятся оправданными, когда есть собственный контур дообучения и достаточно примеров для автоматической проверки.
Источники
Иллюстрация: рисунок из статьи «AesCode: Aesthetic Code Generation with Decoupled Cross-Modal Rewards», Xin Gao, Yifan Yang, Xin Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


