
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Для классификации новостных тем на африканских языках простой модели обычно хватает нескольких сотен размеченных текстов, тогда как анализ тональности продолжает выигрывать от тысяч. В препринте, который не прошёл рецензирование и приводит числа, полученные самими авторами, данные других языков помогают при десятках примеров, но перестают помогать при сотнях. Это позволяет разделить запуск на дешёвую проверку гипотезы с общей выборкой и последующее обучение на нужном языке.
Как построили кривые обучения
Работа University of Missouri, Government Degree College и Amar Bio Tech охватывает классификацию новостей на 16 языках из MasakhaNEWS и анализ тональности на 12 языках из AfriSenti. Для новостей модель определяла тему статьи, для сообщений из социальных сетей — положительную, отрицательную или нейтральную тональность.
Авторы использовали один и тот же конвейер для всех языков: символьные n-граммы с весами TF-IDF и линейный метод опорных векторов. Модель ищет короткие последовательности символов, поэтому не требует отдельного токенизатора для латиницы, арабского письма и письма геэз. Предобученных весов и GPU в эксперименте нет; обучение запускали на двух ядрах CPU.
Для каждого языка строили кривую обучения от небольшой размеченной выборки до всего доступного набора. Качество измеряли через макро-F1 — среднее качество по классам, при котором частые темы или оценки не скрывают ошибки на редких.
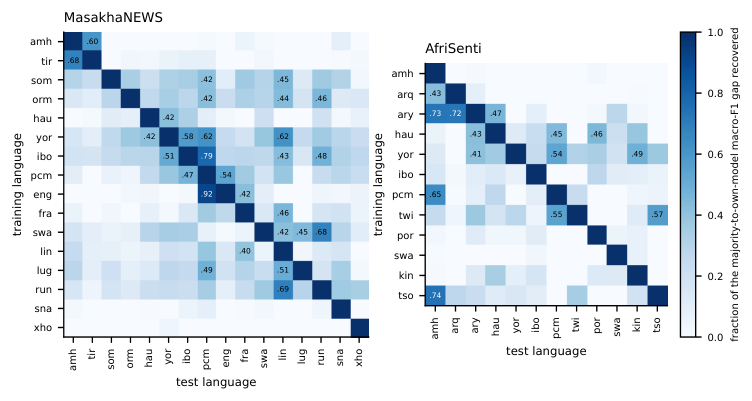
Сравнивали три режима. В первом модель видела только тексты нужного языка. Во втором к ним добавляли полные обучающие выборки остальных языков с той же задачей, без языковых меток и выравнивания весов. В третьем модель обучалась на другом языке и не получала ни одного размеченного текста целевого языка. Проверку проводили на официальных тестовых частях обоих наборов.
Чужие языки заменяют разметку лишь на старте
На новостях модель достигает примерно 90% своего качества на полной выборке после 400 размеченных текстов в медианном языке. Дальше кривая растёт медленнее, хотя отдельным языкам требуется вся доступная выборка. Для первичной оценки тематического классификатора бюджет в несколько сотен примеров поэтому полезнее, чем немедленный сбор максимально большого корпуса.
При 25 текстах нужного языка объединённая выборка добавляет новостной модели в среднем 0,20 пункта макро-F1. Другие языки в этот момент задают хотя бы приблизительную границу между темами, которую маленькая местная выборка ещё не позволяет найти.
К 800 размеченным текстам средний выигрыш исчезает. На полной выборке добавление других языков уже снижает качество для большинства языков в обеих задачах. Общая модель вынуждена использовать одну границу для похожих сочетаний символов, хотя их связь с темами и тональностью меняется от языка к языку.
Для анализа тональности кривая выглядит хуже: почти везде она продолжает расти на всей доступной выборке. Короткие сообщения содержат больше шума, переключений между языками и неявных оценок, поэтому простой модели нужны уже тысячи примеров. Объединение языков даёт небольшой стартовый выигрыш, но не отменяет сбор местной разметки.
Как это меняет план разработки
Для новостной рубрикации разумный первый этап — разметить несколько десятков текстов на нужном языке и добавить корпуса других языков с точно такой же схемой классов. Такой прототип быстро покажет, различимы ли темы и не расходится ли фактическое содержание классов между странами и редакциями.
После нескольких сотен местных примеров общую выборку стоит сравнить с моделью, обученной только на целевом языке. Оставлять данные других языков по умолчанию не следует: ранний выигрыш превращается в нейтральный результат, а затем может снизить точность. При этом обучение остаётся достаточно дешёвым, чтобы проверить оба варианта на обычном компьютере.
Полностью отказаться от местной разметки обычно не получится. Перенос без примеров целевого языка восстанавливает медианно лишь 13% разрыва между простым выбором самого частого класса и моделью для нужного языка на новостях; для тональности — 4%. Сильные исключения связаны не с принадлежностью к одной языковой семье, а с общим письмом, словарём, именами собственными или похожим распределением классов.
Практический план зависит от задачи. Для новостных тем можно заложить короткий цикл разметки и остановиться, когда кривая качества выровняется. Для тональности следует заранее планировать тысячи примеров и рассматривать предобученную языковую модель, если качество простого классификатора не достигает требований продукта.
Эти бюджеты относятся к одной модели на символьных признаках и двум публичным наборам. Они дают базовую оценку для систем без GPU, но не определяют объём разметки для генеративных моделей, других предметных областей или иной схемы классов.
Источники
Иллюстрация: рисунок из статьи «How Many Labels Does a Language Need? Annotation Budgets and Cross-Lingual Pooling for African-Language Text Classification», Bhanu Prakash Vangala, Sowmya Guda, Navya Vangala, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


