
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Точную вычислимую операцию выгоднее оставить обычному коду, а не поручать LLM или агенту с инструментами. Хотя работу ещё не рецензировали и числа получили сами авторы, сравнение показывает устойчивый разрыв: обычные функции и сервисы одновременно точнее и быстрее моделей. Для архитектуры продукта это аргумент разделять языковое рассуждение и исполнение, а не проводить весь процесс через агента.
Как отделили вычисление от способа вызова
Для сравнения выбрали 1000 арифметических выражений из SVAMP. В каждом нужно было сохранить порядок операций и вернуть точное число: такая задача легко проверяется и позволяет отдельно увидеть ошибки вычисления и накладные расходы архитектуры.
Одни и те же выражения обрабатывали несколькими способами. Эталоном служил локальный вызов eval() в Python. Затем вычисление разложили на операции и вызывали их через локальные сервисы REST, SOAP и MCP. В других конфигурациях ответ генерировали пять локальных моделей через Ollama и одна удалённая модель через Groq.
В агентном варианте локальная LLM получала MCP-инструменты для сложения, вычитания, умножения и деления. Она должна была выбрать нужную операцию, передать аргументы, принять результат и решить, какой инструмент вызвать дальше. Поэтому тест проверял не только арифметику, но и способность модели соблюдать протокол работы с инструментами.
Для LLM использовали единый запрос с требованием вернуть только число и проверили два режима температуры. Ответ с пояснением считался ошибкой формата, даже если содержал правильный результат. Агент также мог исчерпать лимит шагов, не завершив вычисление.
Все локальные конфигурации запускали на одном компьютере, а Groq работал удалённо. Сравнивали точность, полное время выполнения, затраченное процессорное время или токены API и объём кода. Названная в работе «стоимость» для локальных запусков измеряется временем процессора, а не деньгами, поэтому по этим данным нельзя напрямую рассчитать счёт за инфраструктуру.
Границы эксперимента узкие: фиксированный запрос, арифметические выражения, небольшой набор моделей и локальные микросервисы. Тест хорошо показывает цену ненужного вероятностного шага в точной операции, но не измеряет процессы, где агенту приходится разбирать документы, вести диалог или выбирать действие по неполному описанию.
Инструменты вернули точность, но не эффективность
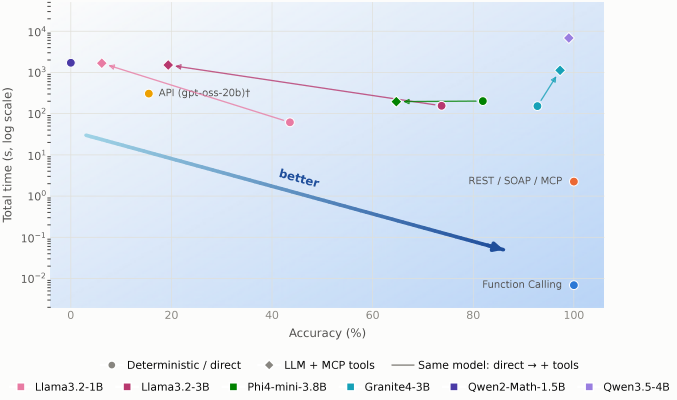
Локальная функция, REST, SOAP и MCP дали точность 100%. Значит, сам переход к сервису не повредил результат: порядок операций сохранял детерминированный код, а протокол влиял в основном на задержку.
При прямом ответе лучший результат LLM составил 92,9%, причём модель работала более чем в 22 000 раз медленнее локальной функции. Смена температуры почти не влияла на итог: более повторяемая генерация не превращала вероятностную модель в точный вычислитель.
Лучший агент с MCP достиг 99,9%, но приблизился к задержке в миллион локальных вызовов функции. Он вернул почти всю точность лишь потому, что передал арифметику детерминированным инструментам, добавив перед каждым действием генерацию и выбор следующего шага.
Наличие инструментов само по себе не гарантировало улучшения. Слабые модели использовали их неправильно, отвечали текстом или продолжали считать самостоятельно. Qwen2-Math, обученная для математических задач, не смогла выполнить требование о формате: её ответы не проходили проверку как отдельные числа. Phi4-mini поддерживала вызов инструментов, но в этом тесте ими не пользовалась.
Планы стоит менять на границе между языком и исполнением
Если процедура известна и должна давать точный результат, агент не нужен. Внутри одного процесса подходит обычная функция. REST оправдан, когда вычисление нужно вынести в отдельный сервис, SOAP — когда требуется формальный контракт, а MCP — когда тот же инструмент должны находить и вызывать LLM-агенты.
LLM стоит оставить ту часть процесса, для которой нельзя заранее записать однозначный алгоритм: разобрать свободный текст, сопоставить намерение с доступными действиями или собрать недостающие параметры. После выбора действия управление лучше передать коду, который проверяет типы, права, допустимые значения и порядок операций.
Цена ошибки считается от бизнес-последствий, а не только от средней точности. Долю неверных ответов нужно перевести в ожидаемое число сбоев при рабочем объёме и умножить на стоимость ручной проверки, отката или неправильной операции. Если ошибка недопустима, результат модели следует проверять детерминированным правилом либо не давать модели выполнять эту часть процесса.
Задержку нужно считать по всей цепочке. Агент может вызвать несколько инструментов, а между вызовами снова запустить генерацию; время отдельного MCP-запроса тогда перестаёт быть главным фактором. Для интерактивного продукта важна задержка полного сценария, а для фоновой автоматизации — пропускная способность и занятые вычислительные ресурсы.
Работа не доказывает, что агентные системы всегда невыгодны. Она показывает более практичную границу: агент оправдан там, где его способность понимать язык и выбирать действие окупает ошибки и задержку. Использовать его как дорогую оболочку над заранее известной функцией оснований нет.
Источники
Иллюстрация: рисунок из статьи «Doing Less with More: A First-Principles Exploration of the Suitability of Agentic Computing over Alternative Architectural Choices», Ritvik Garimella, Biplav Srivastava, Amit Sheth, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


