
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Подробные сведения о задаче повлияли на результат ИИ-агента сильнее, чем выбор базовой LLM и запас времени. В работе Luis Wiedmann, Leander Girrbach, Cordelia Schmid и Zeynep Akata повторный запуск той же конфигурации объяснил 54% разброса результатов. Поскольку препринт не проходил рецензирование, все числа в нём получили сами авторы; для продуктовых команд главный вывод состоит в том, что сравнивать нужно агентные системы целиком, а не модели по отдельности.
Агенту поручили самостоятельно выбрать и запустить научную модель
Авторы собрали четыре задачи из астрофизики и геномики. Агенту требовалось найти подходящую специализированную модель, подготовить данные, написать код и получить результат, сопоставимый с результатом исходной научной работы.
Задачи проверяли разные части процесса. В одной нужно было подготовить изображения галактик для AstroCLIP, в другой — дообучить DNABERT-2 для классификации участков ДНК. RiNALMo требовала правильно обработать предсказанные связи в РНК, а в задаче по астрономии агенту следовало отказаться от AstroSage-8B, поскольку базовая LLM справлялась лучше.
Специализированные модели, их веса и готовые программные окружения лежали в изолированной среде. Прямого инструмента для их запуска не было: агент читал документацию, работал с файлами, выполнял команды и сам писал связующий код. Такой стенд проверяет не знание ответа, а способность собрать рабочий процесс из доступных компонентов.
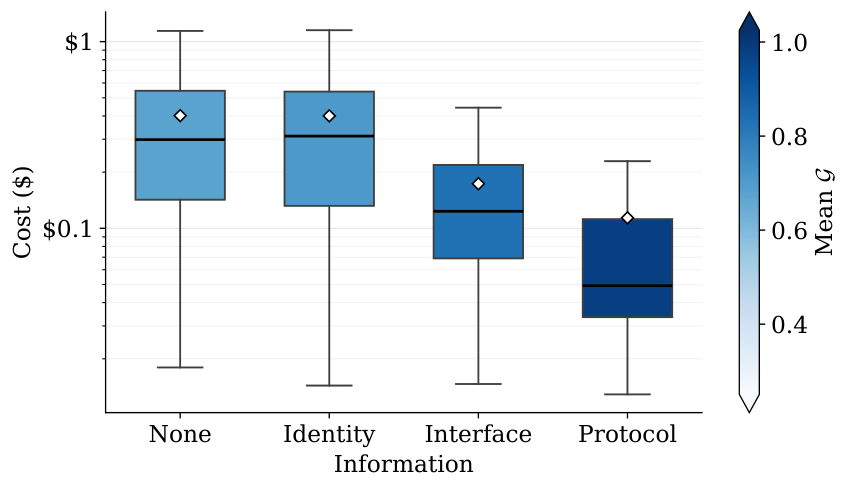
В конфигурации меняли сведения о задаче, сохранение рассуждений между шагами, требование проверить ответ, запас времени и базовую LLM. Информация поступала ступенчато: от одного описания задачи до названия нужной модели, её программного интерфейса и полного протокола работы. Запуски ограничивали промежутком от 5 до 20 минут, а каждую конфигурацию повторяли пять раз.
Основная метрика показывала, какую долю разрыва между самостоятельным ответом LLM и результатом специализированной модели закрыл агент. Отдельно учитывали, завершил ли он работу, превзошёл ли тривиальный ответ, сколько ресурсов потратил и насколько точно оценил собственный результат.
Информация заняла первое место среди настроек
Описание модели, её интерфейса и протокола дало больший эффект, чем увеличение времени или размера базовой LLM. Полный протокол не только улучшал итоговый результат: с ним агент раньше переходил к полезным действиям, тратил меньше времени и токенов и точнее оценивал качество ответа.
Дополнительное время само по себе не гарантировало улучшения. Оно помогало, когда агент уже располагал достаточной информацией или мог использовать её с помощью подходящей LLM. При слабой исходной конфигурации длинный запуск позволял дольше развивать ошибочный подход и иногда ухудшал результат.
Повторные запуски показали, почему одного прогона недостаточно для выбора архитектуры. Даже среди попыток, которые превзошли тривиальный ответ, больше половины разброса приходилось не на настройки, а на случайность нового запуска. При этом удачные конфигурации давали более стабильные результаты, чем слабые.
Задача mmlu-astronomy показала ещё одну роль системной конфигурации. Базовая LLM получила точность 0,967, а специализированная AstroSage-8B — 0,671. Рабочий агент должен был не просто найти доступную модель, а определить, что применять её невыгодно.
Просьба проверить ответ почти не меняла фактическое поведение агента. Отдельный инструмент проверки менял его заметнее: агент чаще сопоставлял промежуточный результат с эталоном и исправлял решение. Это различие относится именно к поведению проверки и не означает, что любой дополнительный инструмент автоматически повышает качество.
Командам стоит пересматривать стенд, а не сразу менять LLM
Работа меняет порядок оптимизации агентной системы. Перед заменой модели стоит проверить, получает ли агент название нужного компонента, понятный способ его вызвать, формат данных и последовательность действий. Для узких процессов такой пакет сведений может дать больший эффект, чем переход на более крупную LLM.
Проверку лучше закреплять в архитектуре: предоставить исполняемый тест, валидатор результата или специализированный инструмент. Формулировка в системной инструкции остаётся пожеланием, тогда как инструмент создаёт отдельное действие с наблюдаемым результатом.
Запас времени также нужно настраивать вместе с информацией и моделью. Практический стенд должен сравнивать не только долю успешных задач, но и повторяемость, завершение в срок, стоимость запуска и точность самооценки. Каждую перспективную конфигурацию следует прогонять несколько раз, иначе случайно удачный запуск легко принять за преимущество архитектуры.
Проверка охватывает научные процессы с четырьмя задачами из двух областей, где агент работает со специализированными моделями. В эксперимент не входили долговременная память и координация нескольких агентов, а вывод о преимуществе системного инструмента над инструкцией проверяли только на самопроверке. Поэтому результаты задают полезный порядок инженерных экспериментов, но не универсальный рейтинг настроек для любого продукта.
Источники
Иллюстрация: рисунок из статьи «Agents Are Systems, Not Models: Rethinking Agentic Evaluation», Luis Wiedmann, Leander Girrbach, Cordelia Schmid и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


