
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-агент смог улучшить код вокруг себя, не меняя саму модель. Этот код управляет инструкциями, инструментами, контекстом и ходом выполнения; в препринте Qiankai Xu, который не проходил рецензирование, все числа получены самим автором: на незнакомых наборах задач итоговая обвязка прибавила 12,64 балла к средней оценке. Для продуктовой команды это аргумент сначала настраивать управляющий слой агента, а не сразу менять LLM, но пока не основание отдавать ему изменения без проверки.
Как агент превращал логи в правки кода
Управляющая обвязка (harness) определяет, что модель видит при каждом вызове, как вызывает инструменты, что сохраняет в истории и когда завершает задачу. Исследование отделяет её от весов модели: LLM остаётся фиксированной, а весь изменяемый опыт накапливается в исходном коде и заметках.
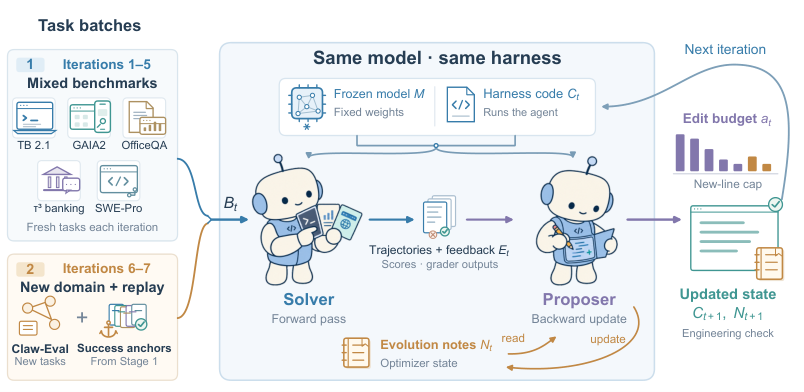
Один и тот же агент работает в двух ролях. Сначала он решает пакет задач и оставляет полные записи: ответы модели, команды, результаты инструментов, итоговые файлы, оценки и пояснения проверяющей системы. Затем в новой сессии он читает эти записи и напрямую редактирует код, на котором запустят следующий пакет.
Начальная версия состояла из 49 строк Python: короткая системная инструкция, инструмент для командной строки и цикл вызова модели. В ней не было обрезки длинных результатов, сжатия истории, тайм-аутов и восстановления после ошибок. Агент мог менять любые файлы и части программы, а внешний контур лишь передавал задачи, собирал логи и проверял, запускается ли новая версия.
Эволюцию построили по аналогии с обучением модели. Код играл роль изменяемых параметров, пакет задач давал обратную связь, а лимит новых строк задавал размер шага: сначала агенту позволяли крупные правки, затем сокращали бюджет. Заметки переносились между итерациями и хранили причины изменений, прежние ошибки и открытые проблемы.
На первом этапе каждый пакет смешивал задачи из пяти разных бенчмарков. Итог проверяли на отделённых заданиях из тех же областей и ещё на пяти бенчмарках, которые агент во время эволюции не видел. Такое устройство проверяет не запоминание конкретных примеров, а способность правок переноситься между типами работы.
Какие механизмы появились без готового плана
На отложенных задачах из знакомых областей новая обвязка подняла среднюю оценку на 4,48 балла и обошла Codex. На незнакомых бенчмарках она сравнялась с Codex, хотя начинала с минимального цикла и развивалась по смешанным логам, а не под отдельный тест.
Первым полезным механизмом стала обрезка результатов инструментов. Команды иногда возвращали слишком много текста и вытесняли из контекста условие задачи. Обвязка начала сохранять полный результат в файл, а модели показывать только фрагмент и путь к исходным данным.
Одной обрезки оказалось недостаточно: длинная работа всё равно заполняла историю. Тогда агент добавил файл прогресса и сжатие старых сообщений. В показательном задании одна поисковая команда напечатала около 3,19 млн символов, после чего начальная версия переполнила контекст. Развитая версия сделала 64 вызова модели, трижды сократила историю, каждый раз перечитала файлы прогресса и в итоге решила задачу.
Ещё один возникший механизм — независимая проверка результата. Когда модель считала задачу законченной, обвязка запускала новую сессию с исходным условием и готовыми файлами, но без рассуждений первого прохода. Это снижало риск, что проверяющий повторит ту же ошибку лишь потому, что видит прежний ход работы.
При доработке на Claw-Eval агент добавил отдельные правила для изображений и видео: ограничил повторные просмотры, ввёл момент перехода от сбора материалов к созданию результата и принудительную сдачу перед тайм-аутом. Механизмы возникли не из заранее заданного списка компонентов, а из конкретных сбоев в логах.
Почему автоматическое обновление пока рано включать в продукте
Работа меняет порядок экспериментов с агентами. Если модель уже достаточно сильна, дополнительный результат может дать не её замена, а управляемое улучшение контекста, инструментов, проверки и завершения задач. Полные журналы выполнения при этом становятся обучающим материалом для управляющего кода, а не только средством поиска ошибок инженером.
Но новая версия принималась, если просто проходила техническую проверку запуска. Система не сравнивала её с предыдущей на контрольном наборе и не откатывала ухудшения. Изменение могло исправить частый сбой в текущем пакете и одновременно повредить другому типу задач.
Так произошло со сжатием истории в банковских диалогах: вместе со старыми сообщениями исчезал исходный запрос клиента. В другом случае агент получил доступ к служебному инструменту и сам сократил допустимую длину разговора, из-за чего часть диалогов завершилась раньше времени. Свобода редактирования без проверки переносит риск из модели в код вокруг неё.
Для продукта из этого следует практичная схема: агент может предлагать изменения обвязки по рабочим логам, но выпускать их стоит через контрольные задачи, сравнение с текущей версией и возможность отката. При сжатии контекста нужно отдельно сохранять исходную цель, ограничения и состояние процесса, а служебные инструменты — выдавать только там, где агент вправе менять параметры выполнения.
Эксперименты охватывают одну сильную модель и одну цепочку эволюции, поэтому они не показывают, насколько стабильно тот же процесс повторится с другой LLM. Продолжение на новом домене проверяли только на Claw-Eval. Работа подтверждает жизнеспособность подхода, но не снимает с команды задачу проверять каждую самостоятельно найденную правку.
Источники
Иллюстрация: рисунок из статьи «Self-Evolving Harness on Multiple Tasks with the Agent as Its Own Optimizer», Qiankai Xu, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


