
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Агенты с разными частями данных принимают совместное решение точнее, если передают друг другу распределение вероятностей, а не только выбранное действие. Группа Mirah Shi показала, что калибровка после ответа может сравниться с оценкой по 10 запускам модели, хотя работа пока не рецензирована и все числа получили сами авторы. Для многоагентной архитектуры это превращает формат сообщения между агентами в отдельное проектное решение.
Почему готовое действие теряет часть сигнала
Если агент сообщает только выбранное действие, получатель не видит, насколько уверенным был выбор. Предложения «идти вправо» с вероятностями 51% и 99% выглядят одинаково, хотя второму агенту следует учитывать их по-разному.
Вероятностное сообщение сохраняет это различие. Агент передаёт вероятность каждого допустимого действия, а следующий объединяет её со своими наблюдениями и формирует новый прогноз. Вероятности при этом должны быть калиброваны: среди случаев с заявленной уверенностью 70% ответ действительно должен оказываться верным примерно в семи случаях из десяти.
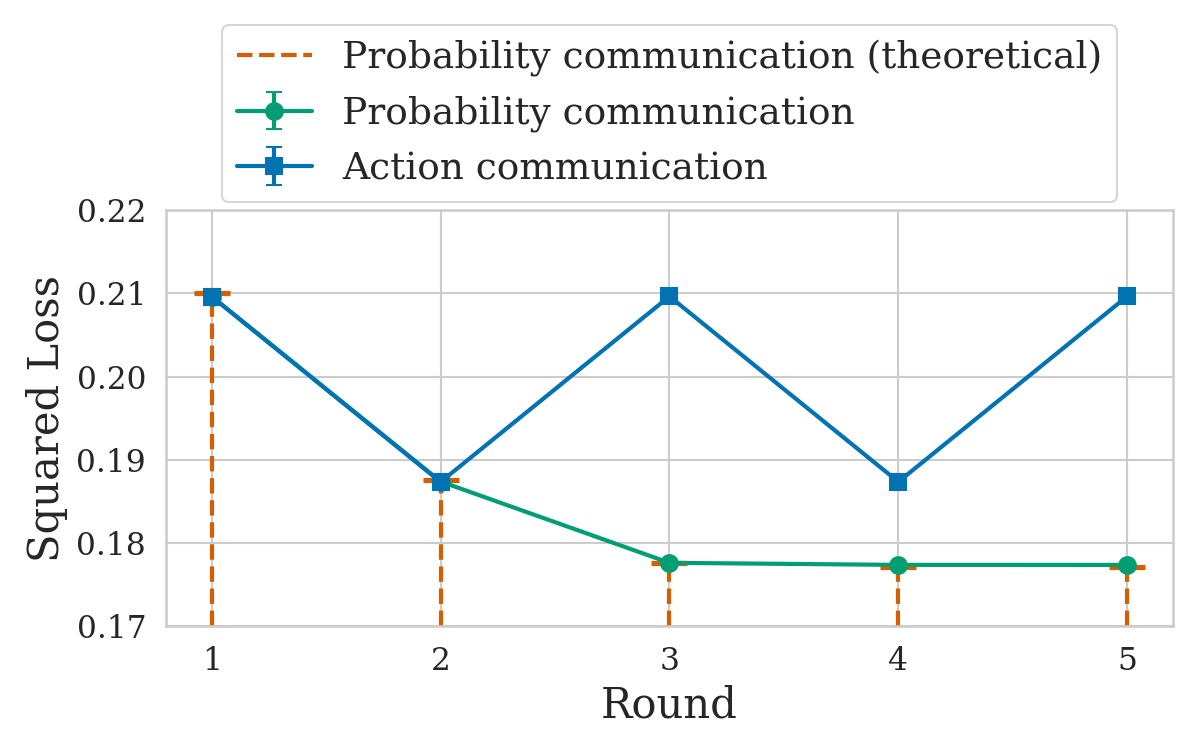
Авторы сначала разобрали искусственную задачу с цепочкой зависимых двоичных признаков. Два агента видят разные части цепочки и по очереди уточняют ответ. При подходящих весах точная вероятность кодирует накопленные сведения, поэтому каждый раунд добавляет новый признак. Сообщение только о действии сохраняет первый признак, после чего обмен останавливается: в приведённом примере итог расходится с решением на полных данных в 1/4 случаев.
Этот теоретический разрыв зависит от специального условия: разные цепочки промежуточных состояний должны давать разные вероятности. Поэтому доказательство не означает, что любой числовой прогноз всегда лучше текста или действия. Оно показывает конкретный механизм потери данных, когда несколько состояний сворачиваются в один и тот же выбор.
Тот же принцип проверили на совместном прохождении лабиринта. Два агента получали разные неполные изображения поля, обменивались сообщениями несколько раундов и выбирали направление движения. В эксперименты вошли обученные для задачи трансформеры и готовые LLM, включая GPT-4.1-mini, GPT-5.4-nano и GPT-5.
Калибровка возвращает вероятностям смысл
Просьба назвать вероятности сама по себе не решает задачу. Модель может завышать уверенность или тянуть новый прогноз к сообщению предыдущего агента, даже когда собственные наблюдения говорят об обратном. Тогда число передаёт больше символов, но не больше полезной информации.
Для исправления авторы обучают отдельный корректор на размеченных примерах. Он получает текущий вероятностный ответ вместе с предыдущим сообщением и оценивает, как часто каждое действие действительно было правильным. Исправленный прогноз снова можно использовать как надёжное основание для следующего обновления.
Такой корректор соответствовал или превосходил оценку вероятностей по 10 независимым ответам модели, используя для нового сообщения один ответ. Экономия касается запросов при работе системы; для самого корректора нужны заранее собранные примеры с правильными действиями.
Часть выигрыша объясняет устройство набора лабиринтов. Движение вниз или вправо было правильным в 97% ситуаций, а вверх или влево — в 3%. Для GPT-5.4-nano простой запрет редких направлений работал примерно на уровне корректора, тогда как на GPT-5 обученная поправка давала дополнительный выигрыш. Значит, калибровка иногда извлекает структуру из вероятностей, но иногда лишь исправляет перекос классов.
Больше переданного текста также не гарантировало лучшего сотрудничества. Когда агенты получали полный ответ друг друга вместе с рассуждением, они справлялись хуже, хотя GPT-5.4-nano решала свыше 85% тех же лабиринтов при доступе к целой карте. Узкое сообщение с исправленными вероятностями оказалось проще использовать, чем длинное описание чужого хода мысли.
Что менять в архитектуре многоагентной системы
Работа не требует переделывать любую систему из нескольких агентов. Её вывод относится к задачам, где участники видят разные данные, не могут передать наблюдения целиком и должны несколько раз обновлять общее решение. Примеры из статьи — агенты, которые смотрят на разные части лабиринта; тот же интерфейс применим там, где компоненты анализируют разные документы, файлы или показания датчиков.
В такой системе между агентами стоит передавать не одиночную команду, а распределение по допустимым действиям. Контракт сообщения должен фиксировать набор действий и вероятности, а журнал выполнения — сохранять правильный итог, чтобы позднее проверить калибровку.
Не следует полагаться на вероятности, которые модель написала по инструкции. Сначала их нужно сравнить с фактическими исходами. Если уверенность систематически смещена, отдельный корректор может оказаться дешевле повторных запусков и стабильнее свободного диалога между агентами.
Главная граница результата — узкая экспериментальная среда. Авторы проверяли двух агентов, искусственную цепочку признаков и выбор направления в лабиринте. Работа обосновывает формат обмена, но не доказывает, что он сохранит преимущество в длинных рабочих процессах с меняющимся набором инструментов и открытым пространством действий.
Источники
Иллюстрация: рисунок из статьи «Narrowing the Collaboration Gap, Probably», Mirah Shi, Marcel Hussing, Ira Globus-Harris и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


