
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Агент может выбрасывать часть прошлых рассуждений после того, как их результат закрепился во внешней среде. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, это сократило число входных токенов на 25,5% без снижения среднего результата. Контекст такого агента можно считать изменяемым рабочим состоянием, а не журналом, который нужно передавать модели целиком при каждом запросе.
Как ICLR решает, какие рассуждения удалить
В обычной цепочке рассуждений можно сократить уже готовый текст и проверить, сохранился ли ответ. У агента удаление меняет не только текст: следующий вызов инструмента может стать другим, среда вернёт новое наблюдение, а вся дальнейшая траектория разойдётся с исходной.
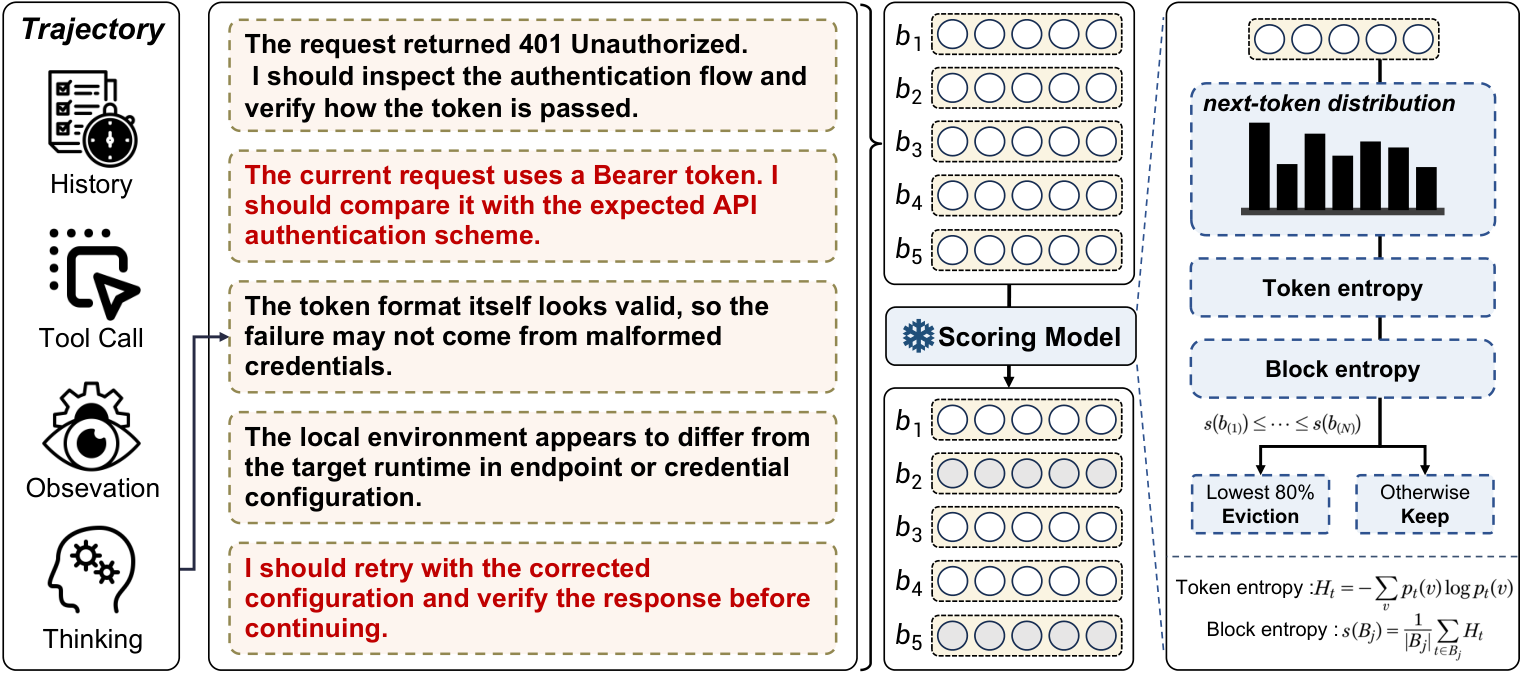
Метод ICLR работает внутри этого цикла и не требует дообучения. После завершённого шага он делит только что созданное рассуждение на блоки по пустым строкам. Действия, аргументы инструментов, их ответы, наблюдения среды и финальные ответы остаются в истории без изменений.
Замороженная модель Qwen3.5 9B оценивает предсказательную энтропию каждого блока. Эта величина показывает, насколько уверенно модель могла предсказать его текст: чем она ниже, тем меньше новой информации блок несёт для модели-оценщика. При оценке Qwen видит системную инструкцию, доступные инструменты и всю накопленную историю, поэтому один и тот же текст может оказаться полезным в одной точке траектории и лишним в другой.
ICLR удаляет 80% блоков с самой низкой энтропией и заменяет каждый маркером [SKIP]. Если блок один, метод оставляет его. Изменённая история записывается обратно навсегда: на следующем шаге агент уже не получает удалённый текст и действует из нового состояния.
Удалённый абзац меняет всю траекторию
Метод проверяли на 260 заданиях WorkBuddyBench по программированию, офисной работе, безопасности и работе с веб-средой. Агентом служил DeepSeek V4 Flash, а Qwen использовали только для отбора блоков. Средняя награда — итоговая оценка выполнения задания — выросла с 0,699 до 0,718, а чтение токенов из кэша сократилось на 33,3%.
Результат различался по типам заданий. Средняя оценка выросла за счёт задач по безопасности, тогда как в программировании, офисной работе и веб-среде ICLR уступил исходному агенту. Поэтому агрегированное улучшение нельзя переносить на каждый класс рабочих процессов.
На отдельной фиксированной подвыборке авторы сравнили ICLR с удалением всех рассуждений, случайным удалением и оценкой только последнего шага без полной истории. Контекстная оценка дала лучший средний результат среди этих вариантов, хотя некоторые более простые способы сильнее сокращали общий расход токенов.
Локальный объём удаления не определял итоговую экономию. Более слабое вмешательство иногда сокращало полный контекст сильнее, чем более агрессивное: изменившийся выбор инструмента мог убрать повторные попытки или, наоборот, вызвать дополнительное рассуждение и восстановление потерянных сведений. Авторы называют это усилением траектории.
Границы проверки довольно узкие: один исполняющий агент, одна модель-оценщик и один набор заданий, пусть и из нескольких областей. Работа показывает эффект в замкнутом цикле с инструментами, но пока не устанавливает универсальную политику очистки контекста для других моделей и сред.
Что менять в архитектуре долгих агентов
Главный сигнал для удаления — не возраст рассуждения, а место, где теперь хранится полученный из него результат. Пока план, ограничение или промежуточный вывод существует только во внутреннем тексте, риск последующего повторного вывода, дополнительного рассуждения или перестройки плана составлял 67,3%. После переноса тех же сведений в код, файл, результат инструмента или обратную связь среды риск снижался до 36,2%.
Контролируемые вмешательства показывают разницу на конкретных действиях. После записи нужного кода на диск очистка последующих рассуждений не изменила оценку выполнения правила. Когда уже полученное сообщение об ошибке скрыли из истории, агент снова вызвал Bash и получил ту же ошибку ещё раз.
Для команд, которые строят долгие агентные процессы, это поддерживает разделение контекста на временные рассуждения и устойчивое состояние задачи. Полезные ограничения и промежуточные результаты стоит закреплять в артефактах или наблюдениях, а затем проверять, можно ли удалить текст, который к ним привёл. Простая очистка по возрасту или размеру контекста не учитывает, остался ли этот текст единственным носителем важного вывода.
Экономию также нужно считать по всей траектории: учитывать повторные вызовы модели, инструменты и попытки восстановить сведения, а не только число вырезанных токенов. Работа не сводит дополнительный проход модели-оценщика и полученную экономию к денежной стоимости, поэтому ICLR пока разумнее проверять как экспериментальную политику на собственных сценариях, а не включать по умолчанию.
Источники
Иллюстрация: рисунок из статьи «When Can Agents Forget Their Reasoning? ICLR for Long-Horizon Agent Context Compression», Mingxuan Wang, Fei Luo, Bo Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


