
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель научили учитывать не только задачу, но и правила программы, которая разрешает инструменты, двигает процесс и решает, когда агент может остановиться. На TRAJECT-Bench успешность Qwen3-8B выросла с 3,09% до 22,98%, хотя препринт не прошёл рецензирование и все числа получили сами авторы. При дообучении продуктового агента состояние контура исполнения стоит показывать модели явно, а не прятать в последовательности действий.
Как состояние контура стало обучающим сигналом
LLM работает агентом только вместе с контуром исполнения. Этот код передаёт модели историю, открывает доступные инструменты, проверяет права, добавляет результаты вызовов и определяет допустимый момент завершения.
Обычная обучающая траектория содержит запрос, ответы модели и вызовы инструментов. Она показывает, какое действие произошло, но не объясняет, почему именно оно было допустимо: какая стадия процесса активна, какие обязательные шаги уже выполнены и можно ли выдавать итоговый ответ.
Из-за этого модель может правильно владеть инструментом и всё равно нарушать порядок работы. Она повторяет завершённый шаг, вызывает функцию до выполнения зависимости или заканчивает сессию, когда в контуре осталось обязательное действие. Ошибка одного шага меняет последующую историю, поэтому локальная неточность распространяется на весь запуск.
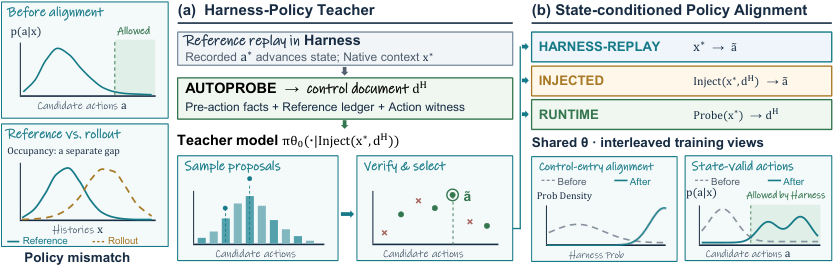
Метод Harness Policy Distillation, или HPD, извлекает эти скрытые условия из самого контура. Записанные траектории повторно запускают через целевую среду, а перед каждым обращением к модели собирают управляющий документ. В нём фиксируют текущую стадию, выполненные и ожидающие обязательства, доступные действия и право завершить задачу.
Затем исходная замороженная модель получает историю вместе с этим документом и предлагает варианты следующего действия. Контур отбрасывает варианты, которые нельзя исполнить, которые нарушают текущую стадию или расходятся с записанным вызовом инструмента и его аргументами. Из прошедших проверку вариантов выбирают ближайший к эталонной траектории и сохраняют как цель для обучения.
Одну модель обучают сразу на трёх представлениях данных. Она предсказывает проверенное действие по обычной истории, то же действие по истории с управляющим документом и сам документ по истории. Совместное обучение связывает наблюдаемую переписку, внутреннее состояние контура и допустимое действие.
Во время работы управляющий документ не нужен. Модель получает исходный интерфейс агента, а контур не делает дополнительного обращения к другой модели. Документ служит только привилегированной подсказкой при подготовке данных и дообучении.
Проверка отделила правильный ответ от правильного процесса
Основной опыт провели на 583 отложенных заданиях TRAJECT-Bench. Qwen3-8B дообучали через LoRA и запускали внутри контура Pi; сравнение включало обучение на примерах, предпочтениях, проверяемой награде и действиях модели-учителя.
HPD поднял соблюдение правил контура до 49,23% против 19,90% у исходной модели. Он также обошёл обучение на действиях учителя OPD, которое достигло 15,61% успешных задач. В том же агенте результат оказался немного выше DeepSeek V4 Flash с 22,30%.
Отдельные метрики объясняют, почему точности действий по эталонной истории недостаточно. Модель может продолжить правильный префикс, но ошибиться, когда генерирует всё действие самостоятельно. Проверенные цели HPD связывают первый управляющий выбор с аргументами инструмента и состоянием, в котором вызов действительно разрешён.
Совместное обучение трём представлениям сработало лучше последовательного. Когда модель сначала учили действиям, а затем переключали только на восстановление документа или работу с ним, качество замкнутого запуска падало. Чередование сохраняло прямое обучение тому интерфейсу, который используется после развёртывания.
Метод отдельно адаптировали для Llama, Gemma и нескольких вариантов Qwen, а также для контуров ReAct, Compiler и OpenCode. Во всех показанных конфигурациях успешность выросла, но для каждой пришлось заново собирать воспроизведение траекторий, управляющие документы и проверку действий. Это проверка переносимости подхода, а не один универсальный адаптер.
Планы меняются там, где продукт задаёт собственный порядок действий
Работа предлагает перенести часть усилий с разметки ответов на описание исполняемого процесса. Если продукт уже хранит стадии, права, зависимости и условия завершения, эти поля можно превратить в цели обучения. Для этого контур должен уметь воспроизводить записанные траектории и проверять предложенное действие до добавления в набор данных.
Такой подход особенно уместен для агентов с обязательной последовательностью операций: получения разрешений, вызова нескольких зависимых сервисов или подтверждения результата перед завершением. Для простого помощника без собственного состояния подготовка адаптера и проверяющего кода может оказаться лишней.
План оценки тоже стоит менять. Точность следующего вызова на эталонной истории не показывает, сохранит ли агент допустимый процесс после собственной ошибки. Нужны свободные запуски, доля завершённых задач и отдельная проверка соблюдения правил контура.
Перенос без дополнительного обучения на BFCL v4 подтверждает, что эффект не сводится только к запоминанию исходных заданий: на 92 примерах полный HPD достиг 21,74% успешных задач против 13,04% у варианта, обученного только проверенным действиям. Но основной объём проверки всё же приходится на TRAJECT-Bench и специально подготовленные контуры.
Для команды, которая уже планирует дообучение агента, практический вывод прямой: состояние процесса следует проектировать как часть обучающих данных. HPD не заменяет контур исполнения и не снимает потребность в проверках — он учит модель заранее учитывать те же правила, которые контур всё равно применит.
Источники
Иллюстрация: рисунок из статьи «Harness Policy Distillation: Aligning Agent Policies with Runtime Semantics», Junze Zhu, Weihao Chen, Zhiyang Zhou и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


