
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Добавление новых однотипных задач не всегда делает лидерборд ИИ-агентов надёжнее: выбор программной обвязки способен поменять порядок моделей. В пока не рецензированном препринте, где числа получили сами авторы, надёжность рейтинга готовых систем составила от 0,935 до 0,994, а рейтинга базовых моделей — от 0,148 до 0,841. Поэтому результат теста нельзя переносить с готового агента на модель без отдельной проверки.
Работа разделяет два объекта оценки. Первый — готовая система из модели и программной обвязки (scaffold), которая хранит состояние, подключает инструменты и превращает ответы модели в действия. Второй — сама модель, результат которой должен сохраняться при смене обвязки.
Для анализа исследователи разложили различия в результатах на вклад моделей, задач, обвязок и их сочетаний. Коэффициент надёжности лежит между нулём и единицей: чем он ближе к единице, тем меньше рейтинг зависит от конкретных условий теста. Одна обвязка может давать устойчивые результаты внутри себя, но ранжировать модели иначе, чем другая.
Простое расширение набора задач устраняет только неопределённость, связанную с задачами. При неизменном наборе обвязок даже бесконечное число сходно составленных заданий повышало надёжность рейтинга моделей не более чем на 0,097. Иначе говоря, тысячи дополнительных прогонов не исправят перекос, если модели проверяют через слишком узкий набор агентных систем.
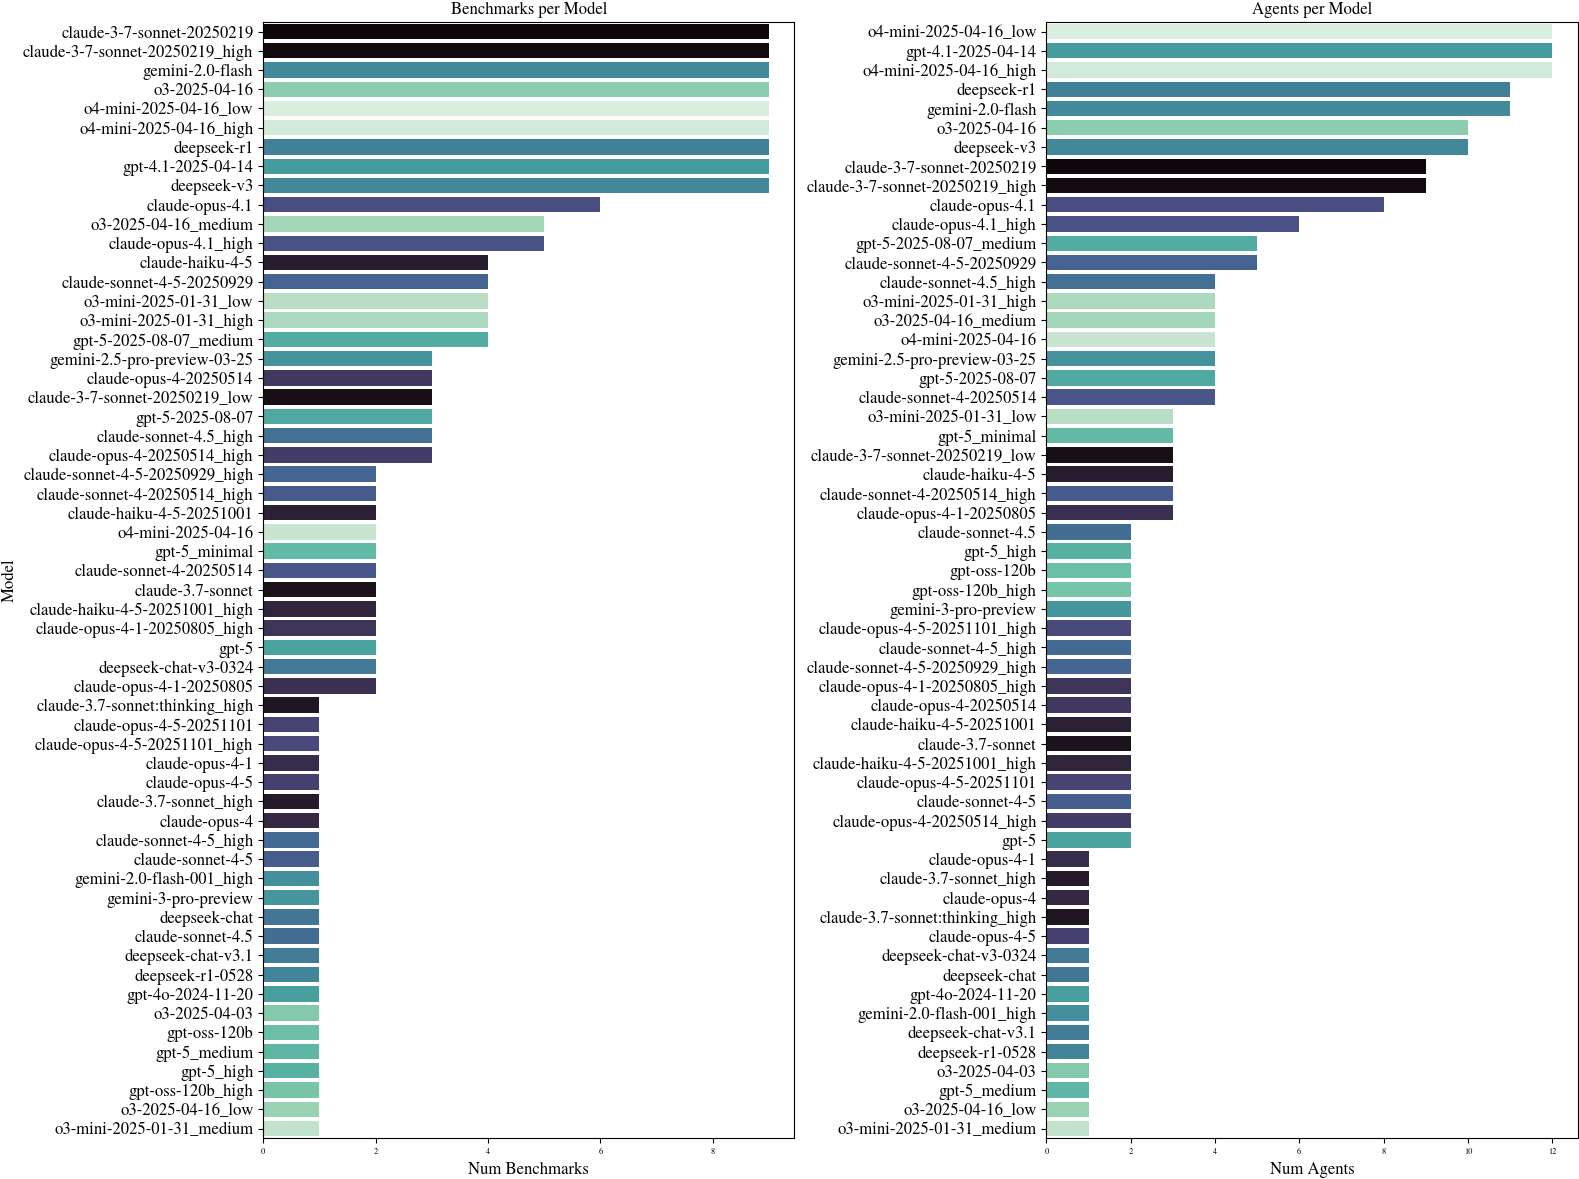
Проверка охватила 22 бенчмарка из Holistic Agent Leaderboard и Harbor Index — всего 30 859 запусков на задачах по программированию, работе с вебом, научным вычислениям, поддержке клиентов и общей помощи. Данные были разреженными: модели и обвязки тестировали в разных сочетаниях, что соответствует устройству реальных лидербордов, но ограничивает перенос выводов за представленные типы задач и систем.
Для сравнения моделей полезнее распределять тот же бюджет между разными бенчмарками и обвязками. В расчётах объединение бенчмарков подняло ожидаемую надёжность рейтинга с 0,44 до 0,75 при прежнем числе задач, а распределение запусков с учётом источников неопределённости сокращало расчётную стоимость до 83%.
Источники
Иллюстрация: рисунок из статьи «Agent Evaluation Reliability: More Tasks Won't (Always) Fix An Agent Leaderboard», Michael Hardy, Ruhana Azam, Anka Reuel и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


