
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Долгоживущего LLM-агента научили выбирать нужное направление рассуждения без постоянного чтения всей накопленной истории. В препринте Hong Su, который не прошёл рецензирование и содержит замеры самого автора, DeepSeek с такой подсказкой выбирал нужные факторы точнее, чем без неё. Для архитектуры агента это означает, что часть повторяющейся работы можно перенести из поиска по памяти в небольшую обучаемую модель.
Лёгкая модель решает, о чём думать, а LLM — как рассуждать
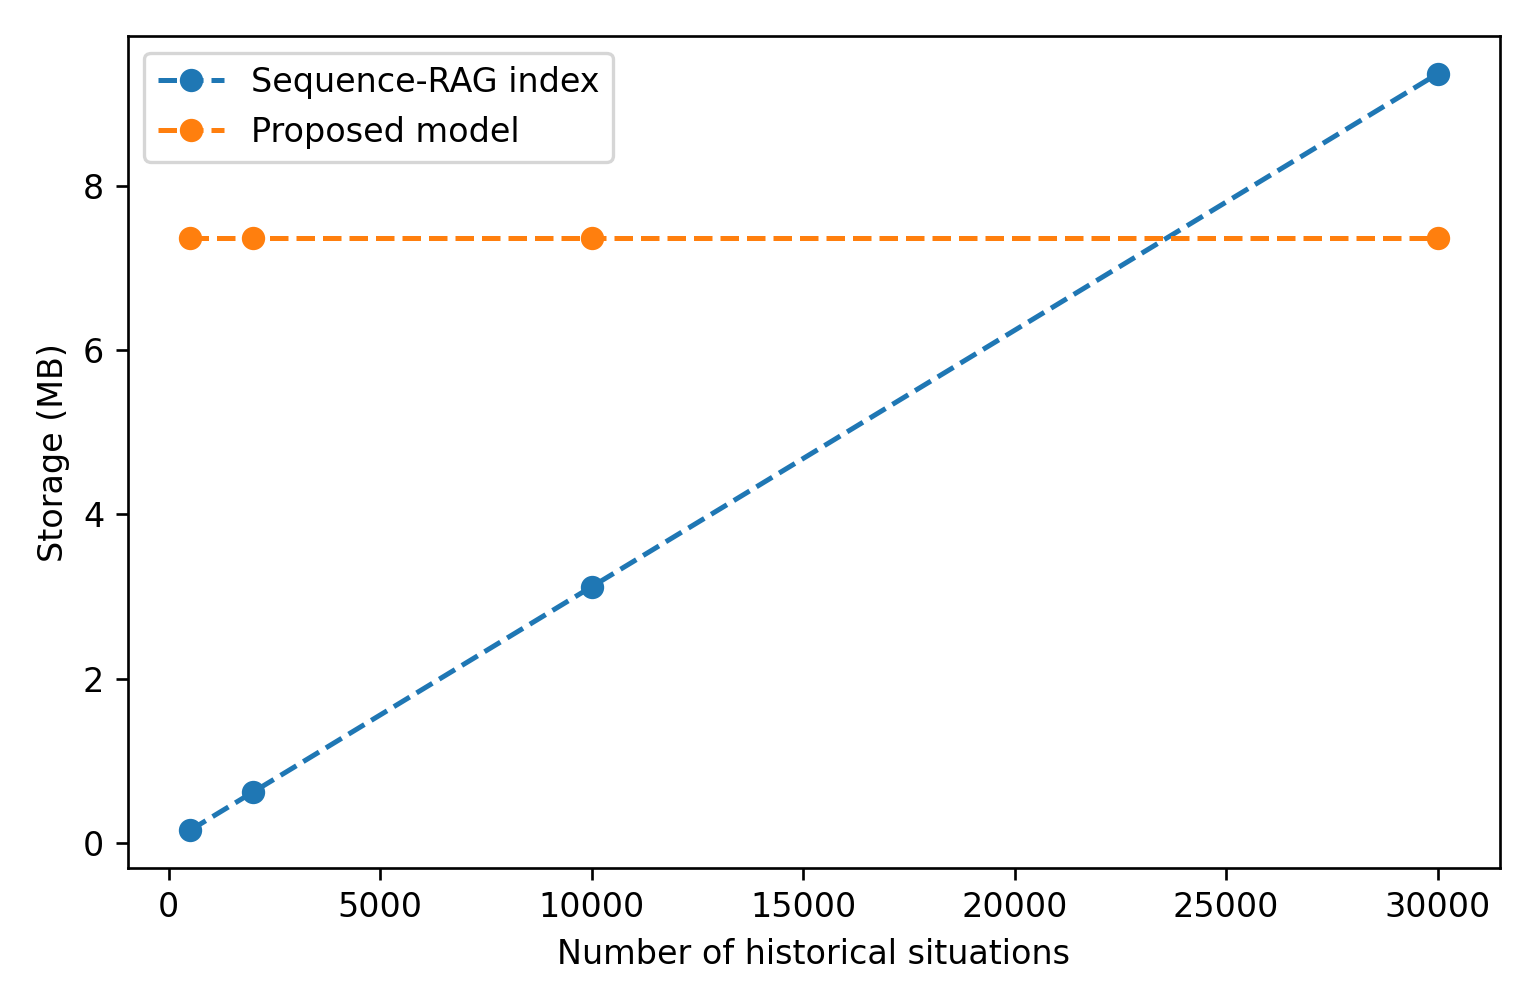
Обычная долговременная память хранит наблюдения, выводы и результаты действий, а затем ищет подходящие записи и добавляет их в контекст LLM. По мере работы агента растут хранилище, индекс и зависимость результата от качества поиска.
Предложенная схема использует прошлые рассуждения как материал для обучения. Лёгкая модель получает описание текущей ситуации и выдаёт короткое требование: проверить скрытую зависимость, оценить отложенный риск, сопоставить сигналы или запросить дополнительные сведения. Подробный разбор по-прежнему выполняет LLM на свежих данных.
Ситуация здесь включает не только текущее состояние, но и путь к нему. Два эпизода могут закончиться одинаковым наблюдением, однако потребовать разных рассуждений, если перед этим события развивались по-разному. Поэтому политика учится связывать направление мысли с последовательностью состояний, а не только с последним снимком.
Знание попадает в политику двумя путями. Если один эпизод уже содержит полезный урок, LLM превращает его в обучающую пару «ситуация — требуемое рассуждение». Если закономерность распределена по разным эпизодам, агент временно сохраняет опыт и периодически сопоставляет повторения, контрпримеры, обратный порядок событий и устойчивость связи во времени.
Найденная связь сначала остаётся гипотезой. Она становится обучающим материалом только после повторного подтверждения, а новые противоречия могут ослабить или удалить правило. Так агент не обязан считать причинностью каждую последовательность, которую однажды заметила LLM.
Повторяющийся опыт заменил поиск по растущей истории
В сквозном эксперименте подсказка от выученной политики повысила F1 DeepSeek с 0,789 до 0,868. F1 объединяет точность и полноту выбора нужных факторов в одну оценку. Разница с вариантом, который явно искал похожий опыт через RAG, осталась в пределах погрешности, но политика не переносила найденные исторические записи в контекст.
При истории из 30 000 ситуаций онлайн-обработка запроса стала примерно в 9,5 раза быстрее по сравнению с поиском по памяти. Размер входа лёгкой модели после обучения не растёт вместе с архивом: она получает текущую ситуацию и сразу предсказывает требуемый тип рассуждения.
Отдельный опыт проверял правило, которого не было целиком ни в одной записи. В историю добавили случайные обозначения событий, длинные интервалы, ложные совпадения и эпизоды с обратным порядком. После восьми независимых повторений система без ошибок выделила скрытую связь и научилась заранее активировать мысль о возможном следующем событии.
На этой синтетической задаче ранжирование по статистике справилось не хуже варианта с DeepSeek. Роль LLM состояла не в том, чтобы превзойти подсчёт повторений, а в том, чтобы сопоставить свидетельства, сформулировать правило понятным способом и превратить его в материал для лёгкой политики.
Механизм проверяли в контролируемых задачах с искусственными временными сигналами, редкими шаблонами и случайными кодами событий. Сравнения охватывали агента без подсказок, RAG, статистическое выделение связей и вариант с заранее известными правильными правилами. Поэтому результаты показывают работоспособность конструкции, но не измеряют её качество на неоднородной производственной истории.
Планы меняет устройство памяти, а не выбор базовой LLM
Работа предлагает разделить память агента на два контура. Эпизодическое хранилище остаётся источником фактов и материала для ещё не подтверждённых закономерностей. Повторяющиеся требования к рассуждению постепенно переходят в обучаемую политику и перестают требовать поиска при каждом запросе.
Такое разделение подходит агентам, которые месяцами выполняют однотипные процессы: обслуживают оборудование, следят за цепочками операций или возвращаются к похожим сбоям. Политика может заранее включать проверку отложенного последствия или связанного сигнала, а LLM разбирает конкретный случай. Выигрыш появляется там, где одни и те же типы рассуждений повторяются достаточно часто для обучения.
Полностью заменять RAG этой схемой работа не предлагает. Если решение требует точной прошлой записи, документа или исходного наблюдения, агенту всё равно нужна явная память. Политика хранит не свидетельство, а указание, какое рассуждение стоит применить.
Для проектирования это означает отдельный фоновый цикл: накапливать временный опыт, искать устойчивые связи, проверять их на контрпримерах и обновлять обучающий набор. Онлайн-контур после этого остаётся коротким: лёгкая модель выбирает направление, LLM рассуждает по текущим данным, а архив подключается только тогда, когда нужны сами исторические факты.
Источники
Иллюстрация: рисунок из статьи «Learning Situation-Conditioned Thinking Policies for Long-Term LLM Agents», Hong Su, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


