
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Решение агентной LLM вызвать внешний инструмент или ответить текстом оказалось связано с компактным внутренним состоянием, которое можно сдвинуть в обе стороны. В препринте Xijie Gong и коллег, который не прошёл рецензирование и содержит замеры самих авторов, вмешательство заставляло модель менять выбор даже в штатном многошаговом диалоге: инструмент включался на 70% ходов, где без вмешательства модель отвечала текстом. Для продуктовых команд это означает, что формат служебной части запроса сам задаёт склонность к действию, а формулировка пользователя чаще подавляет её, чем создаёт заново.
Один глагол изолировал момент выбора
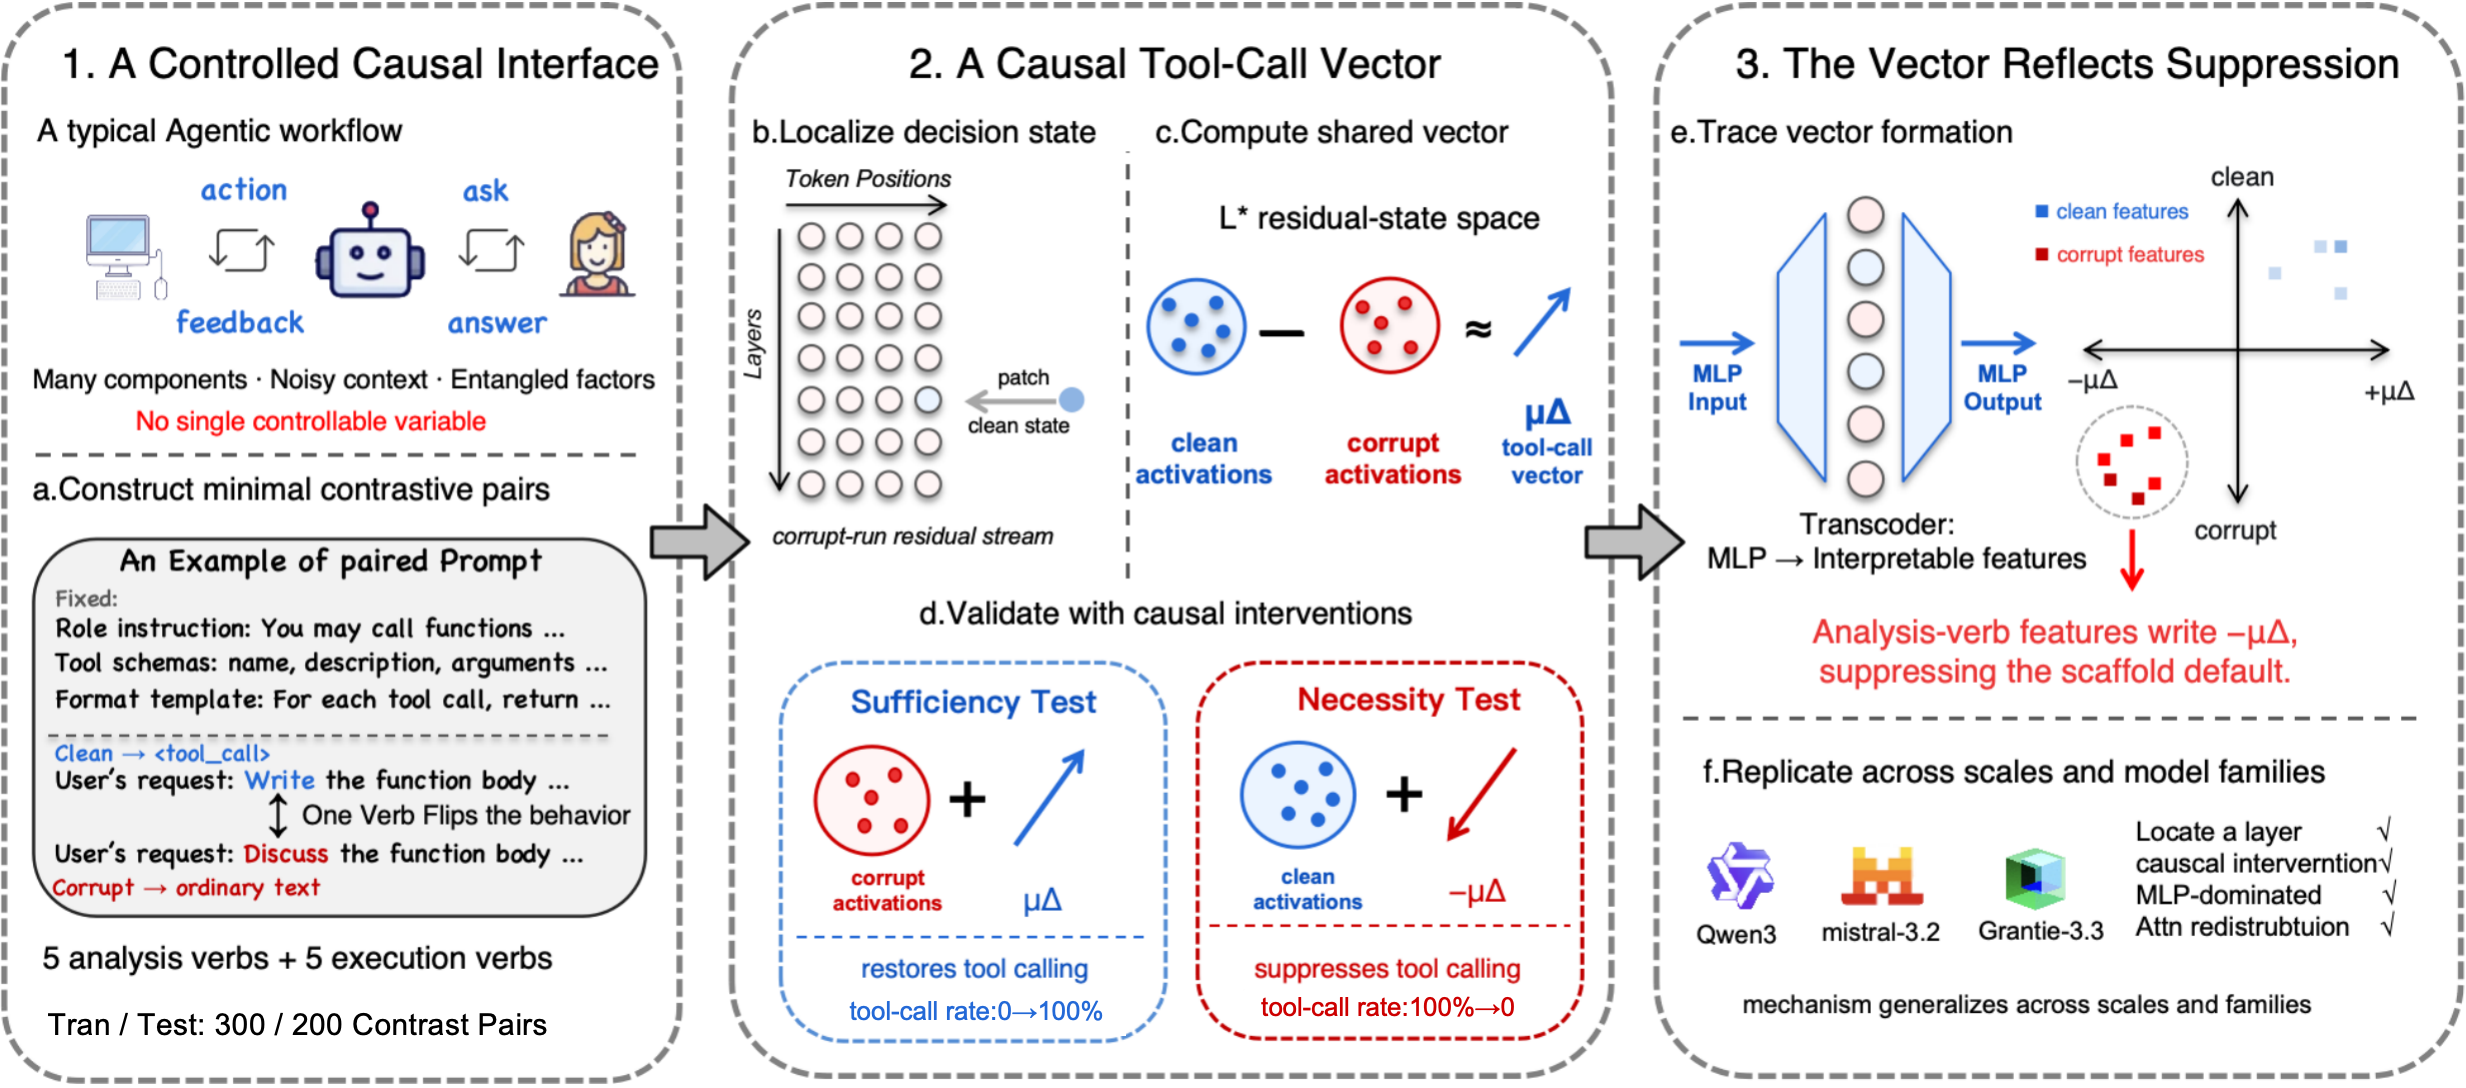
Обычный запрос к агенту смешивает инструкции роли, описания инструментов, правила формата и задачу пользователя. Чтобы отделить решение о вызове от остального контекста, работу строили на парных запросах, где менялся только глагол: например, просьба написать функцию превращалась в просьбу обсудить её.
Для основного разбора на Qwen3-8B собрали 500 пар по задачам на Python, Java и C++ из MBPP, APPS, HumanEval и CodeContests. В каждой сохранённой паре глагол действия приводил к вызову инструмента, а аналитический глагол — к текстовому ответу. Такой отбор не измеряет обычную частоту вызовов, зато создаёт контролируемое различие для разбора внутренних состояний.
У Qwen3-8B решение видно по первому выходному токену: вызов начинается со специальной метки <tool_call>. Авторы поочерёдно заменяли внутренние активации одного запроса активациями парного и нашли точку, после которой выбор уже сформирован, — последний токен запроса на слое 24.
Средняя разница между активациями для действия и анализа стала вектором вызова инструмента. Если добавить его к запросу с аналитическим глаголом, модель начинает вызывать инструмент; если вычесть из запроса с глаголом действия, отвечает текстом. На отложенных парах оба вмешательства меняли первый токен в 100% случаев, поэтому вектор выступает не просто признаком решения, а его причинным переключателем в этих условиях.
Каркас запроса создаёт склонность к вызову
Разбор компонентов показал обратную картину по сравнению с интуитивной моделью «глагол действия запускает инструмент». Каркас запроса (prompt scaffold) заранее склоняет LLM к вызову, если видит содержательную задачу. Особенно сильно действует шаблон, который задаёт формат ответа, а описание инструмента связывает эту склонность с формулировкой запроса.
Аналитические глаголы активируют внутренние признаки со смыслом «инструмент не нужен» и подавляют исходную склонность. Глаголы действия почти ничего не добавляют: они оставляют её без подавления. На следующих слоях механизмы внимания сильнее обращаются к шаблону вызова, а внутренние блоки поднимают вероятность специального первого токена.
Этот механизм не ограничился отобранными фразами про код. При вычитании вектора в многошаговых сценариях τ2-Bench модель отказалась от 36,7% исходных вызовов. В запросах без явного глагола действия — например, в вопросах, которые лишь подразумевают поиск или обращение к API, — то же вмешательство подавило 93,1% вызовов. Случайный вектор той же длины почти не менял решения, что отделяет эффект от общего возмущения активаций.
Проверка охватила длинные диалоги с десятками доступных инструментов, а также поиск в интернете, SQL и отправку почты. Для новых предметных областей направление вектора сохраняли, но его величину подбирали по отдельным примерам. Поэтому перенос показывает общее внутреннее представление решения, но не готовый универсальный коэффициент для любой модели и конфигурации.
Что меняется в планах агентных продуктов
Служебный шаблон стоит рассматривать как часть политики агента, а не как нейтральную упаковку API. Изменение правил формата или описания инструмента может сдвинуть частоту вызовов ещё до того, как модель обработает смысл пользовательской просьбы. Проверять нужно весь каркас, включая варианты с аналитическими, косвенными и безглагольными формулировками.
Отдельной метрикой становится правильность бинарного выбора: вызывать инструмент или отвечать без него. Она не совпадает с выбором подходящего инструмента, корректностью аргументов и успешным завершением задачи. Работа исследует только первый шаг, поэтому высокий результат здесь не доказывает надёжность агента целиком.
Сам вектор пока полезнее как диагностический инструмент для команд с доступом к активациям модели. Для каждой из семи проверенных моделей семейств Qwen, Mistral и Granite использовали собственное направление, а основной разбор механизма проводили на Qwen3-8B с фиксированным каркасом и заранее отобранными парами. Прямо переносить найденный вектор в другую LLM без повторного измерения работа не предлагает.
Практический вывод относится к проектированию и тестам: лишние вызовы нельзя исправлять только запретом в пользовательской инструкции. Если шаблон уже создал сильную склонность к действию, модель будет решать, нашла ли она достаточный сигнал для подавления. Значит, тестовый набор должен отдельно покрывать случаи, где инструмент обязателен, допустим и не нужен, сохраняя при этом одинаковый служебный каркас.
Источники
Иллюстрация: рисунок из статьи «How Do Agentic LLMs Decide to Call Tools? A Tool-Call Vector Shaped by Suppression», Xijie Gong, Tingxu Han, Jiahao Zhang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


