
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
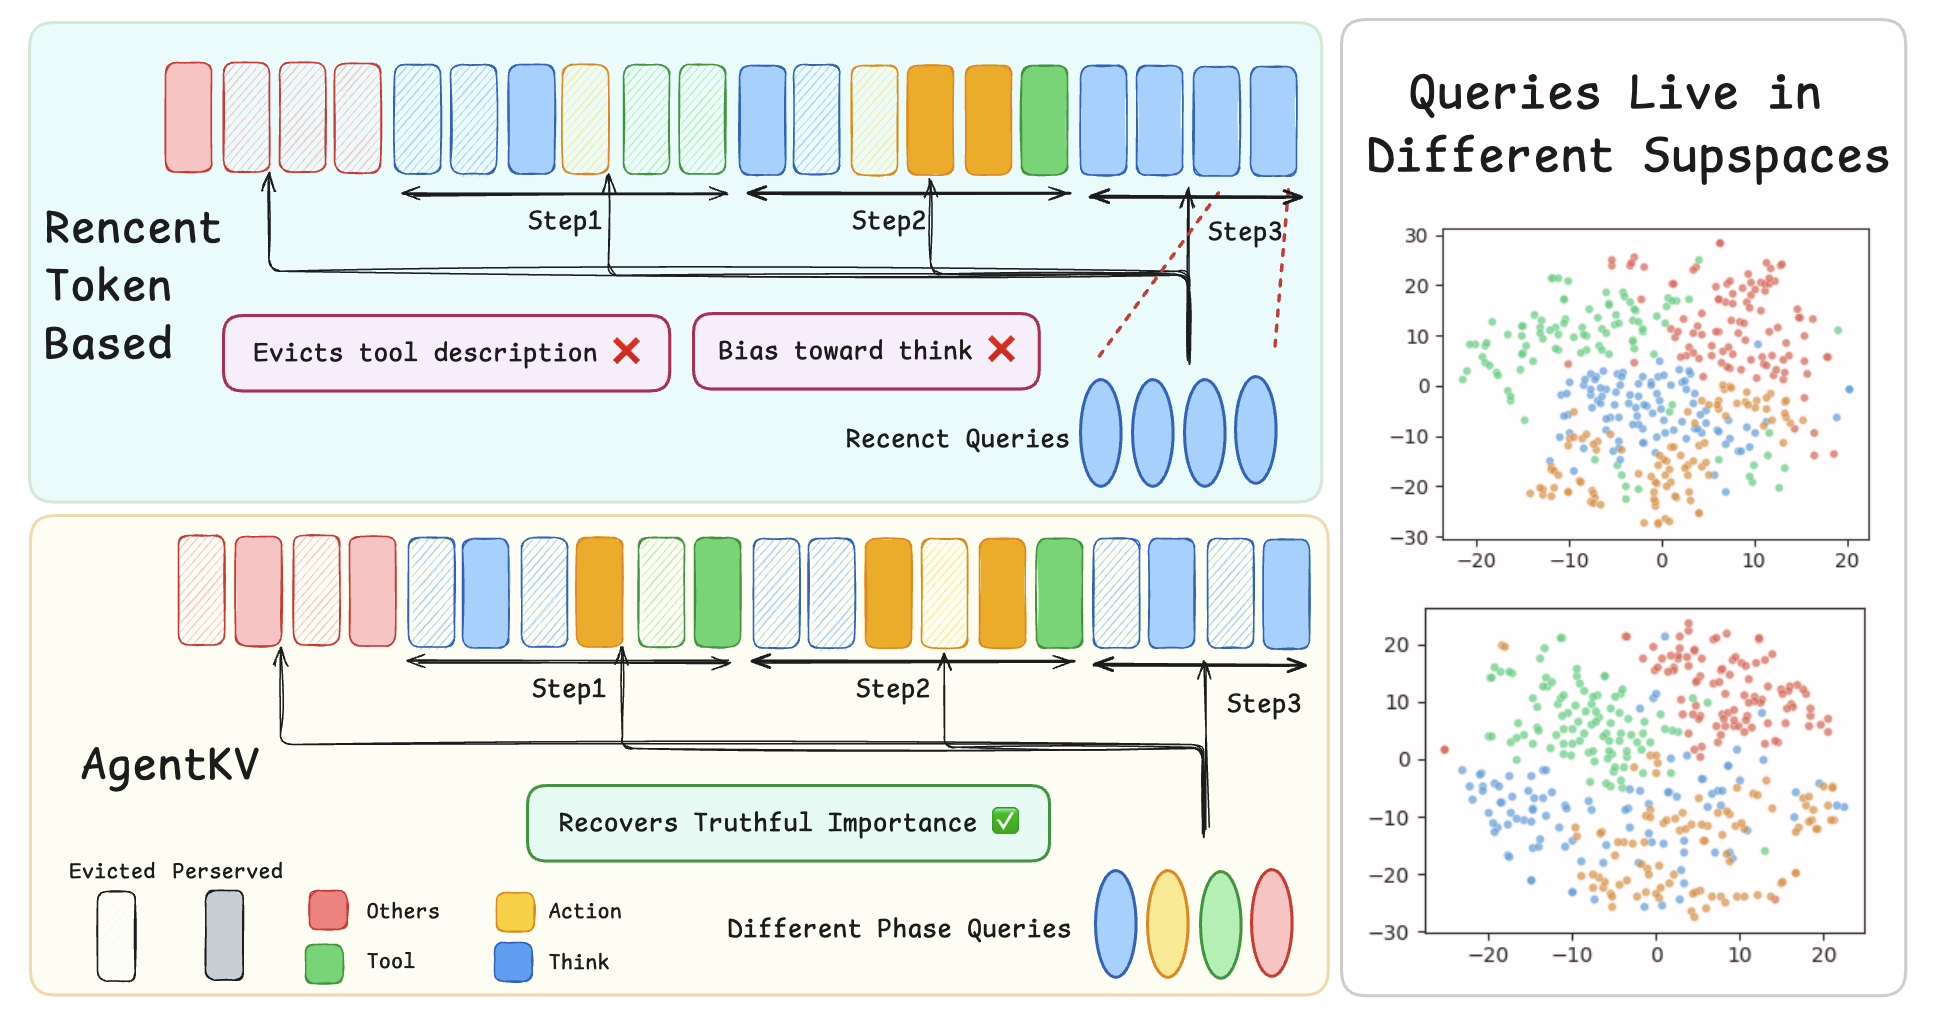
Кэш внимания агентной LLM можно сжимать точнее, если учитывать переходы между рассуждением, вызовом инструмента, его ответом и остальным контекстом. AgentKV ускорил выдачу токенов до 1,8 раза относительно SGLang с полным кэшем; результат описан в препринте Imperial College London и Columbia University, который не прошёл рецензирование и содержит замеры самих авторов. Для команд это переносит оптимизацию с отдельного запроса на всю траекторию агента между вызовами инструментов.
Почему недавнее внимание не предсказывает следующий шаг
KV-кэш хранит ключи и значения, к которым модель обращается при генерации следующих токенов. Чем длиннее история агента, тем больше памяти занимает кэш и тем больше данных GPU читает на каждом шаге.
Обычные способы вытеснения записей оценивают их по последним запросам внимания. Такой подход предполагает, что ближайшее будущее похоже на недавний фрагмент: если модель сейчас рассуждает, полезными считают записи, связанные с текущим рассуждением.
У агента это предположение нарушается. После рассуждения он формирует аргументы вызова, затем получает ответ инструмента и снова возвращается к анализу. Инструкция или наблюдение, которое почти не нужно в текущей фазе, может стать определяющим после следующего перехода.
Работа делит траекторию на четыре семантические фазы: рассуждение, действие, ответ инструмента и прочий контекст, куда входят системная инструкция, описание инструментов и запрос пользователя. Сравнение направлений запросов внимания показало, что фазы занимают различимые области пространства представлений. Повторные фрагменты одной фазы похожи друг на друга сильнее, чем фрагменты разных фаз.
Авторы также проверили записи кэша по тому, сколько внимания они фактически получили в будущем. При самом тесном из рассмотренных бюджетов недавние запросы почти теряли полезные записи из ответов инструментов, а выборка по фазам сохраняла более чем вчетверо больше их будущей полезности.
Как AgentKV выбирает и освобождает записи кэша
AgentKV ведёт отдельную очередь недавних запросов внимания для каждой фазы. Перед сжатием система объединяет эти очереди, оценивает по ним все ключи и оставляет записи с наибольшим средним вниманием. Она не делит сам кэш на части и не резервирует место под каждую фазу, поэтому полезная запись может занять место независимо от своего происхождения.
В основных опытах общий набор представителей состоял из 32 запросов. Дальнейшее увеличение набора не давало стабильного прироста, поэтому метод не требует хранить длинную историю запросов только ради оценки кэша.
Фазу определяет не отдельный классификатор, а простой разборщик маркеров в шаблоне диалога. Он распознаёт начало рассуждения, вызова и ответа инструмента даже тогда, когда маркер разбит на несколько токенов. Для другого шаблона нужно заменить таблицу маркеров; при переносе на Llama-3.3-Nemotron-Super-49B-v1.5 остальная логика не менялась.
Одного правильного списка записей недостаточно для ускорения. Если сервер пометит часть KV-кэша как ненужную, но оставит страницы памяти на месте, GPU продолжит платить за чтение и не сможет принять больше параллельных запросов.
Поэтому реализация AgentKV физически уплотняет сохранённые записи, возвращает освобождённые страницы распределителю памяти и переносит сжатое состояние через вызовы инструментов и следующие ходы. Сжатие запускается каждые 128 токенов генерации и работает в обычном пути декодирования вместе с порционной обработкой входа и CUDA-графами.
Когда AgentKV меняет планы по инфраструктуре агента
Основную проверку провели на Qwen3-32B и Qwen3-8B, шести доменах BFCL и τ2-bench и трёх бюджетах KV-кэша. AgentKV повысил средний балл задания на 5,5 пункта относительно R-KV и на 5,3 пункта относительно Tri-attention. Лучше всего разница проявлялась в многоходовых сценариях, где инструкции и ответы инструментов оставались полезными после нескольких переходов между фазами.
Работа меняет планы, если продукт уже упирается в память или пропускную способность GPU при обслуживании длинных агентных траекторий. В таком случае стоит проверять не только размер кэша, но и то, сохраняет ли сервер его между ходами, умеет ли физически освобождать страницы и доступны ли надёжные границы фаз в шаблоне диалога. Замена одной формулы ранжирования без уплотнения памяти не даст показанного выигрыша в скорости.
Метод не задаёт универсальный бюджет кэша: его подбирают на проверочном наборе под требуемые качество и задержку. При слишком жёстком сжатии места не хватает независимо от способа отбора, а при слабом сжатии стратегии приближаются к полному кэшу. Польза также меньше, когда актуальное состояние целиком повторяется в последнем ответе инструмента или хранится во внешней памяти.
Практический вывод узкий: AgentKV не заменяет архитектуру памяти агента и не обещает качество полного кэша при любом бюджете. Он показывает, что для многоходового агента единицей оптимизации должен быть не последний фрагмент текста, а повторяющийся цикл рассуждения, действия и наблюдения — вместе с серверным механизмом, который превращает отбор записей в реально освобождённую память.
Источники
Иллюстрация: рисунок из статьи «AgentKV: Phase-Aware KV Eviction for Agentic LLMs», Taowen Tony Liu, Jeffrey T. H. Wong, Can Xiao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


