
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
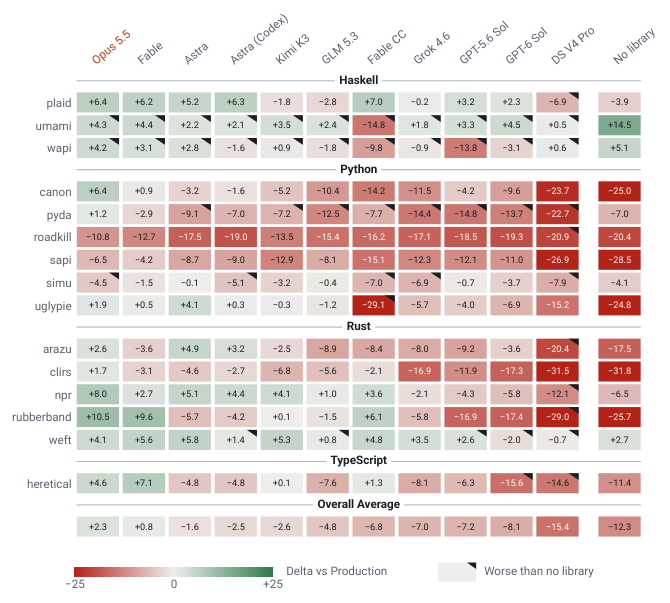
Агенты могут создавать библиотеки, которые помогают другим агентам писать рабочий код, но те всё равно часто заново реализуют уже готовые функции. Хотя этот препринт не прошёл рецензирование и все числа получили сами исследователи, команда из University of Wisconsin–Madison, Massachusetts Institute of Technology, Snorkel AI и Stanford University показала, что лучший агент обошёл зрелые библиотеки на 4,9%. Для команд, которые поручают агентам общие модули и SDK, одних тестов библиотеки теперь недостаточно: нужно проверять, какой код напишет её следующий пользователь.
Качество библиотеки измерили через код её пользователей
LibraryDesignBench разделяет работу на две фазы. Сначала агент получает спецификацию возможностей и несколько примеров использования, но сам выбирает интерфейсы и структуру библиотеки. Затем новые агенты из разных семейств решают прикладные задачи с этой библиотекой.
В проверку вошли 242 задачи на четырёх языках. Среди них есть библиотека для разбора аргументов командной строки в Rust: агент должен поддержать команды, флаги, типизированные значения, связи между аргументами и автоматическую справку, но готовый дизайн ему не дают.
Оценка соединяет корректность и простоту пользовательской программы. Долю пройденных тестов возводят в квадрат, чтобы короткое, но неверное решение не получило высокий балл. Простоту сравнивают с экспертной реализацией на зрелой библиотеке: учитывают строки кода, ветвления, вложенность и объём операторов.
Такой подход отделяет наличие функций от удобства API. Библиотека может пройти собственные тесты, но заставить следующего агента писать адаптеры, обходить жёсткие ограничения или дублировать внутреннюю логику. Обычная проверка пакета этого не обнаружит.
Результаты относятся к фиксированному набору задач, конфигураций агентов и вычислительных бюджетов. Проверка измеряет тестовую корректность и статическую сложность пользовательских программ, но не оценивает безопасность, скорость выполнения и долгосрочную сопровождаемость самой библиотеки.
Полный набор функций не гарантирует короткий код
В 11 из 15 заданий агенты воспроизвели основные абстракции зрелых библиотек. Они выбирали знакомые классы, построители и цепочки вызовов, даже когда будущими пользователями должны были стать не люди, а другие агенты.
Проблема проявилась на следующем шаге. Агенты подключали как сгенерированные, так и зрелые библиотеки, но использовали лишь часть их возможностей. Они искали ожидаемые имена в API, не замечали незнакомые функции и дописывали собственную реализацию.
В аудите неудачных решений 64% случаев лишнего кода связаны с жёстким или неудобным интерфейсом. Нехватка возможностей встречалась заметно реже. Значит, добавление новых методов не исправляет главную причину: агенту трудно составить нужное поведение из уже доступных частей.
Тогда проектировщику прямо указали, что библиотеку будут использовать только агенты. Его попросили сначала набросать пользовательские программы, добавить исполняемые примеры и проверить API с помощью подагентов. Итоговая оценка выросла на 2,3 пункта, главным образом за счёт более короткого кода, и почти сравнялась с результатом зрелой библиотеки.
Приёмку общего кода стоит перенести на следующий шаг
Работа меняет планы команд, если агенты создают код не для одной задачи, а для дальнейшего переиспользования: внутренние SDK, клиенты API, библиотеки валидации или общие компоненты. Такой модуль нельзя принимать только по его собственным тестам. В проверку стоит включить отдельного агента, который не видел процесс разработки и решает несколько типовых задач через публичный API.
Полезная метрика здесь — не размер библиотеки, а объём кода вокруг неё. Если пользовательский агент добавляет собственный разбор данных, обходные ветки или вспомогательные классы, библиотека не сняла сложность, а переместила её в каждый следующий проект.
Спецификацию также стоит строить от сценариев потребителя. Сначала агент пишет несколько коротких программ с предполагаемым API, затем реализует библиотеку и отдаёт её подагентам на проверку. Исполняемые примеры важнее длинного описания: они показывают ожидаемый путь и дают агенту готовые имена для поиска.
У такого процесса есть цена. Руководство для проектировщика и тестирование с подагентами почти удвоили стоимость создания одной библиотеки: 8,24 доллара против 4,51 доллара. При этом стоимость решения последующих задач практически не изменилась, поэтому дополнительные расходы приходятся на общий компонент, а отдача зависит от того, сколько раз его переиспользуют.
Все приёмы проверяли вместе, поэтому работа не показывает, какой из них дал основной прирост. Практичный первый шаг — добавить потребительские проверки в приёмку библиотек и наблюдать, какие части API агенты обходят или переписывают. Это даст более полезный сигнал, чем ещё один набор внутренних тестов.
Источники
Иллюстрация: рисунок из статьи «Can Agents Design Libraries for Agents?», Gabriel Orlanski, Alex L. Zhang, Avi Trost и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


