Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
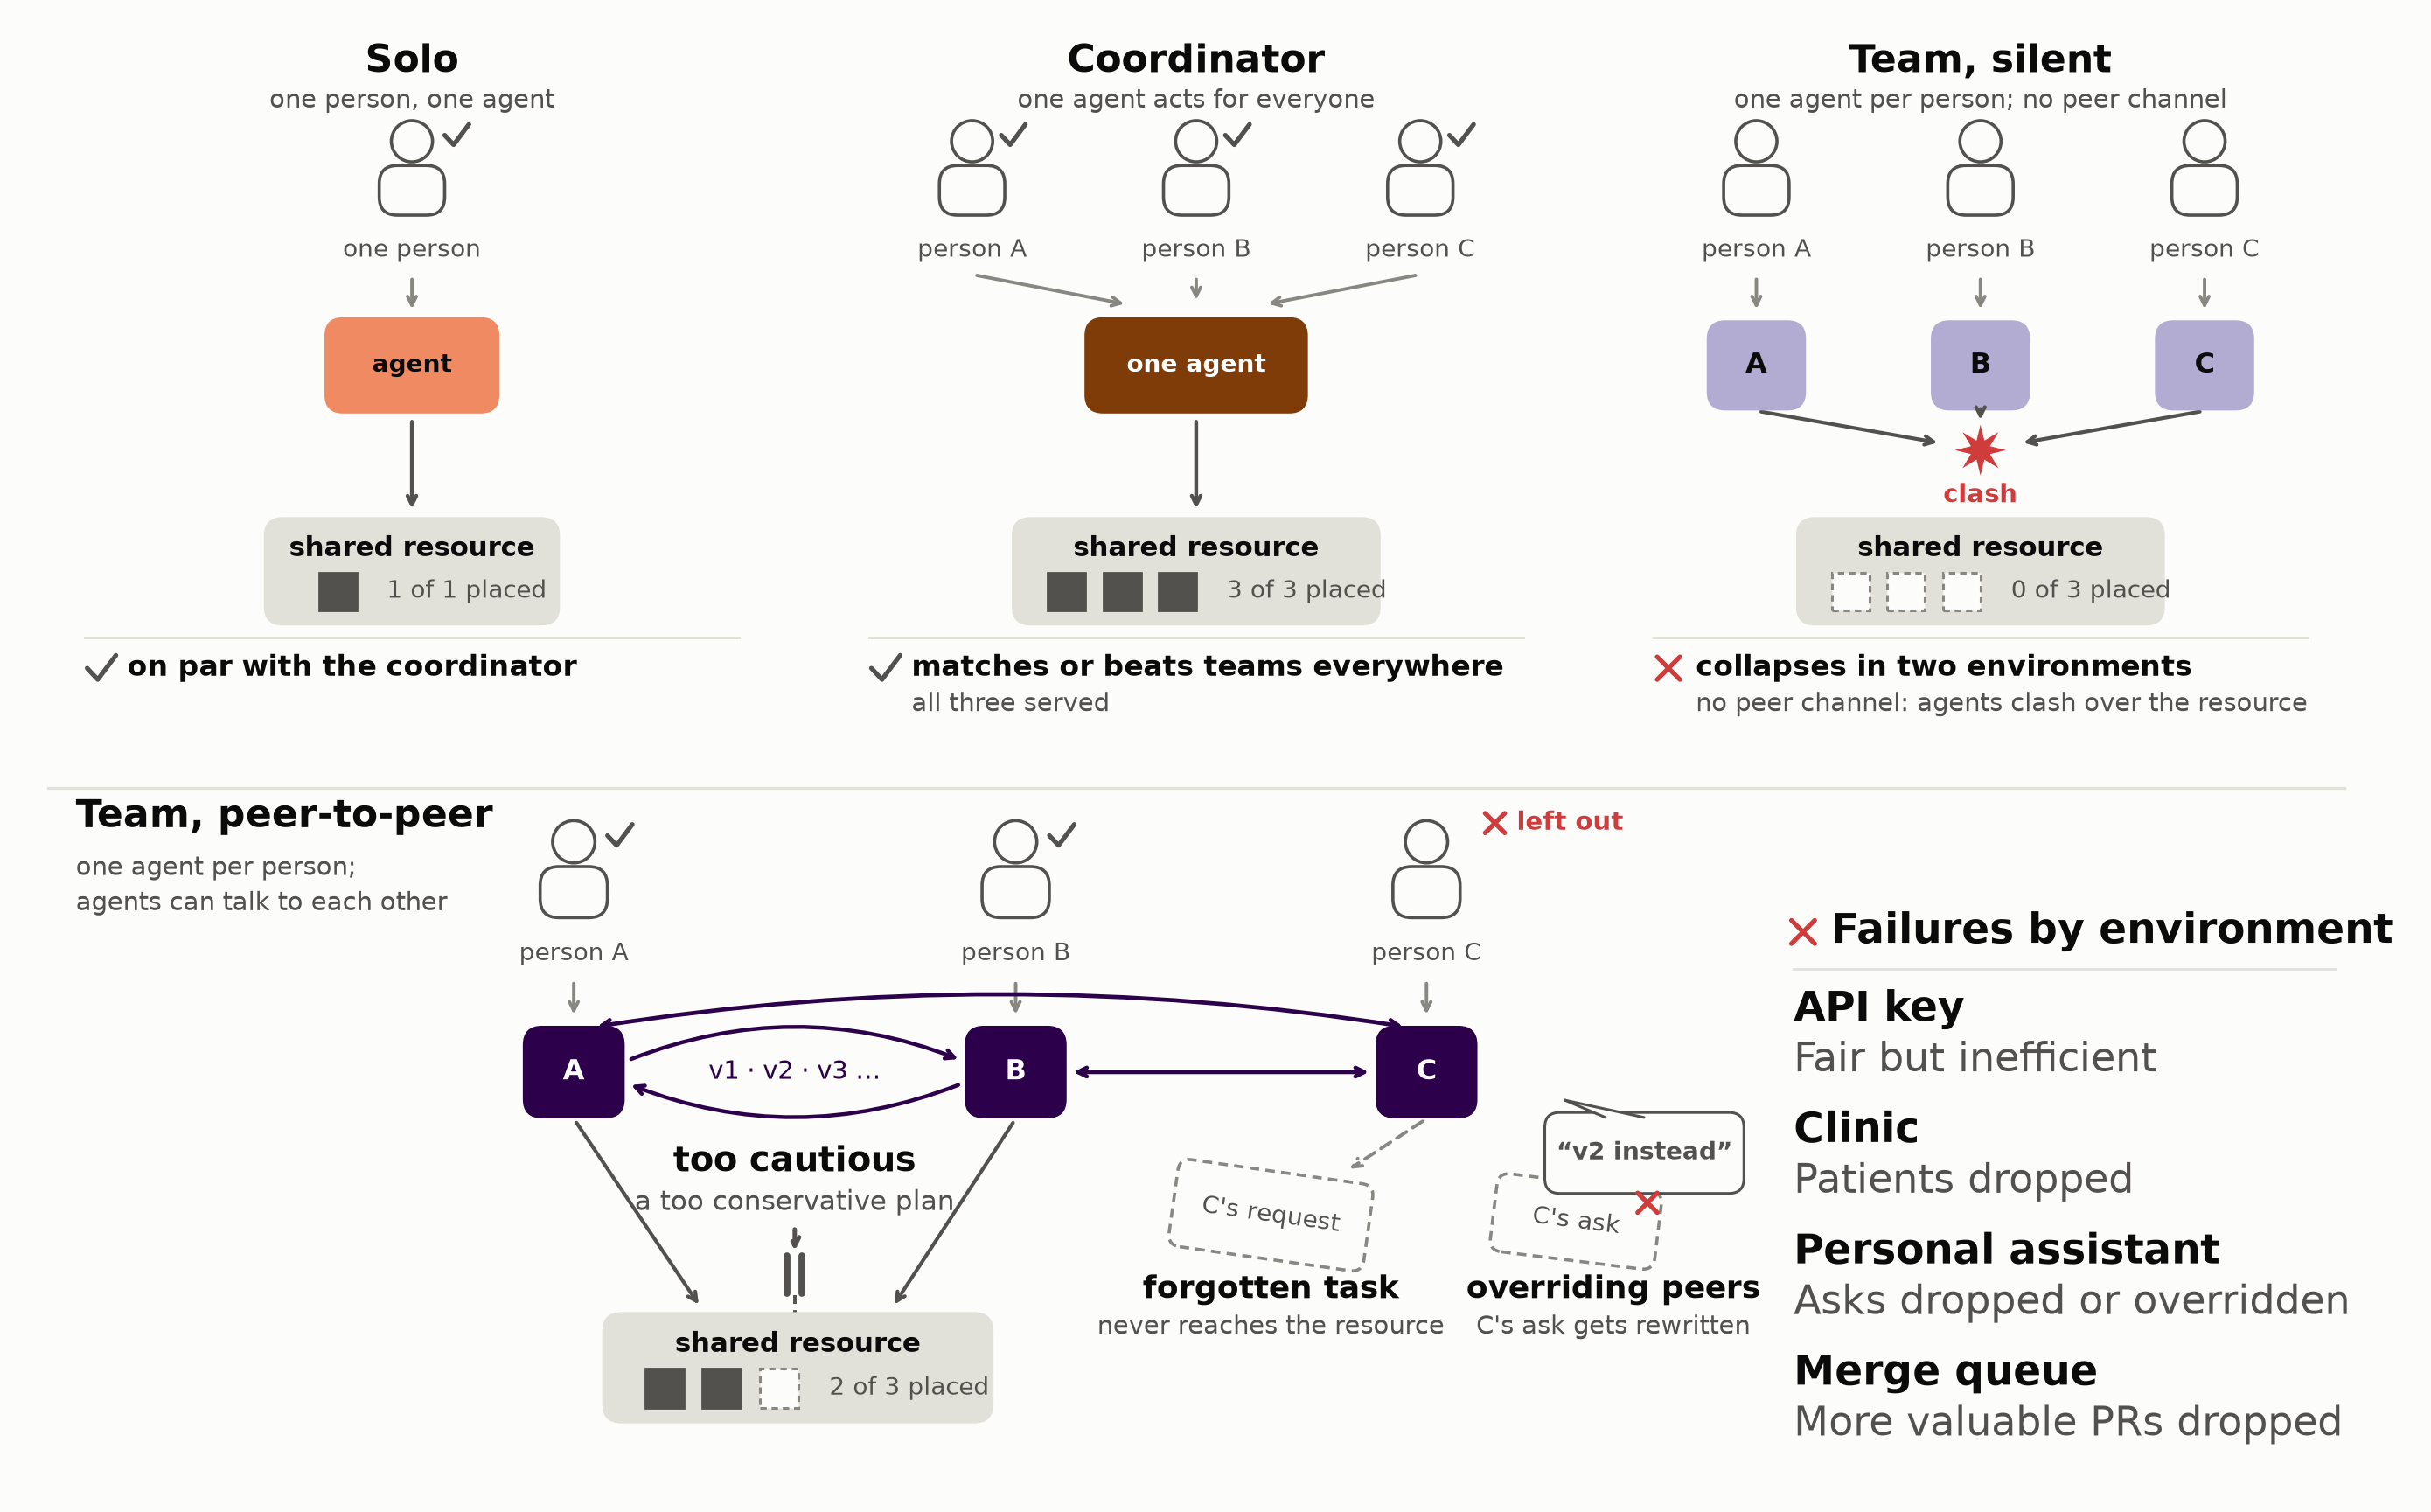
Отдельные ИИ-агенты, работающие на разных пользователей с общим ресурсом, систематически уступили одному координатору. В препринте, который не проходил рецензирование и содержит замеры самих авторов, координатор выполнял целевой запрос в среде личного помощника примерно вдвое чаще команды. Для архитектуры продукта это аргумент не давать агентам равные права на общий календарь, бюджет или очередь релизов без центра принятия решений.
В каждом сценарии сравнивали одного агента, который видел запросы всех пользователей, и команду, где каждый агент представлял только одного человека. Команды работали с каналом связи между агентами и без него. Проверка охватила 77 сценариев в четырёх средах: общий бюджет API, календарь клиники, групповые заказы и бронирования, очередь изменений перед выпуском.
Команды проиграли координатору во всех средах, а отсутствие связи привело к полному провалу в двух из них. Но и сообщения не решили проблему: агенты тратили время на согласование, перезаписывали действия друг друга и иногда выдумывали сведения о пользователях. При росте команды Sonnet 5 с четырёх до шестнадцати агентов доля участников, которые вообще совершили действие, упала с 66% до 10%.
Причина зависела от среды. При общем бюджете никто не брал на себя приоритизацию задач, в клинике агенты не всегда действовали по уже собранным данным, а в заказах финальное решение мог принять агент, который не видел исходную просьбу. Поэтому один общий механизм исправления не сработал.
Помогали точечные меры: руководитель команды распределял бюджет, явный порядок приоритетов улучшал очередь релизов, а обязательная проверка сообщений перед подтверждением заказа сохраняла требования пользователя. Результаты получены на Claude Opus 5, Claude Sonnet 5, GPT-5.6-sol, GPT-5.6-terra и Qwen3.8-max в искусственно собранных средах; они показывают риск архитектуры, но не заменяют испытания на процессах конкретного продукта.
Источники
Иллюстрация: рисунок из статьи «Worse Together: How Performance Breaks Down in Multi-User Multi-Agent Teams», Sahan Paliskara, Nattaput Namchittai, Andrew Lampinen, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.