
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Группа одинаковых ИИ-агентов решила сложные задачи, которые независимые параллельные запуски проходили реже или не проходили вовсе. В препринте Jongho Park и коллег, который не прошёл рецензирование и где все числа получили сами авторы, команда из пяти агентов показала тот же результат, что и 33 независимых запуска. Для команд это аргумент в пользу общей рабочей среды, но только в задачах с проверяемым прогрессом и достаточным запасом вычислений.
Общая директория заменяет диспетчера
Авторы не назначали агентам роли и не добавляли центрального координатора. Каждый агент получал одну задачу, одинаковые инструменты и собственный контекст модели. Черновики он хранил отдельно, а результаты, сообщения и рабочие файлы — в общей директории.
Главным каналом связи служил журнал, в который можно было только дописывать новые записи. Агенты публиковали находки, неудачные попытки, измеренные результаты и инструкции для воспроизведения. Отдельные файлы хранили принятые подходы, опровергающие свидетельства и лучшие оценки решений.
Чтобы агенты не начинали с одной идеи, каждый занимал пронумерованную директорию через атомарную файловую операцию: одновременно получить одно место не могли два процесса. Перед началом работы агент просматривал уже занятые направления и выбирал отличающийся подход.
Протокол также сдерживал слишком раннее сближение. Агент переходил на чужой подход лишь после результата с явно лучшей оценкой, но сохранял хотя бы одно существенное отличие. Изменения общего итогового файла проходили через блокировку, поэтому параллельные записи не портили артефакт.
Такую схему проверяли на трёх типах задач. ARC-AGI-3 требовал самостоятельно открыть правила 25 интерактивных игр. В задаче упаковки полимино агенты улучшали программу на C++, а в сжатии классификатора MNIST уменьшали код и веса при заданной точности. Последний эксперимент шёл 96 часов, поэтому работа охватывает не только короткие ответы, но и многодневный поиск.
Преимущество росло на длинных цепочках поиска
Главное сравнение сталкивало команду, которая общается, с лучшим результатом такого же числа независимых агентов. Модель, инструменты и ресурсы на одного агента оставались одинаковыми. Расход авторы сопоставляли и по прошедшему времени, и по числу выходных токенов, чтобы не принять дополнительный бюджет за эффект общения.
На ARC-AGI-3 команда из пяти агентов сравнялась по доле полностью решённых игр с 33 независимыми агентами. Разрыв увеличивался ближе к последним уровням: ранние шаги часто проходил один агент, а для полного решения требовалось объединить несколько промежуточных открытий.
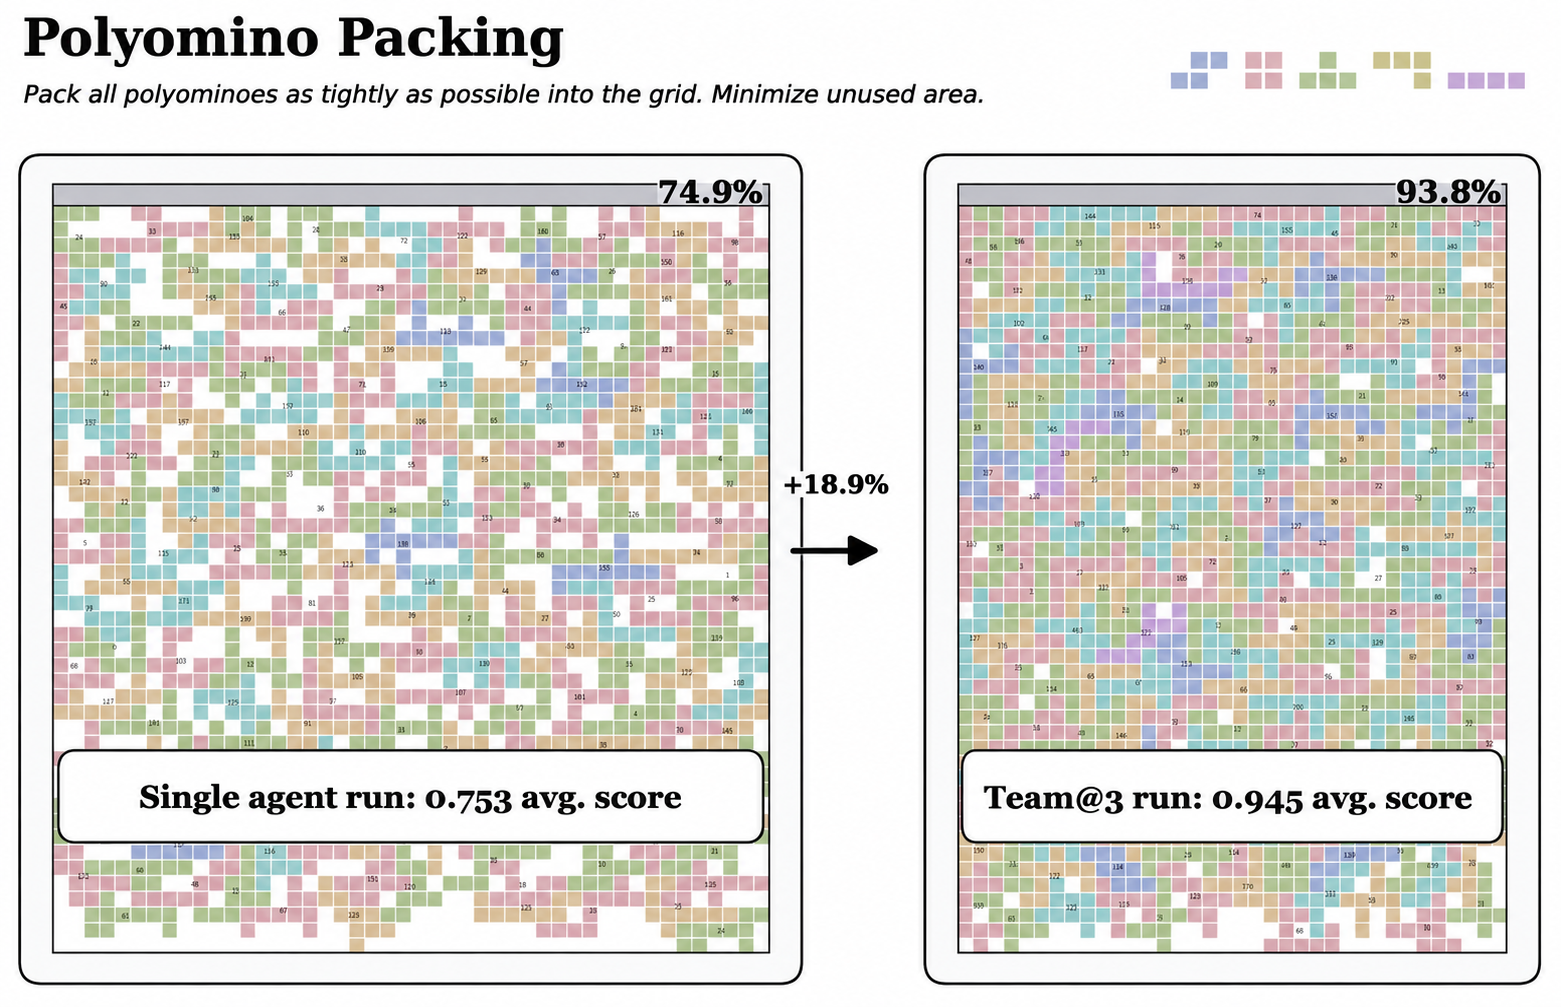
На упаковке полимино общение дало результат выше прежнего лучшего показателя. А в эксперименте с MNIST агенты собрали классификатор размером 1 957 байт при точности 99,4% — прежнее лучшее человеческое решение занимало 2 461 байт. В обоих случаях участники не просто выбирали готовый вариант, а последовательно улучшали находки коллег, включая идеи из неудачных веток.
Результат не сводится к разделению задачи на независимые части. Все агенты решали одну и ту же проблему, но начинали с разных направлений. Пользу приносило распространение проверенного улучшения: удачная находка меняла дальнейший поиск всей команды, а слабая отбрасывалась по внешней оценке.
Общая среда нужна не каждому агентному процессу
Работа меняет планы прежде всего для систем, которые долго оптимизируют проверяемый артефакт: программу, модель, упаковку или решение с автоматическим тестом. В таком процессе имеет смысл заменить часть независимых запусков небольшой группой с общим журналом, таблицей результатов, раздельными черновиками и правилами принятия чужих идей.
Ключевое условие — агент должен быстро понять, улучшил ли коллега результат. В экспериментах эту роль выполняли завершённый уровень, оценка упаковки и размер классификатора при обязательной точности. Такой сигнал позволял отличать прогресс от убедительно написанного, но слабого сообщения.
При малом бюджете общение, наоборот, создавало издержки: агенты тратили время на записи, проверку чужих результатов и смену направления. На Terminal-Bench 2.0 пара общающихся агентов превзошла одиночную попытку, но не обошла пару независимых запусков. Авторы связывают это с тем, что доступная обратная связь плохо ранжировала промежуточные решения.
Поэтому переносить результат на поддержку, аналитику или другие процессы с субъективной оценкой пока рано. Практический пилот стоит сравнивать с независимыми запусками при одинаковом времени и расходе токенов. Если у задачи нет автоматической проверки или работа заканчивается до того, как агенты успевают развить чужую находку, общая директория добавит координацию без измеримого выигрыша.
Эксперименты также не определяют лучшую архитектуру многоагентной системы. Авторы использовали одинаковые модели, один фиксированный протокол, плоскую связь и отсутствие ролей. Работа показывает, когда даже такая минимальная схема может окупиться, но не сравнивает её с диспетчером, специализированными агентами или разными моделями внутри команды.
Источники
Иллюстрация: рисунок из статьи «Scaling Discovery through Test-Time Communication», Jongho Park, Vasilis Kontonis, Shivam Garg и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


