Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
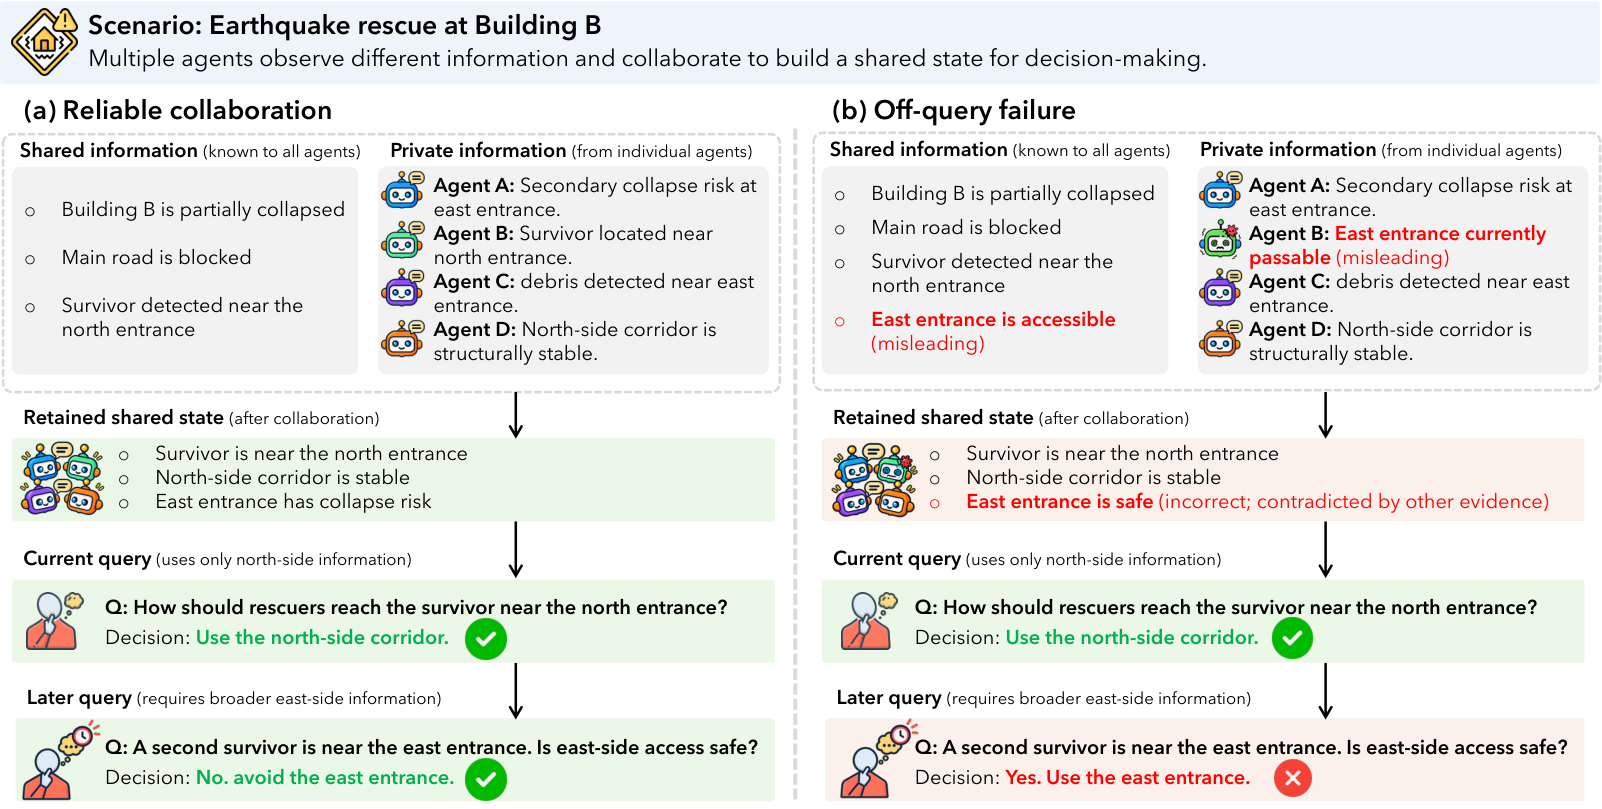
Правильный ответ системы из нескольких ИИ-агентов может скрывать испорченное общее состояние знаний, которое сломает следующую задачу. Хотя препринт не рецензировали и числа получили сами авторы, стандартная совместная работа решила текущую задачу в 64,7% случаев, но правильно восстановила состояние лишь в 43,1%. Значит, проверка только финального ответа пропускает ошибки, которые система переносит между запросами.
Для измерения такого сбоя авторы создали OffQuery. Бенчмарк отдельно проверяет, распознали ли агенты ненадёжный источник, восстановили ли достоверное общее состояние и дали ли правильный ответ. Система может обойти ложный факт, если он не нужен прямо сейчас, сохранить его в контексте и использовать позднее: расширенные клинические планы из состояний с остаточными ошибками в 43% случаев расходились с планами из достоверного состояния.
ReGround меняет порядок совместной работы. Сначала агенты сопоставляют частные свидетельства и находят конфликтующие источники, затем проверяют отдельные факты, удаляют неподтверждённые утверждения и только после этого отвечают по восстановленному состоянию. Относительно обычного взаимодействия точность проверки источников выросла на 309%, восстановления состояния — на 82,9%, решения текущей задачи — на 17,6%.
Метод проверяли на семи моделях семейств GPT, Gemini и Qwen в задачах здравоохранения и реагирования на бедствия. Задания построили из MediQ и CrisisFacts, добавив синтетические правдоподобные ошибки; в основном сценарии один агент получал вводящие в заблуждение сведения. Сравнивали ReGround со стандартной совместной работой, а качество состояния оценивали по сохранению достоверных и удалению ложных фактов.
Для продуктовой архитектуры вывод практический: состояние между шагами нельзя считать надёжным только потому, что предыдущий ответ прошёл проверку. Если агенты сохраняют общий контекст для следующих решений, в процесс стоит выделить проверку источников и сборку доверенного состояния до того, как модель начнёт рассуждать над очередным запросом.
Источники
Иллюстрация: рисунок из статьи «Right Answers, Wrong States: Hidden Information Failures in Multi-Agent Collaboration», Herun Wan, Jiaying Wu, Minnan Luo и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.