
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Память LLM-агента научили искать сведения, записывать их и вовремя останавливаться как единый процесс, чтобы ошибка одного шага не закреплялась на следующем. В нерецензированном препринте Bingbing Wang и коллег, где все числа получены самими авторами, AiO-Mem набрал на LoCoMo 61,0 по F1 против 58,7 у Mem-T. Для продуктовых команд это повод пересмотреть раздельное обучение поиска и записи, но не готовая замена существующего контура.
Поиск, запись и остановка работают с одним состоянием
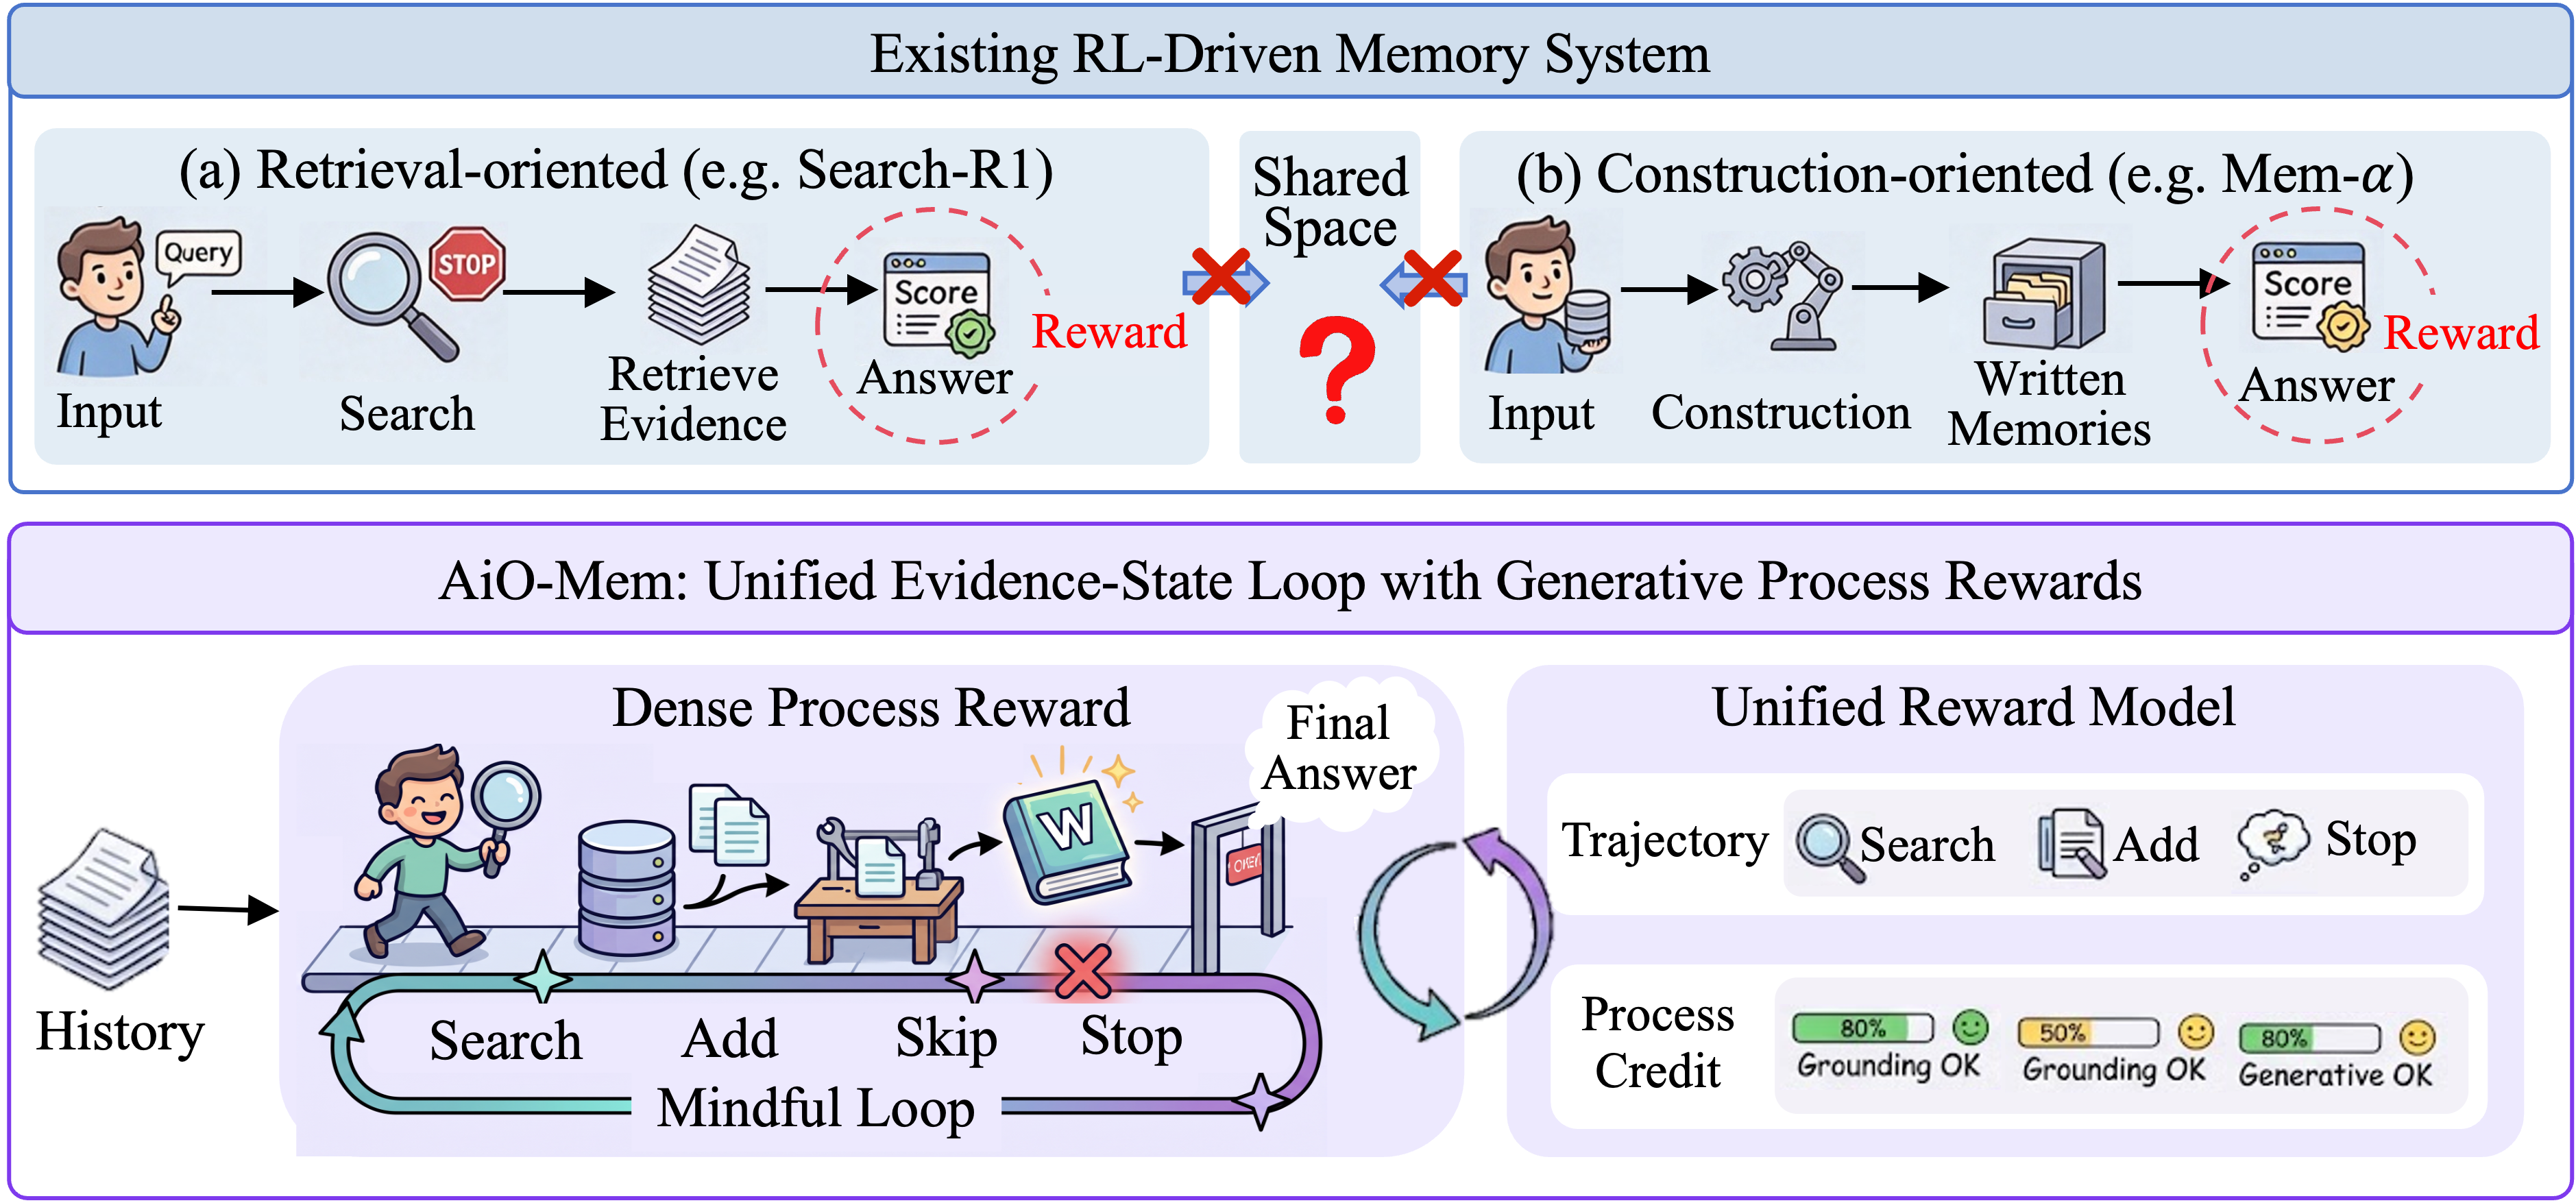
Обычный агент памяти часто делит работу на независимые части. Один модуль ищет фрагменты истории, другой превращает их в краткие записи, а решение об остановке задаёт отдельное правило. Каждый модуль получает собственный сигнал качества, поэтому удачный поиск ещё не гарантирует корректную запись.
AiO-Mem хранит общий набор данных: вопрос, текущую рабочую память и последние найденные фрагменты. Политика агента сначала выбирает поиск или остановку. После поиска она должна добавить запись в рабочую память либо отбросить кандидатов. Такая последовательность не позволяет записать сведения до поиска или начать новый поиск, не решив судьбу прежнего результата.
Исходную историю заранее разбивают на события по смене темы и привязывают каждое событие к месту в источнике. Для поиска событие представляют в исходной форме, как сводку, как набор возможных вопросов и как короткую смысловую формулировку. Ранжирование объединяет лексический поиск BM25 и поиск по смысловой близости через BGE-M3.
Источник остаётся связан с записью в рабочей памяти. Благодаря этому модель-награда может проверить не только наличие подходящих слов, но и то, добавил ли агент нужное свидетельство, не исказил ли связь между сущностями и не остановился ли раньше времени.
Награда оценивает каждый шаг, а не только финальный ответ
Модель-награду сначала обучают на правилах, которые учитывают эталонные фрагменты и их происхождение. Затем её дообучают на предпочтениях: отдельная рассуждающая модель сравнивает полные траектории и выставляет более подробные оценки действиям в их контексте.
Поиск, добавление, пропуск и остановка получают отдельные оценки. Перед обучением политики оценки усредняют внутри каждого вида действий, а затем объединяют. Поэтому длинная серия поисковых запросов не перевешивает единственное, но критичное решение об остановке.
На LoCoMo AiO-Mem улучшил итоговую F1 — показатель, который сводит точность и полноту ответов в одну оценку. В разборе компонентов сильнее всего качество падало без последовательного построения рабочей памяти. Удаление обучения на источниках и последующего обучения на предпочтениях тоже ухудшало результат: одной правильности финального ответа оказалось недостаточно, чтобы различать хорошие и плохие пути к нему.
В эксперименте по эффективности на LoCoMo агент сократил расход токенов на поиск на 79,9%, а на построение памяти — на 73,8%. Лучшей оказалась конфигурация с десятью найденными событиями за запрос и максимум восемью шагами взаимодействия; дальнейшее расширение поиска и траектории не давало устойчивого выигрыша.
Архитектуру стоит примерить, обучение — сначала проверить на прототипе
Работа меняет планы команд, которые строят агентов с длинной историей диалога, постоянным профилем пользователя или доказательствами из нескольких документов. Если поиск и запись уже обучаются отдельно, полезно хотя бы перевести их на общее состояние и сохранять ссылки от краткой записи к исходному фрагменту. Это позволяет оценивать весь путь данных, а не только ответ генератора.
Полная схема требует двух обучаемых моделей: Qwen3-4B управлял памятью, а Qwen3-8B оценивал траектории. Финальный генератор оставался замороженным. Следовательно, результат показывает улучшение именно контура памяти, но перенос потребует собрать траектории, определить эталонные свидетельства и обучить собственную модель-награду.
Метод проверяли на LoCoMo, MemoryAgentBench и PersonaMem: это длинные диалоги, последовательные взаимодействия и динамические профили пользователей. Такой набор покрывает несколько разновидностей памяти, однако остаётся испытанием на подготовленных задачах, а не на истории из работающего продукта.
Для первого внедрения достаточно проверить три элемента отдельно: сохраняет ли поиск происхождение фрагмента, исправляет ли агент рабочую память по мере поступления новых данных и умеет ли оценка процесса отличать преждевременную остановку от достаточного ответа. Если выигрыш появляется уже здесь, совместное обучение политики становится обоснованным следующим этапом. При работе с пользовательской историей также придётся встроить правила доступа, хранения, удаления и исправления записей.
Источники
Иллюстрация: рисунок из статьи «All-in-One Memory: Process-Rewarded Reinforcement Learning for Memory Agents», Bingbing Wang, Jingjie Lin, Weiming Qiao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


