
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Подсказки при обучении LLM-агентов научились привязывать к смыслу решения, а не к номеру шага в траектории. В препринте, который не проходил рецензирование, все числа получили сами авторы: AlignOPSD обошёл GRPO на 5,5–8,7% в задачах с длинной последовательностью действий. Метод меняет схему обучения агентов, которым награду можно выдать только за конечный результат.
Почему номер шага путает причину и следствие
В задачах вроде поиска товара агент принимает несколько зависимых решений, но получает проверяемую награду только в конце. GRPO сравнивает итоговые результаты родственных траекторий и переносит преимущество успешной траектории на все сгенерированные токены. Поэтому полезный выбор и случайное действие внутри одной траектории получают одинаковое направление обновления.
Самодистилляция на данных текущей модели добавляет более плотный сигнал. Одна и та же модель играет две роли: агент видит обычную историю, а модель-учитель во время обучения получает дополнительную информацию о задаче. Разница между вероятностями их ответов показывает, какие действия стоит поддержать или ослабить.
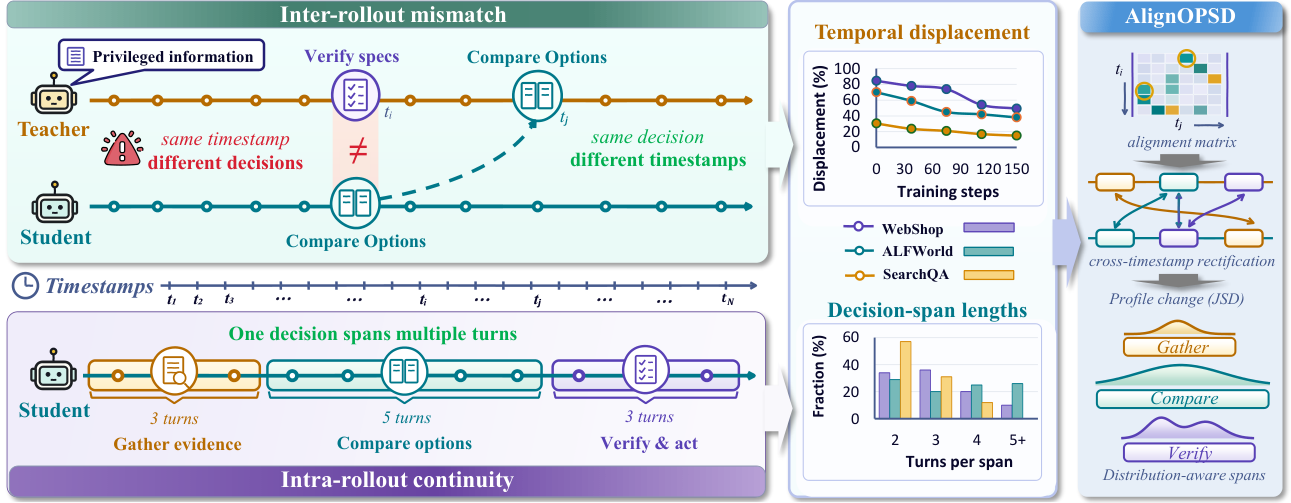
Проблема возникает, когда этот сигнал привязывают к позиции в истории. В одной траектории агент уже сравнивает варианты, а в другой на том же шаге ещё собирает сведения. Функционально одинаковое решение может появиться позже или растянуться на несколько ходов, поэтому оценка отдельного шага попадает не в тот контекст и не в тот временной отрезок.
Работа команды Beijing Advanced Innovation Center for Future Blockchain and Privacy Computing и Tsinghua University называет это несовпадением решения и временной позиции. Здесь важно не то, совпадают ли тексты или номера ходов, а решают ли два фрагмента одну и ту же подзадачу.
Как AlignOPSD находит границы решения
AlignOPSD сначала ищет функционально близкие фрагменты среди родственных траекторий одной задачи. След рассуждения агента служит приближённым описанием его текущего решения: замороженный семантический кодировщик переводит такие фрагменты в векторы, после чего метод сравнивает их близость. Дополнительный фильтр отбрасывает пары с несовместимыми действиями.
Затем модель заново оценивает тот же ответ агента, но подставляет истории, где другие траектории решали сходную подзадачу. Она не копирует найденный ответ, а вычисляет вероятность уже сгенерированного действия в нескольких подходящих контекстах. Чем увереннее совпадение, тем сильнее эта оценка корректирует локальную подсказку учителя; если подходящей пары нет, метод оставляет исходный сигнал.
На втором этапе AlignOPSD определяет длительность решения. Пока соседние ходы сопоставляются с похожими местами других траекторий, они входят в один отрезок. Резкая смена соответствий отмечает переход к следующему решению.
Итоговая награда становится общим бюджетом, который метод сначала делит между такими отрезками, затем между ходами и только после этого переносит на токены. Суммарное преимущество траектории сохраняется, но действия получают разный вес. Отдельную функцию потерь для дистилляции при этом не добавляют.
Метод проверяли на Qwen2.5-3B-Instruct и Qwen2.5-7B-Instruct. ALFWorld моделирует бытовые действия, WebShop — интерактивный выбор товара, а Search-QA — поиск ответа по внешним сведениям. Сравнение охватило GRPO, пошаговую самодистилляцию StepOPSD и другие варианты обучения с проверяемой наградой; обучение шло на одном узле с NVIDIA A800.
AlignOPSD полезен там, где награда приходит в конце
AlignOPSD обошёл GRPO и StepOPSD во всех восьми сводных сравнениях и занял первое место в шести. Адаптивные отрезки действительно различались между задачами: в ALFWorld одно решение занимало в среднем 4,41 хода, в WebShop — 3,92, а в Search-QA — 2,24. Единое окно фиксированной длины смешивало бы разные решения или разрезало одно решение на части.
Для команды, которая уже использует GRPO, работа предлагает не замену всей схемы, а другой слой распределения награды. Родственные траектории всё равно нужны для сравнения результатов; AlignOPSD дополнительно сопоставляет их по смыслу, повторно оценивает ответы и строит переменные границы решений.
Такой переход требует доступных следов рассуждения, дополнительной информации о задаче во время обучения и семантического кодировщика. При работе агента они не нужны: модель-учитель использует те же параметры, а сопоставление траекторий и распределение весов выполняются только при обучении.
Пока это основание для эксперимента, а не универсальная замена пошаговой оценке. Проверка охватывает одну линейку моделей и три среды с формально измеримым итогом; в статье нет сравнения времени или стоимости обучения. Если продукт уже может проверять конечный результат, но не умеет надёжно оценивать каждый промежуточный ход, AlignOPSD даёт конкретный способ проверить, теряет ли команда качество из-за привязки награды к номеру шага.
Источники
Иллюстрация: рисунок из статьи «Beyond Timestamps: Decision-Aligned On-Policy Distillation for Long-Horizon Agents», Mingju Chen, Can Lv, Jinrong Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


