
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Улучшения, которые LLM получает после обучения с подкреплением и проверяемой наградой (RLVR), удалось свести к небольшому набору направлений внутри модели и использовать их для защиты обучения от срыва. Работа USTC, Tencent Hunyuan и BUPT показывает, что Alpha-Stabler стабилизировал обучение на протяжении 2000 шагов, хотя препринт не рецензирован, а все числа в нём получили сами авторы. Для команд, которые самостоятельно дообучают модели через RLVR, это даёт способ заметить приближение коллапса и вмешаться без замены функции награды или оптимизатора.
Как векторы выявили компактную геометрию RLVR
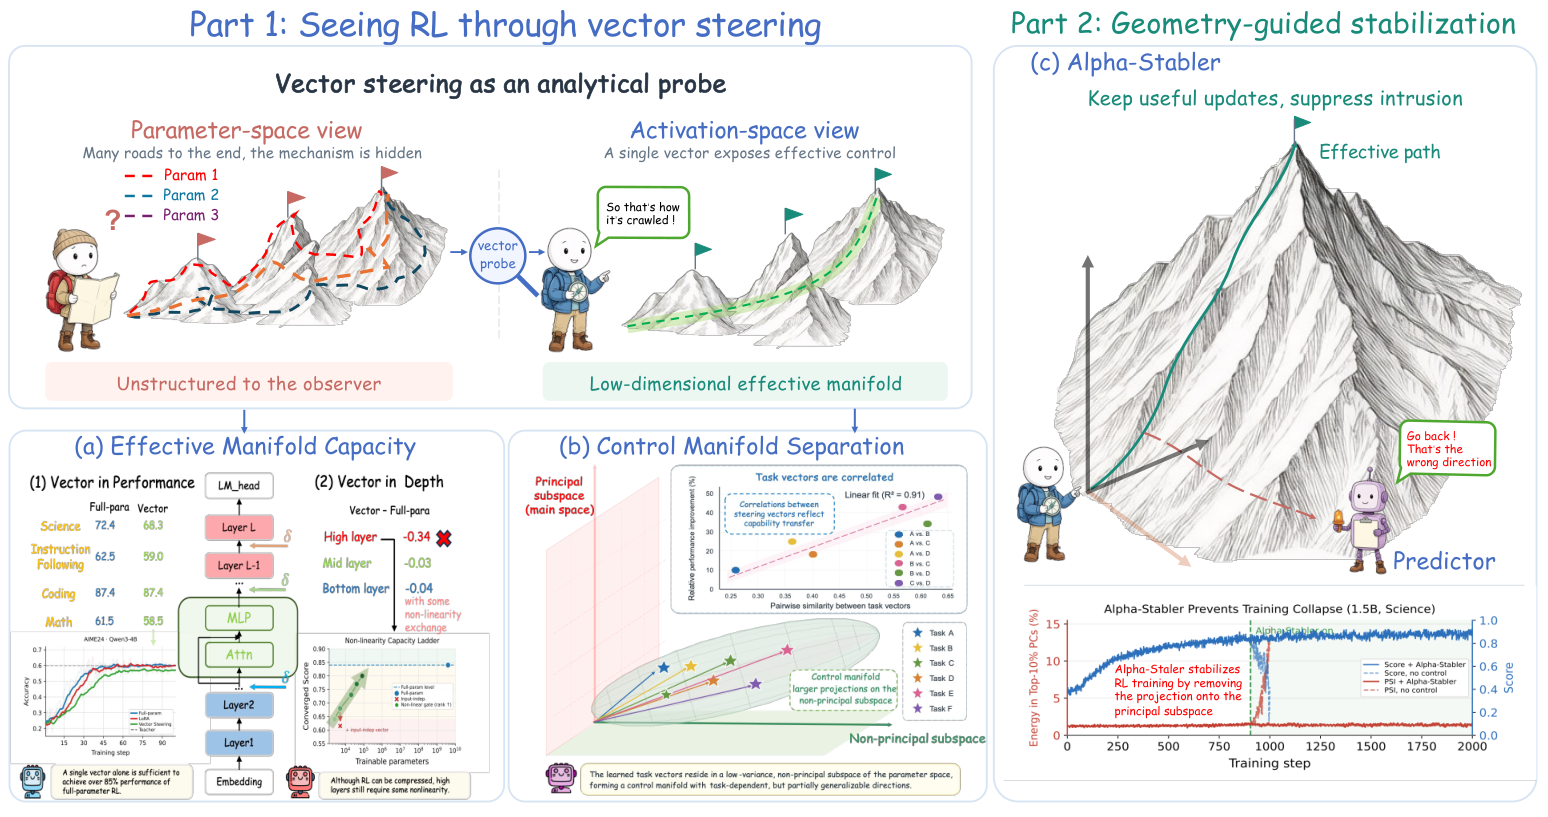
Авторы взяли базовую модель и её версию после RLVR, а затем заморозили все параметры базовой модели. Вместо обычного дообучения они добавляли к активациям выбранных слоёв по одному обучаемому вектору, общему для всех запросов и позиций токенов. Вектор учился воспроизводить ответы дообученной модели.
Такой жёстко ограниченный механизм восстановил более 85% прироста от RLVR в большинстве проверенных задач. Это означает, что полезное изменение поведения не распределено равномерно по всем параметрам: значительную его часть можно описать несколькими направлениями в пространстве активаций.
Сжатие работает не всегда одинаково. Фиксированные векторы справлялись лучше в нижних и средних слоях, а рядом с выходом их качество падало. Градиенты там не становились слабее — вмешательству не хватало способности менять поправку в зависимости от входа. Когда коэффициент вектора разрешили вычислять отдельно для каждого токена, качество выросло на всех проверенных верхних слоях.
Единственного правильного направления тоже не оказалось. В опыте на SciKnowEval первый вектор дал точность 67,5%, а восьмой, принудительно ортогональный семи предыдущим, — 62%. Значит, модель допускает несколько независимых способов вызвать близкое полезное поведение, хотя первое найденное направление обычно работает лучше остальных.
Границы проверки достаточно конкретны: эксперименты охватывают пять моделей из семейств DeepSeek-R1-Distill-Qwen и Qwen3, а также шесть задач с автоматически проверяемой наградой. Среди них были математика, научные вопросы, генерация кода и следование инструкциям; учителями служили модели, обученные через GRPO или DAPO. При большом различии между учителем и учеником полное дообучение работало лучше LoRA, а LoRA — лучше фиксированных векторов.
Почему движение в главном подпространстве предвещает коллапс
Авторы сравнили управляющие векторы с главным подпространством активаций — направлениями, вдоль которых внутренние представления меняются сильнее всего. Полезные поправки после RLVR в основном лежали вне него, в области с низкой изменчивостью. Направления сохранялись при разных настройках обучения одной модели и одной задачи, а их совпадение между задачами было связано с переносом навыков.
Во время успешного обучения сдвиги активаций оставались в этой низковариативной области. Перед ухудшением результата они начинали заходить в главное подпространство. На этом наблюдении построен Predictor: он сравнивает текущие сдвиги с подпространством, заранее вычисленным на замороженной базовой модели, и включает защиту при чрезмерном проникновении.
Защиту выполняет Controller. Во время обратного прохода он вычитает из градиента активаций компоненту, направленную вдоль главного подпространства, но сохраняет ортогональную часть. Прямой проход не меняется: генерация ответов, расчёт награды, функция потерь и оптимизатор продолжают работать как раньше.
В проверенных запусках рост показателя проникновения совпадал с резким падением качества. С Alpha-Stabler показатель оставался около раннего уровня, а результат продолжал расти. Проекция именно на главное подпространство работала лучше случайных направлений, других областей активаций и общего ограничения нормы градиента. При одинаковом фактическом времени траектории качества до момента обычного срыва почти совпадали, поэтому защита не замедляла начальное обучение заметным для этого опыта образом.
Кому стоит менять контур постобучения
Работа меняет планы прежде всего у команд, которые запускают длительное RLVR-постобучение и уже сталкиваются с внезапным падением награды или качества. Alpha-Stabler можно добавить как контроль обратного прохода: он не требует новых обучаемых параметров, другой архитектуры модели или переработки проверяющей функции.
Практический порядок действий следует разделить на два этапа. Сначала показатель проникновения можно использовать только как диагностику и сопоставить его всплески с собственными срывами. Если связь повторяется, следующим экспериментом становится проекция градиента с включением по сигналу Predictor, а не постоянное подавление направлений с начала обучения.
Переносить вывод на любое дообучение LLM пока рано. Геометрию проверяли на задачах с формально проверяемой наградой, но не на RLHF с человеческими предпочтениями, многошаговых агентах и открытой генерации. Командам, которые используют готовый API или ограничиваются обучением с учителем, работа не даёт непосредственной причины менять стек.
Главный инженерный вывод уже применим в пределах исследованного режима: коллапс RLVR можно искать не только в динамике награды, энтропии или нормы градиента. Изменение того, в какую область активаций направлено обучение, даёт отдельный ранний сигнал и позволяет ограничить конкретную опасную компоненту, не подавляя весь шаг оптимизации.
Источники
Иллюстрация: рисунок из статьи «Learning to Steer, Steering to See: Unveiling the Geometry of RLVR in Large Language Models via Trainable Vectors», Yuchen Cai, Ding Cao, Qixiang Yin и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


