
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Одну модель управления роботом научили собирать разные детали без демонстраций, прописанных этапов и подсказок о промежуточном прогрессе. В препринте NVIDIA и University of Washington, который не рецензировали, все замеры провели сами авторы: AlphaNIST достиг 98,2% успешных сборок на всех 20 задачах стенда NIST Assembly Task Board #1. Результат показывает, что разнообразие задач и масштаб обучения могут заменить часть ручной настройки награды.
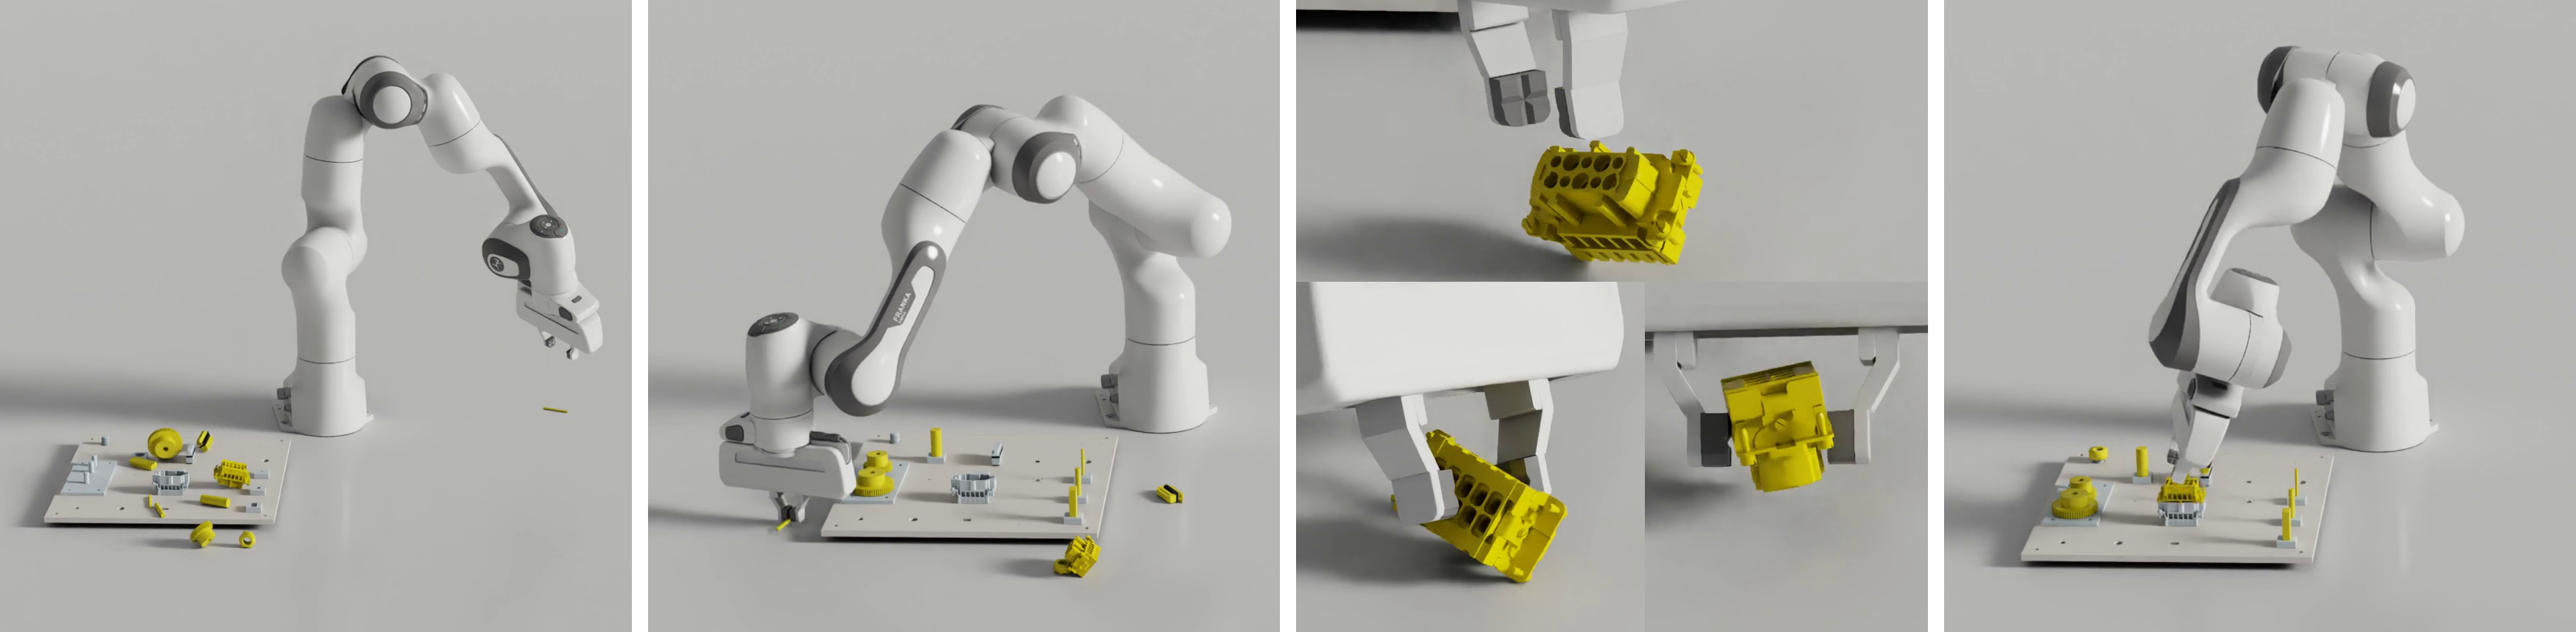
Модель обучали с подкреплением по общему правилу: она получала единицу только за полностью собранное соединение, а до этого — ноль. Небольшие штрафы ограничивали резкие движения, скорость суставов и усилие, но не подсказывали, как продвигаться к цели. Одна модель принимала облако точек детали и стенда, а затем управляла манипулятором Franka Panda.
Одного сигнала «готово» всё же было недостаточно. AlphaNIST использует банк стартовых состояний — от лежащей на столе детали до частично выполненной сборки — и чаще выбирает состояния, где модель уже иногда справляется, но ещё ошибается. При обучении в 64 тыс. параллельных копий среды общая модель достигла 98,2%, отдельные модели для каждой задачи — в среднем 81,4%, причём им потребовалось в 39 раз больше GPU-часов.
Разреженная награда обошла и ручные подсказки за приближение к детали и правильную ориентацию. На крупнейшем запуске с 256 тыс. копий среды доля успешных сборок составила 97,4% против 77,4%. Модель сама научилась перекладывать детали, использовать стенд для разворота, постукивать по гайке и возвращаться к отложенной операции.
Все проверки прошли в симуляции на задачах NIST Assembly Task Board #1. В отдельном опыте модель собирала до 10 пар за эпизод без заданного порядка и получала награду только после завершения всей серии; на максимальной длине она справилась в 84% случаев. Эти результаты показывают обучаемость подхода, но ещё не подтверждают его надёжность на физическом стенде.
Источники
Иллюстрация: рисунок из статьи «AlphaNIST: Emergent Assembly Skills from Binary Task Rewards», Octi Zhang, Iretiayo Akinola, Rosario Scalise и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


