
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-ассистента научили искать редкие факты в длинной истории диалогов, не загружая её целиком в контекст. В препринте JPMorgan Chase, который не прошёл рецензирование и приводит числа, полученные самими авторами, APDMem обращается в среднем только к 8% прошлых бесед и при этом точнее ближайшего конкурента. Для команд это готовая схема памяти: сначала искать по сводкам, а к исходным сообщениям переходить только ради точной формулировки или недостающего факта.
Память хранит и сводку, и исходный диалог
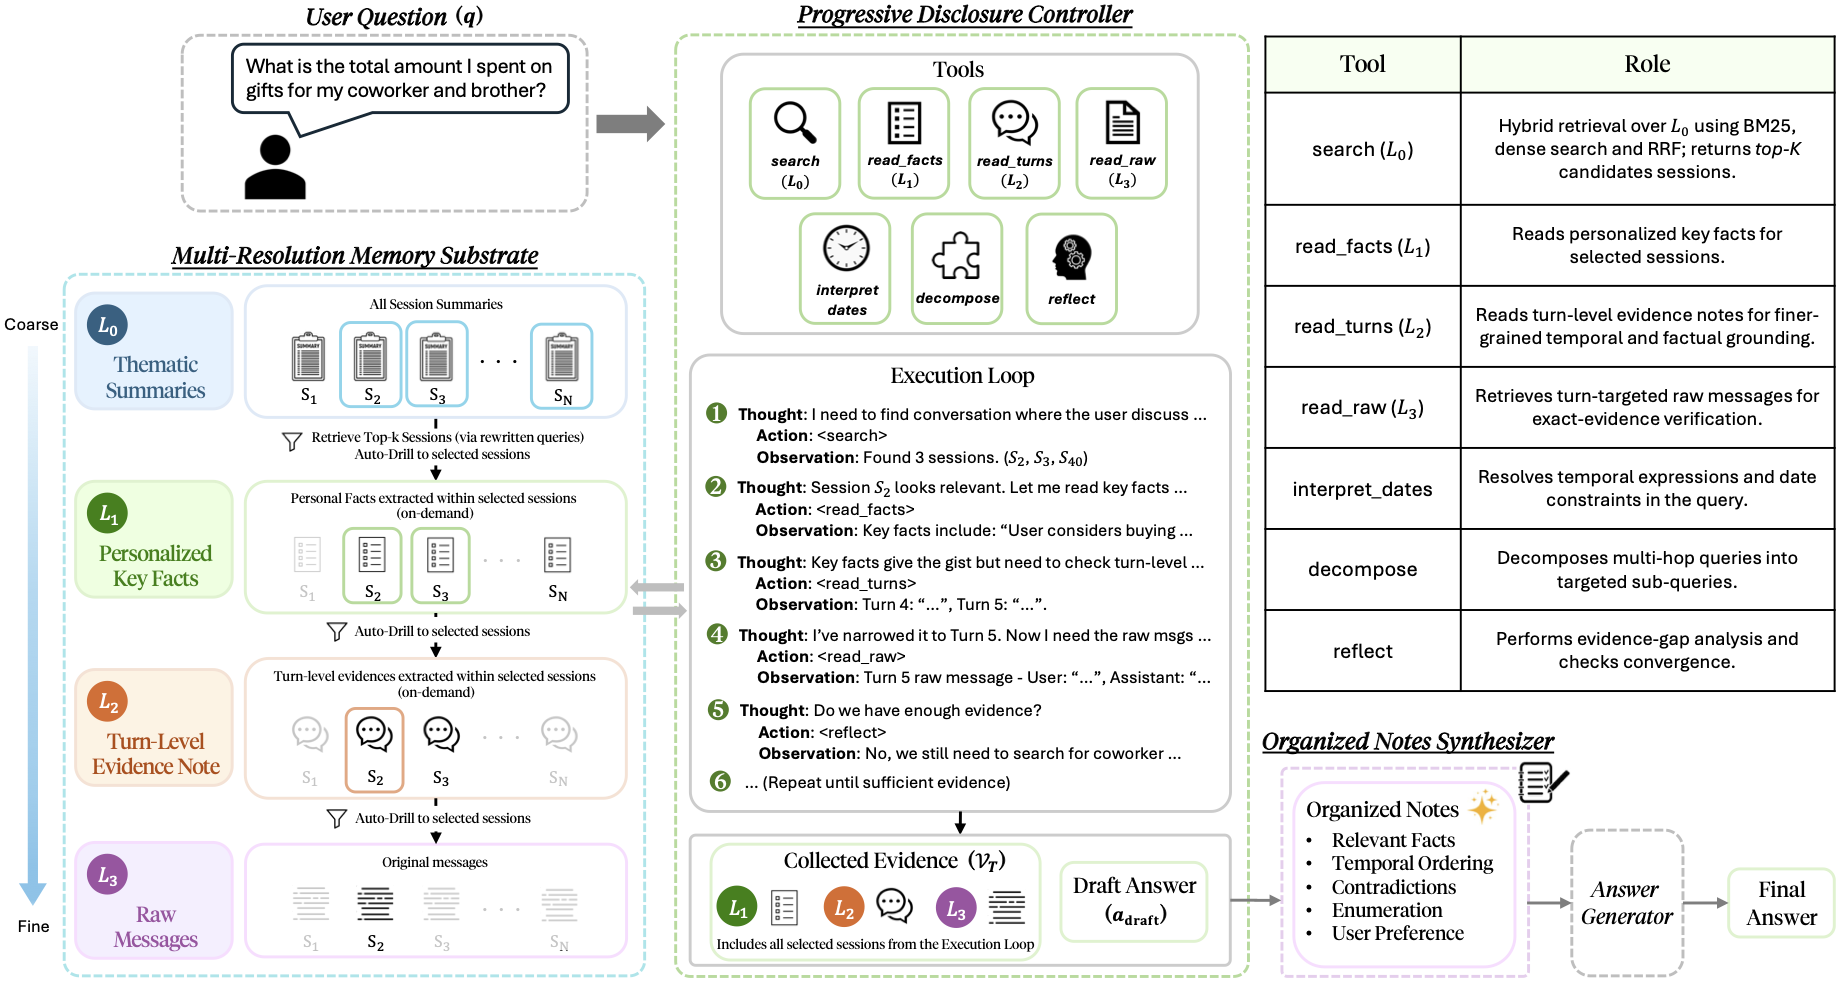
APDMem представляет каждую сессию четырьмя слоями. L0 содержит темы, нормализованные даты, ключевые слова и метки. L1 выделяет сведения о пользователе: предпочтения, планы, ограничения и рекомендации. L2 раскладывает факты по репликам и сохраняет их временной порядок. L3 хранит исходные сообщения без пересказа.
При загрузке истории система создаёт только тематическую сводку и сохраняет оригинал. Слои с ключевыми фактами и заметками по репликам она генерирует при первом обращении, а затем кеширует. Такой порядок переносит часть расходов с записи на чтение и не тратит токены на подробное преобразование сессий, которые могут никогда не понадобиться.
Поиск начинает контроллер. Он приводит относительные даты вроде «прошлым летом» к конкретному периоду, делит составной запрос на части и выбирает подходящие сессии по верхнему слою. Если тематической сводки мало, контроллер последовательно запрашивает факты, заметки по репликам и оригинал диалога.
После каждого прохода контроллер проверяет, хватает ли доказательств для ответа и даст ли продолжение поиска новую информацию. Цикл заканчивается, когда данные перестают меняться или исчерпан лимит шагов. Затем отдельный компонент собирает найденное в заметку: сводит факты, выстраивает события по времени, отмечает противоречия и передаёт результат генератору ответа.
Один пример из работы показывает смысл такого спуска. По сводке система нашла разговор о десертах в Орландо, но там не было названия заведения. Слой фактов подтвердил тему, заметки указали нужную реплику, а исходное сообщение вернуло точное название: Sugar Factory at Icon Park.
Большинство запросов не доходит до исходных сообщений
APDMem проверяли на 500 вопросах LongMemEval-S. Набор включает поиск фактов в одной сессии, объединение сведений из разных разговоров, обновление знаний, временные зависимости и воспроизведение предпочтений. В качестве основы использовали GPT-4.1 и GPT-4.1-mini, а ответы проверяла модель-оценщик по единому протоколу.
С GPT-4.1 система получила точность 87,8% против 84,0% у SimpleMem, ближайшего из сопоставленных вариантов; разница статистически значима. При этом контроллер углублялся в среднем лишь в 8% сессий из доступной истории.
Большинство проходов заканчивалось на слое ключевых фактов. До исходных сообщений доходили 20,2% проходов — чаще там, где требовалось восстановить точное название или формулировку. Для вопросов по нескольким сессиям контроллер обычно расширял поиск по верхним слоям, а для локальной детали углублялся внутри одной беседы.
Сравнение компонентов подтверждает, что результат даёт не только иерархия. Статический поиск по тем же слоям ошибался чаще, а поиск исключительно по исходным сообщениям уступал ещё сильнее. Наибольший вклад среди управляющих инструментов внесла повторная проверка достаточности найденных сведений.
Архитектуру стоит проверять до перехода на граф памяти
Работа меняет планы команд, которым нужен персональный ассистент с длинной историей, но не обязательно сложный граф сущностей и связей. APDMem сохраняет память в прозрачных слоях Markdown и не заменяет оригинальные сообщения сжатым пересказом. Это позволяет начать со сводок и ленивого построения деталей, сохранив путь к первоисточнику.
В прототипе стоит отдельно измерять три этапа: попала ли нужная сессия в выдачу по сводкам, выбрал ли контроллер достаточную глубину и смог ли генератор использовать найденное. Иначе ошибка верхнего слоя будет выглядеть как ошибка модели ответа. Авторы отдельно отмечают, что пропущенная при составлении сводки деталь может понизить позицию всей сессии и закрыть доступ к правильному фрагменту.
Ленивое построение промежуточных слоёв создаёт задержку при первом чтении. Системы с жёсткими требованиями к времени ответа могут заранее прогревать вероятные сессии, а остальные оставлять для обработки по запросу. Лимит итераций контроллера также нужен как явная граница стоимости и задержки, а не только как защита от зацикливания.
Проверка пока охватывает один набор длинных диалогов и семейство моделей OpenAI. APDMem также не строит явные связи между сессиями, поэтому работа обосновывает прототип для разреженного поиска по истории, но не заменяет проверку на собственных диалогах, типах запросов и требованиях к задержке.
Источники
Иллюстрация: рисунок из статьи «APDMem: Agent-Controlled Progressive Disclosure for Query-Adaptive Long-Term Memory», Chin-Lun Fu, Anagha Kulkarni, Hong Ni и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


