
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
APEX ускоряет генерацию LLM, не заставляя систему заранее выбирать одну стратегию и глубину черновика на весь ответ. В нерецензированном препринте University of Illinois Urbana-Champaign и AWS AI, где числа получили сами авторы, профиль APEX-S ускорил Qwen3-8B в среднем в 4,27 раза относительно последовательной генерации. Для команд, которые обслуживают разные типы запросов, работа предлагает разделить два решения: способ подготовки черновика выбирать перед запросом, а его длину менять уже по ходу ответа.
Один запрос получает стратегию, каждый блок — свою глубину
При спекулятивном декодировании дешёвый механизм заранее предлагает блок токенов, а основная модель проверяет их параллельно. Если она отклоняет токен в начале блока, следующие предложения тоже приходится выбросить. Поэтому длинный черновик может сократить число обращений к модели, но только когда значительная его часть проходит проверку.
APEX сначала выбирает для запроса один из трёх механизмов. EAGLE-3 строит продолжение по внутренним представлениям основной модели, n-gram копирует подходящие последовательности из доступного текста, а отдельная модель-черновик генерирует собственное продолжение. Эти варианты различаются не только точностью предложений, но и временем, которое тратят на их подготовку.
APEX-Router принимает решение по признакам исходного запроса: его длине, повторяемости, распределению вероятностей токенов и настройкам генерации. Вместе с механизмом он задаёт начальную глубину. Выбранный механизм не меняется до конца запроса, поскольку его переключение затрагивает размещение моделей, пакетную обработку и маршрутизацию между вычислителями.
После каждой проверки APEX-Depth может сократить или увеличить следующий черновик. Контроллер учитывает пройденную часть ответа, свойства текущего контекста и историю последних проверок: сколько токенов принимала модель, где появлялся первый отказ и как часто проходил весь блок. Во время генерации параметры контроллера не обновляются — меняется только состояние, на основании которого он принимает следующее решение.
Вероятность отказа важнее средней доли принятых токенов
Средняя доля принятых предложений не показывает, стоит ли продолжать черновик дальше. Полностью принятый блок говорит лишь о том, что все предложенные токены прошли проверку. Он не раскрывает, на какой позиции основная модель отклонила бы более длинное продолжение.
APEX рассматривает длину принятой части как неполное наблюдение. Для каждой следующей позиции контроллер оценивает риск первого отказа, а затем выводит ожидаемую длину полезного продолжения. Полностью принятые блоки при этом не считаются доказательством, что черновик можно без потерь расширять дальше.
Отдельная модель оценивает время подготовки и проверки блока. Это позволяет различать две внешне похожие ситуации: точный, но дорогой механизм может проиграть более грубому варианту, который быстрее предлагает токены. Итоговая оценка действия учитывает пропускную способность, принятый прогресс и долю выброшенного черновика.
Такой способ обучения требует журналов выполнения. В них должны сохраняться выбранная глубина, позиция первого отказа, время блока и число принятых токенов. Проверка компонентов показала, что особенно важна недавняя история ответов проверяющей модели: без неё контроллер чаще выбирал безопасные короткие черновики, но почти терял ускорение.
Работа меняет схему эксперимента, но не даёт универсальной настройки
На отдельных нагрузках APEX достиг ускорения в 5,24 раза. Профиль APEX-B выбрал более осторожную точку: он ускорил генерацию в среднем в 3,27 раза и сократил относительную долю выброшенных токенов на 41% по сравнению с n-gram фиксированной глубины.
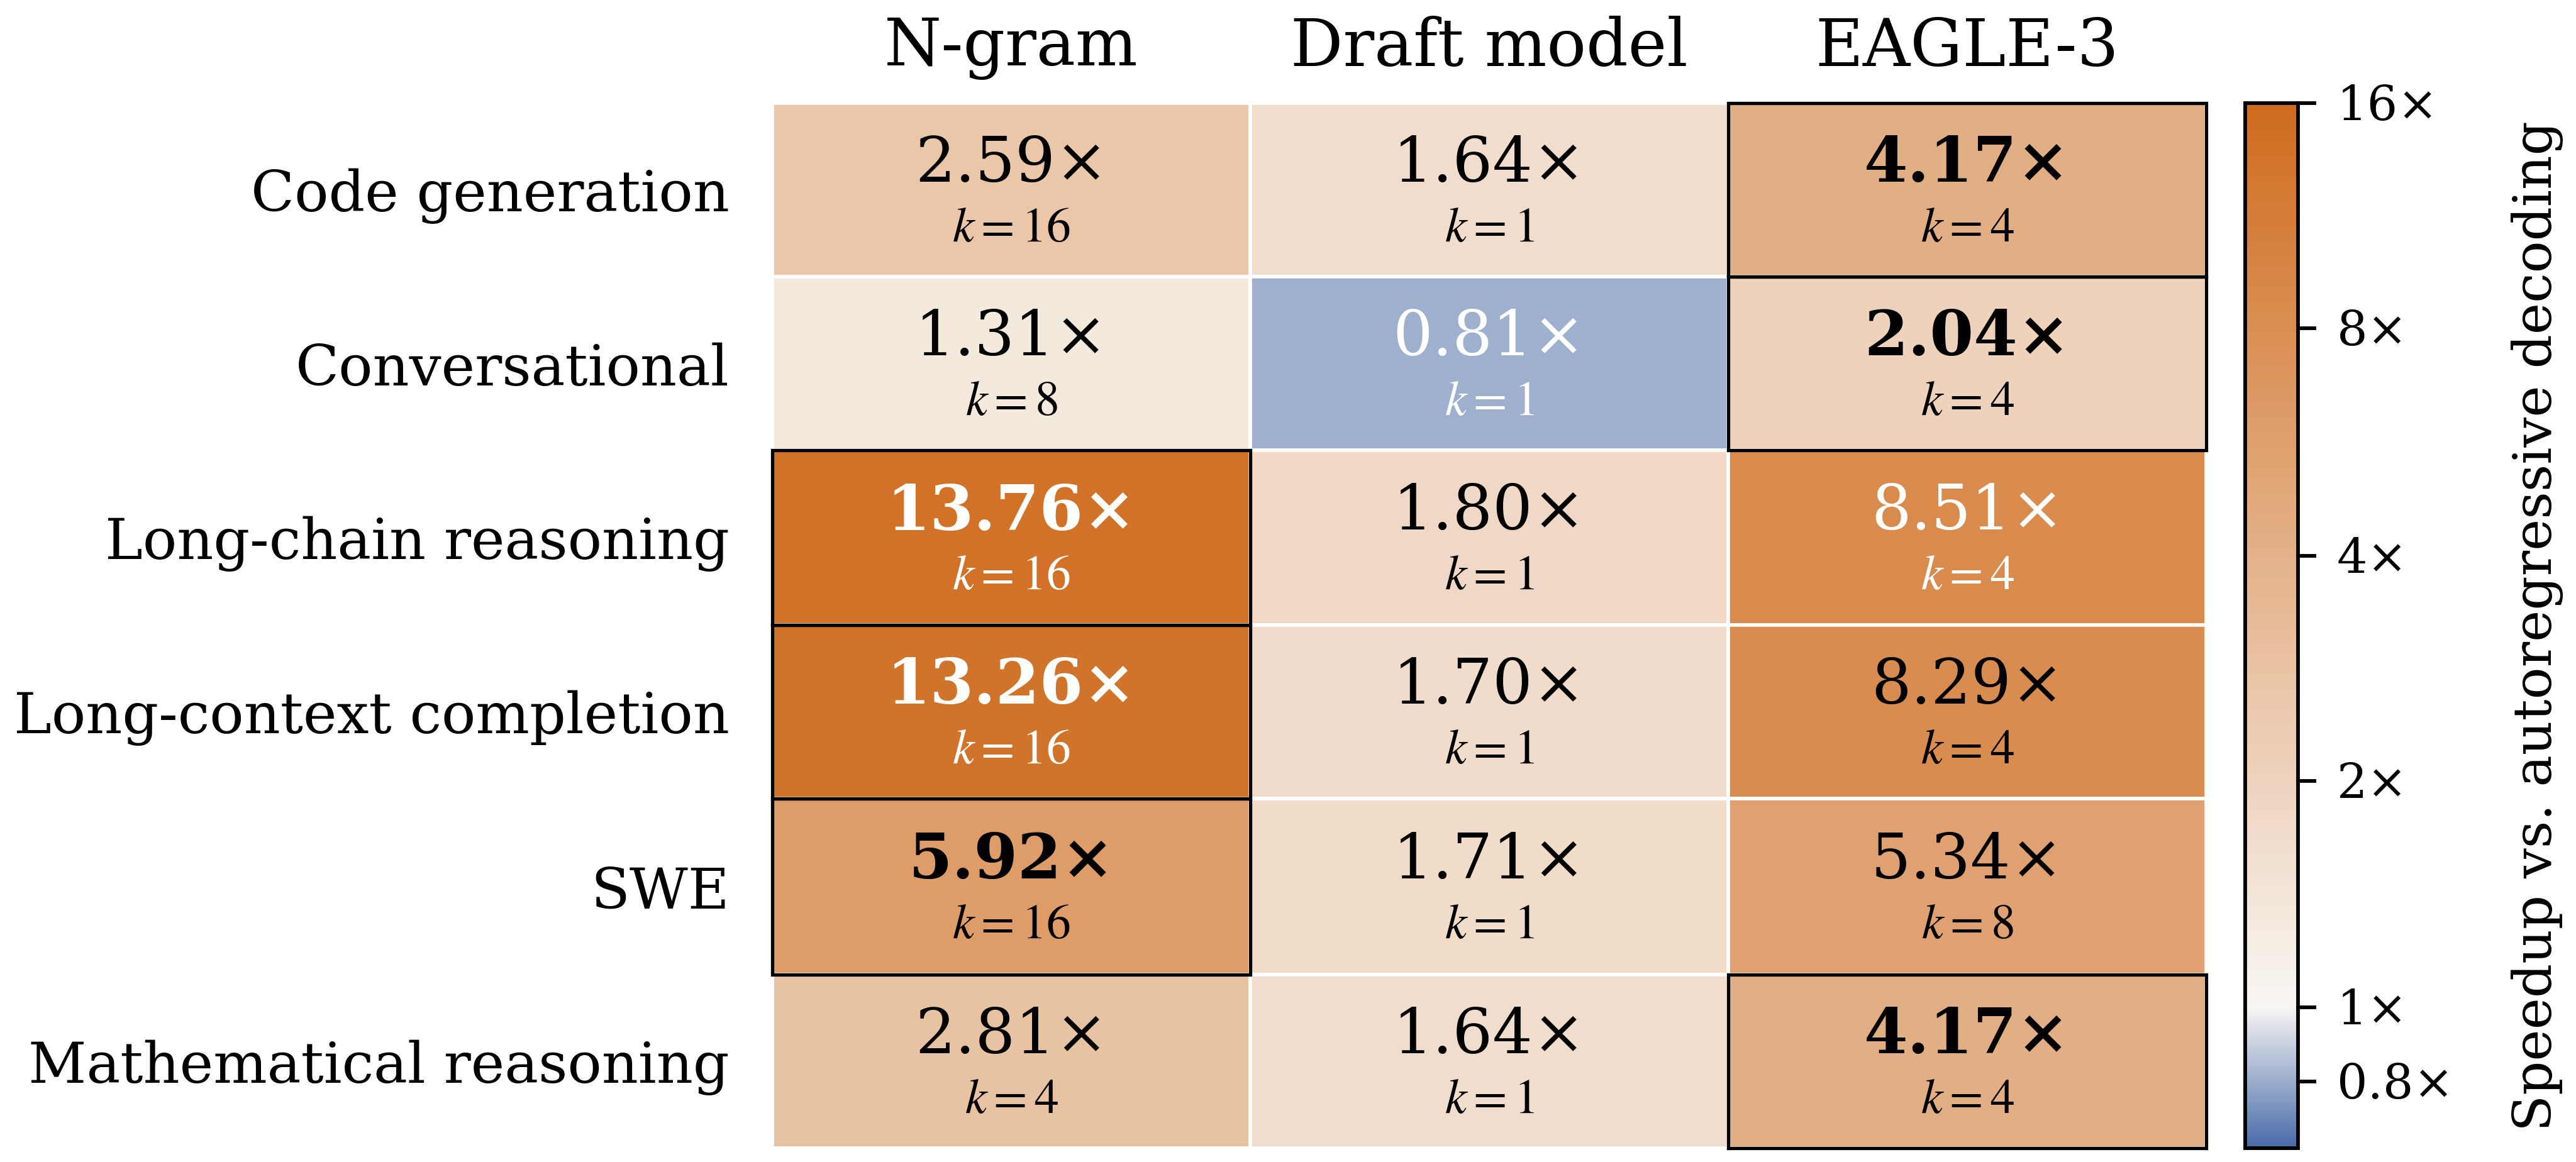
Лучший вариант зависел от задачи. На генерации кода фиксированный n-gram оказался быстрее и экономнее профилей APEX. На длинных продолжениях тот же механизм давал максимальную скорость, но адаптивный профиль лучше сочетал скорость с использованием черновых токенов. Поэтому контроллер не заменяет сравнительное тестирование на собственной смеси запросов.
Проверка охватывает Qwen3-8B в vLLM и задачи на генерацию кода, математические рассуждения, длинный контекст, длинные цепочки рассуждений, диалоги и работу с программными проектами. APEX сравнивали с обычной последовательной генерацией и фиксированными настройками тех же механизмов. Эти границы позволяют оценить сам принцип управления, но не переносить найденные профили напрямую на другую модель или инфраструктуру.
Для команды практический вывод состоит не в том, чтобы всегда добавлять обучаемый контроллер. Сначала стоит измерить первый отказ, время блока и долю выброшенных токенов при нескольких глубинах. Если один дешёвый механизм стабильно выигрывает на однородном потоке, фиксированная настройка останется проще. Если запросы различаются по повторяемости и предсказуемости, архитектура APEX даёт основу для двухуровневого управления без изменения процедуры проверки основной моделью.
Источники
Иллюстрация: рисунок из статьи «APEX: Speculate smarter, not deeper», Manvi Jha, Zach Zhang, Zhichao Xu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


