
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
На ARC-AGI-2 качество открытых моделей сильнее подняли реальные примеры и организация запуска, чем крупный синтетический набор. В работе Nguyen Minh Thang и Trinh Thi Phuong лучший вариант набрал 56,67 балла, хотя работа не рецензирована и числа в ней получены самими авторами. Для продукта с жёстким бюджетом вычислений это смещает приоритет с генерации данных на планировщик, проверку ответов и управление памятью.
Синтетические задачи прошли строгий отбор, но не улучшили модель
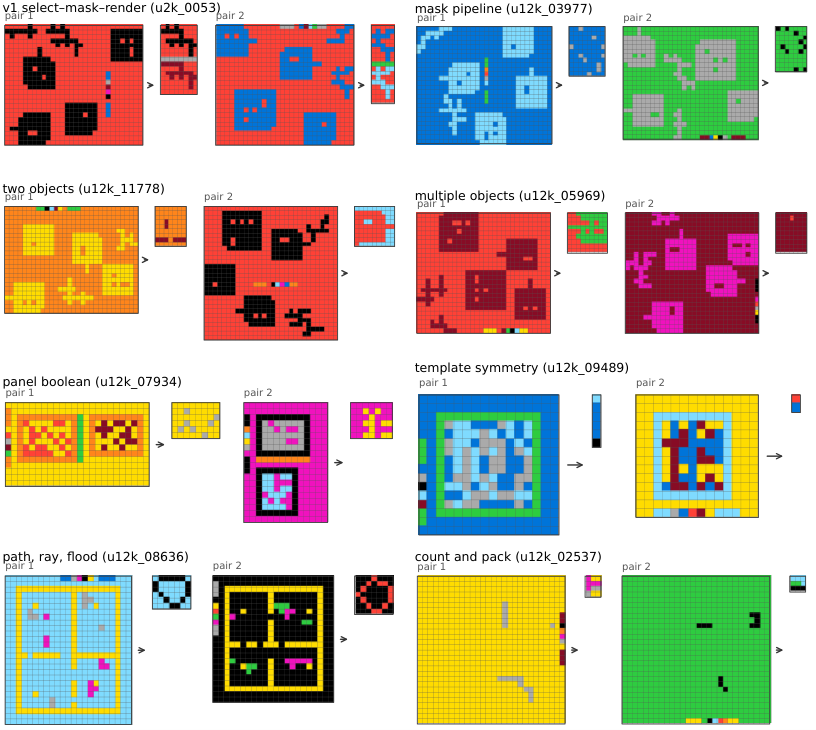
ARC-AGI-2 проверяет, может ли система вывести правило преобразования цветной решётки из нескольких примеров и построить точный ответ для нового входа. Частично правильный результат не засчитывается, поэтому модель должна не просто найти похожий шаблон, а применить верное правило целиком.
Для NVARC Qwen3-4B подготовили 95 993 синтетические задачи. Их строили из исполняемых правил на специализированном языке: каждое правило проверяли на наборе пробных решёток, а задачу принимали только тогда, когда примеры отсекали близкие альтернативы и простые обходные решения вроде копирования, замены цветов или поворота.
Такая фильтрация делает набор разнообразнее на уровне поведения, но не гарантирует перенос на реальные задания ARC. Ни один вариант, обученный на синтетическом корпусе отдельно или вместе с исходной моделью, не превзошёл вариант на реальных данных.
Дообучение на 1 920 записях реальных задач подняло средний результат с 28,96 до 33,06 балла. Разрыв показывает, что формальная уникальность правил и отсутствие простых подсказок ещё не делают синтетические примеры похожими на целевое распределение задач.
Планировщик запросов дал рассуждающей модели основную прибавку
Qwen3.8-27B дообучили на 1 036 собственных цепочках рассуждений, где итоговый ответ совпадал с известным. Добавление решений других моделей, программных целей и синтетических задач проверяли отдельно, но основную прибавку обеспечило не расширение обучающего набора, а процедура запуска.
Лимит рассуждения закрепили внутри сервера, чтобы модель завершала ответ в отведённом бюджете. Для каждого входа сначала запускали одну длинную попытку и только затем распределяли оставшееся время на повторные. После ответа модель также писала программу на Python, которую автоматически проверяли на демонстрационных примерах.
Вместе эти изменения подняли результат с 26,81 до 44,03 балла. Принудительно оборванные рассуждения редко давали правильный ответ, поэтому планировщик стремился довести больше первых попыток до естественного завершения, а не потратить бюджет на несколько незаконченных.
У Qwen3.8-Flash-Next узким местом стала память. Это модель со смесью экспертов: для каждого токена она включает только часть специализированных блоков, но веса всех блоков всё равно занимают GPU. Команда удалила редко полезные эксперты, скорректировала выбор по маршрутам токенов из задач ARC и сохранила блоки, нужные для программного вывода. Освободившаяся память увеличила кэш ключей и значений, поэтому сервер мог одновременно вести больше длинных рассуждений.
Командам стоит сначала измерить весь контур запуска
Работа меняет планы там, где модель решает пакет проверяемых задач под общим лимитом времени. Перед генерацией большого синтетического корпуса имеет смысл отдельно измерить, сколько запросов завершаются естественно, как бюджет распределяется между первой и повторной попытками и можно ли проверить промежуточный программный результат.
Практический порядок экспериментов следует из самих сравнений: сначала зафиксировать воспроизводимый набор задач и точную проверку ответа, затем настроить лимиты и очередь запросов, после этого проверить дообучение на собственных успешных решениях. Синтетические данные стоит добавлять только вместе с отдельным тестом переноса на целевые задачи, иначе их формальное разнообразие может не дать прибавки.
Для моделей со смесью экспертов работа предлагает ещё один путь: калибровать удаление блоков на запросах из целевой области и учитывать формат ответа. Частота использования сама по себе оказалась слабым критерием; полезнее сочетать её с оценкой вклада эксперта и сохранять блоки, которые обслуживают программные токены.
Эксперименты проводили на вариантах Qwen в автономном режиме на четырёх NVIDIA L4 не дольше 12 часов. Результаты относятся к скрытой полуприватной части ARC-AGI-2; перенос на другие области в работе не проверяли. Поэтому это не общий вывод о бесполезности синтетических данных, а свидетельство того, что при фиксированном вычислительном бюджете качество всего контура может влиять сильнее очередного набора для дообучения.
Источники
Иллюстрация: рисунок из статьи «Rules, Traces and Routing Statistics: Training and Calibration Data for Open Models on ARC-AGI-2», Nguyen Minh Thang, Trinh Thi Phuong, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


