
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Нежелательные знания LLM удалось подавить, почти не затронув ответы на остальные запросы. В препринте University of North Carolina at Chapel Hill, Honda Research Institute и Michigan State University, который не прошёл рецензирование и где все числа получили сами авторы, ARIA снизила точность на WMDP-cyber до 0%. Для команд это превращает машинное забывание из переписывания модели в отдельный слой контроля во время генерации.
Как детектор находит нежелательное состояние
Обычные методы машинного забывания меняют веса модели. Один и тот же набор изменённых параметров затем должен скрывать выбранные знания и сохранять остальные способности. Если правка слишком сильная, модель хуже справляется с обычными задачами; если слабая, нежелательный ответ можно восстановить другим запросом или дополнительным обучением.
ARIA оставляет веса LLM неизменными. Разреженные автокодировщики преобразуют активации выбранных слоёв в набор латентных признаков: каждый из них соответствует повторяющемуся шаблону во внутреннем состоянии модели. Автокодировщики заранее обучают на общем корпусе, а затем замораживают вместе с основной моделью.
Поверх этих признаков обучают разреженный линейный классификатор. Ему показывают траектории генерации для знаний, которые нужно скрыть, и для запросов, поведение на которых следует сохранить. Классификатор учитывает, как часто срабатывает признак, насколько сильным было его максимальное значение и проявился ли он в первых 64 токенах ответа.
Во время генерации статистика обновляется после каждого токена. Если оценка превышает заданный порог, ARIA заменяет продолжение ответом «I don’t know»; в остальных состояниях модель использует исходное распределение следующего токена. Порог настраивают по сохранённым примерам: его снижение усиливает блокировку, а повышение сокращает ошибочные срабатывания на допустимых запросах.
Эта схема делает источник ошибок явным. Пропущенное нежелательное состояние приводит к утечке, а ошибочно заблокированное допустимое состояние ухудшает полезность. Весовые методы не дают такого же прямого соответствия, поскольку одна правка параметров одновременно влияет на множество типов запросов.
Что показало разделение детектора и модели
На DeepSeek-R1-Distill-Qwen-1.5B потеря качества по MMLU составила 0,50 процентного пункта против 6,51 у агрессивного весового метода GA. На R-TOFU показатели подавления правильного ответа и утечек в рассуждении превысили 97%, тогда как следующий результат RMU был около 73%. Разница показывает, что детектор блокировал не только финальную фразу, но и промежуточную цепочку рассуждения.
После забывания модель проверили повторной генерацией, изменёнными формулировками запросов и дополнительным обучением. Во всех этих сценариях результат на скрываемых знаниях менялся менее чем на 1 процентный пункт. Это не доказывает, что знания исчезли из весов: ARIA закрывает к ним доступ, пока запрос и генерация проходят через её детектор.
Проверка охватывает две открытые модели: рассуждающую DeepSeek и инструкционную Gemma. Эксперименты проведены на трёх наборах задач: TOFU с вымышленными авторами, R-TOFU с оценкой цепочек рассуждения и WMDP-cyber с вопросами по кибербезопасности; общую полезность в последнем случае измеряли по MMLU.
Разбор срабатываний выявил ещё одну границу метода. Один из признаков реагировал на уверенные начала ответа вроде «The correct answer is», хотя они не относились к кибербезопасности. Детектор может выучить стиль примеров вместо целевого знания, поэтому состав набора для забывания напрямую влияет на ложные блокировки.
Когда ARIA меняет архитектурный план
Подход подходит для продукта, где требования к запрещённым темам меняются после развёртывания модели. Вместо новой версии весов команда может обучить отдельный детектор, подобрать порог и подключить вмешательство к декодированию. Исходная модель при этом остаётся прежней, что упрощает откат и сравнение политик доступа.
Однако это не удаление данных из модели. Если требование предполагает передачу очищенных весов третьей стороне или гарантирует отсутствие знания без внешнего слоя, ARIA его не выполняет: без детектора базовая LLM отвечает как раньше.
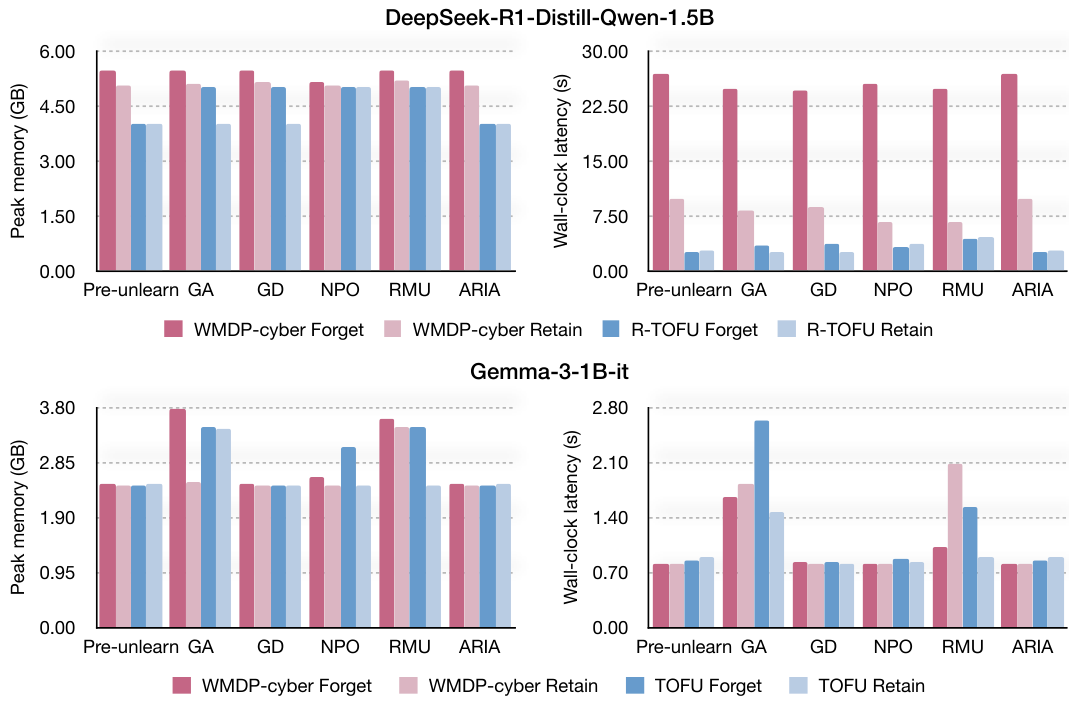
Схема также рассчитана на контур, где команда управляет скрытыми активациями и процессом декодирования. Для неё нужны автокодировщики выбранных слоёв, потоковый расчёт признаков и вмешательство до выбора следующего токена. В работе эти операции объединили в CUDA-ядре, поэтому описанный вариант ближе к собственной инфраструктуре с открытыми весами, чем к подключению модели через закрытый API.
Практический сдвиг состоит не в новом способе стереть фрагмент памяти, а в возможности отделить модель от политики доступа к её знаниям. Такой слой можно рассматривать как управляемый предохранитель, но его надёжность определяется качеством детектора и тем, насколько рабочие запросы похожи на примеры, использованные при настройке.
Источники
Иллюстрация: рисунок из статьи «Test-Time Unlearning via Sparse Autoencoder», Pingzhi Li, Jinhao Duan, Vaishnav Tadiparthi и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


