
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Эффект учебной подсказки научились сохранять и без самой подсказки при работе LLM. В препринте University of Notre Dame, который не рецензировался и приводит замеры самих авторов, ASH прибавил 2,60 процентного пункта к среднему результату Qwen3-1.7B-Base против прежних вариантов обучения с подсказкой. Для команд, дообучающих модели рассуждать, это снимает разрыв между учебным и рабочим контекстом ценой полуторакратного времени обучения.
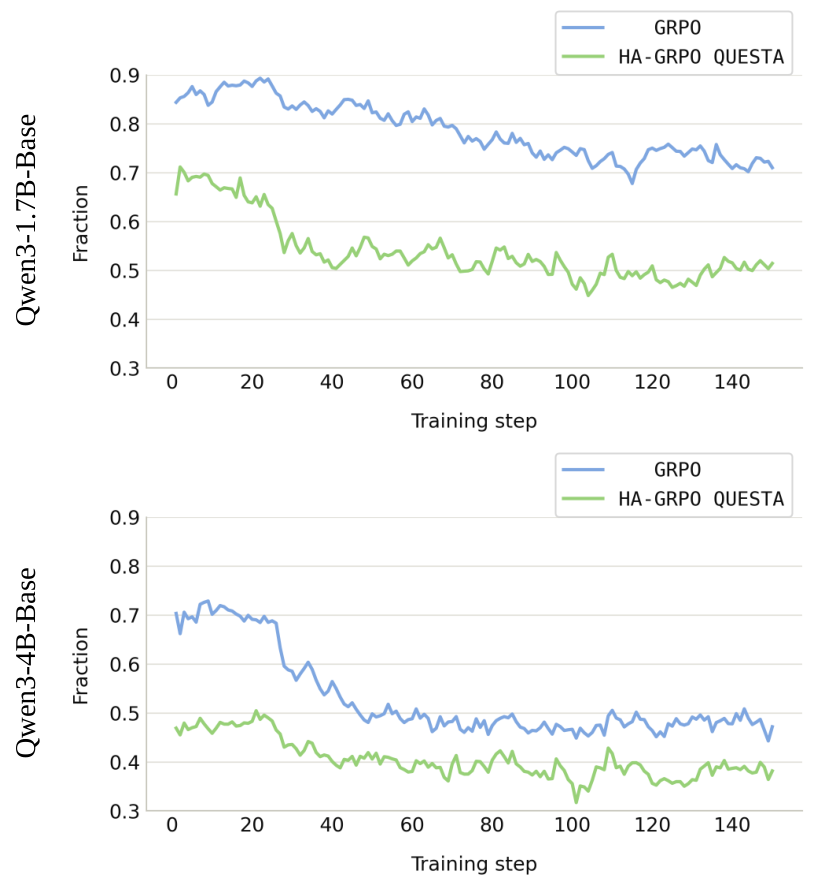
Обычный GRPO перестаёт учиться на слишком сложном вопросе: если все ответы группы неверны, они получают одинаковую нулевую награду, поэтому модель не получает сигнал для обновления. Методы с подсказкой добавляют к вопросу часть эталонного решения, но при использовании модели такого решения уже нет. В опыте с QUESTA удаление подсказки снизило долю успешных решений Qwen3-1.7B-Base на 27,34 процентного пункта.
ASH обучает модель одновременно на вопросах с подсказкой и без неё. Перед обновлением модели метод настраивает управляющий вектор, который выделяет общий сдвиг поведения под действием подсказки. При работе этот вектор добавляют во внутренние активации одного слоя на каждом шаге генерации, поэтому текст подсказки в запросе больше не нужен.
Результат измеряли через pass@8 — долю задач, где хотя бы одна из восьми попыток верна. ASH улучшил этот показатель на всех проверенных сочетаниях моделей и тестов; для Qwen3-4B-Base средний выигрыш над прежними методами с подсказкой составил 2,21 процентного пункта. Управляющий вектор, обученный на математике, также повысил результаты на LogiQA и LiveCodeBench-v5 без дополнительного обучения.
Метод проверяли на Qwen3-1.7B-Base, Qwen3-4B-Base, Llama-3.2-1B-Instruct и Llama-3.2-3B-Instruct. Основная оценка охватывала AMC, OlympiadBench, AIME24, AIME25, Minerva и GPQA-Diamond; сравнивали с GRPO, QUESTA, SAGE и HILL. Таким образом, работа показывает результат на компактных открытых моделях и задачах с автоматически проверяемыми ответами.
Источники
Иллюстрация: рисунок из статьи «Get Hint-Augmented GRPO Done Right Through Activation Steering», Khiem Le, Ting Hua, Nitesh V. Chawla, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


