
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Декодирование LLM с длинным контекстом ускорили, позволив запросам внутри одного пакета работать в разном ритме. В нерецензированном препринте, где все числа получили сами авторы, ASPIRE выдавал в 1,70–4,58 раза больше токенов за единицу времени, чем обычное авторегрессионное декодирование, а среднее ускорение относительно сильнейших прежних методов выросло примерно на 27%. Это даёт серверным командам новый вариант оптимизации без отдельной черновой модели и без изменения распределения ответов целевой модели.
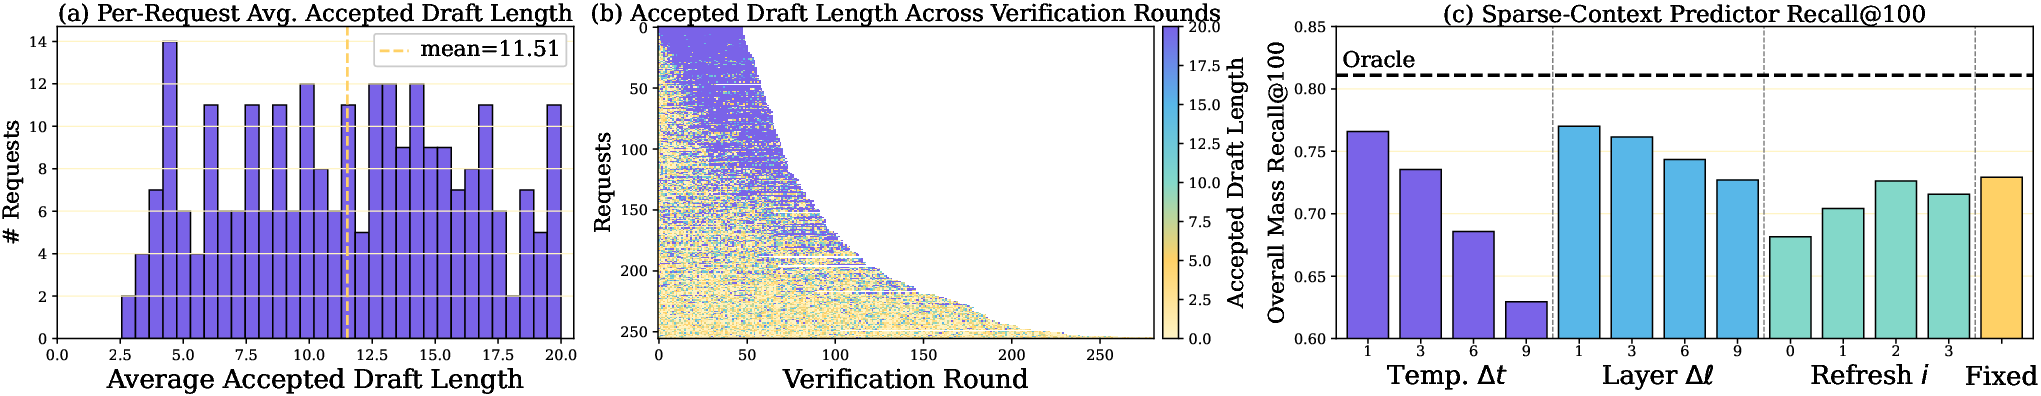
Общий график мешает запросам выбирать подходящую длину черновика
При генерации каждого нового токена механизм внимания читает из KV-кэша весь предыдущий контекст запроса. Для длинных последовательностей скорость ограничивает уже не столько вычисление, сколько перенос данных из памяти. Пакетирование помогает полносвязным слоям разделить загрузку весов между запросами, но не устраняет чтение отдельного KV-кэша для каждого из них.
Самоспекулятивное декодирование сокращает эти чтения без второй модели. Та же LLM сначала генерирует несколько черновых токенов с разреженным вниманием, которое обращается только к выбранным фрагментам контекста. Затем она одним проходом с полным вниманием проверяет весь черновик, принимает совпавшие токены и продолжает с первого расхождения.
Прежние пакетные реализации обычно заставляют все запросы сначала вместе набирать черновики, а затем вместе их проверять. Такой график удобен для исполнения, но запросы ведут себя неодинаково: одному выгодно рано перейти к проверке, другому — продолжить черновую генерацию. Подходящая длина также меняется внутри одного ответа, поэтому даже отдельная фиксированная настройка для каждого запроса не решает задачу.
В результате общий момент проверки создаёт две противоположные потери. Часть запросов проверяет слишком короткий черновик и плохо распределяет стоимость полного внимания между принятыми токенами. Остальные продолжают генерировать кандидатов, которые модель затем отклонит.
Смешанный проход объединяет разные состояния запросов
ASPIRE убирает общие фазы черновой генерации и проверки. В одном проходе модели часть запросов генерирует очередной кандидат по разреженному контексту, а часть проверяет накопленный черновик по полному KV-кэшу. Они по-прежнему совместно выполняют полносвязные слои, но получают собственную длину прохода и собственный набор данных для внимания.
После прохода проверяющий запрос добавляет принятый фрагмент и подтверждённый следующий токен в основной контекст. Запрос в режиме черновика сохраняет новый кандидат и остаётся в своём состоянии. Поэтому весь пакет больше не ждёт единого переключения режима.
Онлайн-планировщик решает для каждого запроса, когда пора проверять черновик. Он сглаживает долю принятых кандидатов после прошлых проверок и оценивает соотношение стоимости чернового и полного проходов. В оценку входят состав текущего пакета, объём KV-кэша и число токенов, которое модели предстоит обработать.
Планировщик выбирает длину, при которой ожидаемое число подтверждённых токенов на единицу времени максимально. Высокая доля принятых кандидатов позволяет продолжить черновик, а рост стоимости или падение точности приближает проверку. Это не глобальная эвристика для сервера, а меняющееся решение для каждого активного запроса.
ASPIRE также обновляет разреженный контекст во время черновой генерации. Один назначенный слой выполняет полное внимание и выбирает страницы KV-кэша для следующего токена, тогда как остальные слои используют сокращённый набор. Без такого обновления контекст устаревает: при длине черновика 10 разрыв в доле принятых кандидатов достигал 16,4 процентного пункта.
Архитектура полезна для собственного сервинга, но не выглядит готовой заменой планировщика
Проверка охватила три модели и пять нагрузок с математическими задачами, генерацией кода и длинными контекстами вплоть до 100 тысяч токенов. Подробные замеры проводили на одном H100 NVL с 96 ГБ памяти; отдельно работа рассматривает тензорный параллелизм. ASPIRE сравнивали с обычным декодированием и прежними вариантами самоспекулятивного декодирования, включая MagicDec и Vegas.
Результат касается прежде всего пакетной пропускной способности на этапе декодирования. Он наиболее применим там, где сервер одновременно ведёт неоднородные длинные запросы: агентные процессы, рассуждение с длинным ответом или генерацию после поиска по большому контексту. Проверка полной моделью сохраняет точный режим спекулятивного декодирования, поэтому ускорение не требует ослаблять правило принятия токенов.
Для внедрения недостаточно заменить формулу в существующем планировщике. Сервер должен уметь совместить черновые и проверочные запросы в одном проходе, передать им разные контексты внимания и поддерживать обновляемый разреженный KV-кэш. Именно смешанный проход составляет основное архитектурное отличие ASPIRE.
Работа оставляет интеграцию с универсальным непрерывным пакетированием и порционной обработкой входного контекста дальнейшим этапом. Поэтому она меняет направление прототипа для команд, которые контролируют собственный стек инференса, но пока не обосновывает немедленную замену планировщика в готовом сервере. Практический следующий шаг — проверить смешанный проход на реальном распределении длин запросов и убедиться, что выигрыш сохраняется вместе с действующими правилами пакетирования.
Источники
Иллюстрация: рисунок из статьи «ASPIRE: Asynchronous Batched Self-Speculative Decoding for Long-Context LLM Inference», Amir Ziashahabi, Hossein Entezari Zarch, Lei Gao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


