
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
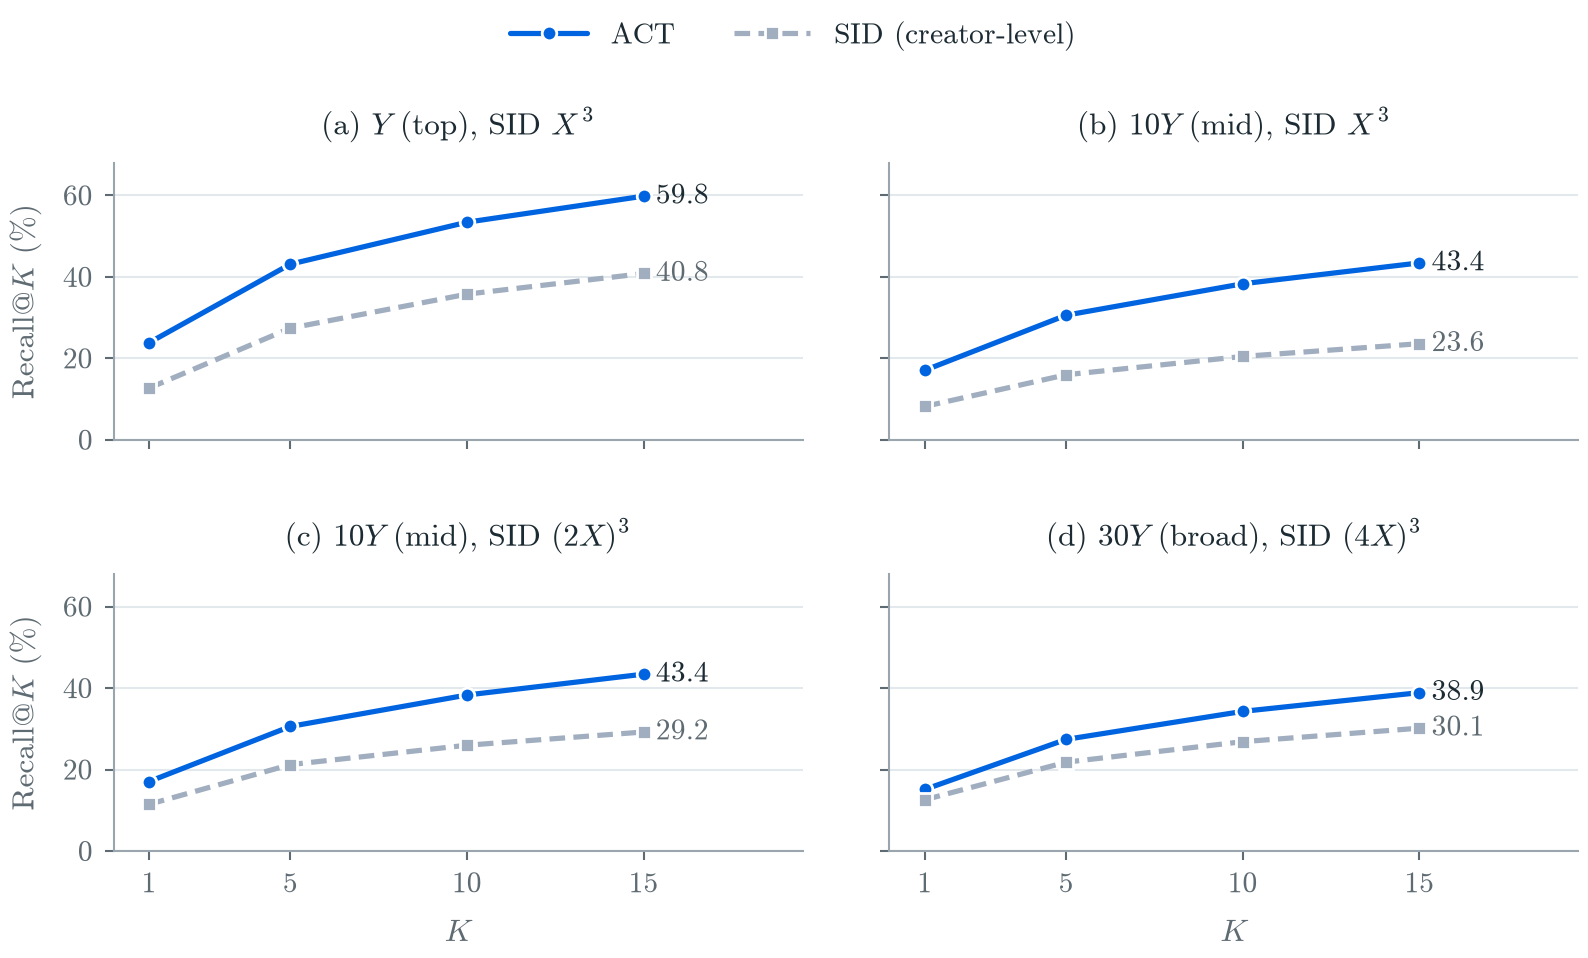
Система рекомендаций точнее выбирает новых для пользователя авторов, если различает их напрямую, а не объединяет под общими идентификаторами. В работе Meta полнота списка из 15 кандидатов (Recall@15) выросла на 19,8 процентного пункта, или в 1,84 раза, хотя работа не прошла рецензирование, а все числа получили сами авторы. Для команд, которые строят генеративные рекомендации, узким местом может оказаться не языковая модель, а способ представить объекты каталога.
Semantic ID теряет автора ещё до ранжирования
Генеративная рекомендательная система превращает историю пользователя в последовательность и предсказывает следующий объект как языковая модель. Обычно каждый объект получает Semantic ID: замороженный кодировщик строит вектор автора, а квантователь заменяет его короткой последовательностью кодов.
Такой идентификатор не всегда уникален. Несколько авторов могут получить одну последовательность, поэтому правильный прогноз Semantic ID ещё не означает, что система выбрала правильного автора. После генерации приходится раскрывать код в список авторов и разрывать ничью по популярности. Менее известный автор проигрывает даже тогда, когда модель нашла подходящую группу.
Вторая проблема возникает при обучении. Квантователь и исходные представления авторов заморожены, поэтому ошибка языковой модели не меняет их. Кодировщик оптимизировали для одной задачи, а рекомендации — для другой, но согласовать эти части сквозным обучением нельзя.
ACT убирает промежуточный слой. Каждый кандидат получает собственный токен внутри словаря Llama-3.2-3B, а его вектор обучается вместе с моделью. На выдаче система сразу выбирает лучшие токены авторов: ей не нужны лучевой поиск по нескольким кодам, соединение с таблицей соответствий и дополнительная сортировка по популярности.
Сравнение проводили на производственных данных Meta и на KuaiRand. В основном производственном режиме модели обучались примерно на 10 млн событий, причём выборки, основа модели и обучение совпадали, а менялся только слой идентификаторов. На публичном наборе кандидатов ограничили 50 тыс. наиболее часто встречавшихся авторов.
Отдельный токен улучшил и полноту, и скорость
Преимущество ACT сохранилось во всех проверенных размерах каталога. Даже в самом широком производственном режиме и с увеличенным справочником Semantic ID разрыв по полноте списка составил 8,72 процентного пункта. Значит, расширение пространства кодов уменьшает число коллизий, но не устраняет их последствия полностью.
ACT также снизил задержку на пользователя примерно в 2,7 раза на одинаковом оборудовании. Semantic ID требует сгенерировать последовательность и хранить состояние для каждого луча поиска, тогда как ACT выдаёт автора за один шаг. Более широкий словарь увеличивает объём вычислений при выборе токена, но в этом эксперименте один широкий шаг оказался дешевле нескольких последовательных.
На KuaiRand полнота списка достигла 2,763% против 1,859% у Semantic ID. ACT стал единственным проверенным методом, который обошёл ранжирование по общей популярности на всех выбранных размерах списка. Это важно как независимая проверка механизма, хотя публичный набор заметно меньше производственного каталога.
Онлайн-результат гораздо скромнее офлайн-разрыва. В живом A/B-тесте все опубликованные метрики сдвинулись в положительную сторону, но крупнейший прирост составил 0,66% и лишь приблизился к статистической значимости. Работа подтверждает перенос эффекта только направлением метрик, а не сопоставимым ростом продукта.
ACT подходит головной части каталога, но не заменяет поиск целиком
Работа меняет план разработки там, где каталог ограничен, а каждый объект получает достаточно обучающих событий. В таком случае стоит сначала проверить прямые токены объектов, а уже затем усложнять языковую модель или увеличивать справочник Semantic ID. Эксперимент показывает, что более крупная модель не исправит информацию, потерянную при кодировании каталога.
Для редкого хвоста ACT не становится автоматической заменой обычному поиску кандидатов. Каждый новый токен нужно обучить, а размер выходного слоя растёт вместе с числом авторов. На уменьшенной версии KuaiRand прямые токены уступили простым эвристикам именно при малом числе примеров на автора.
Практическая архитектура поэтому остаётся составной: ACT ранжирует хорошо наблюдаемую головную часть каталога, а традиционный поиск обслуживает редких авторов. Границу следует выбирать по числу взаимодействий на объект, доступной памяти и задержке, а не по формальному размеру каталога.
У подхода есть и эксплуатационное преимущество: нового автора можно добавить новой строкой в словарь без перестройки всего справочника кодов. При этом эксперименты не нашли пользы от дополнительного контрастивного обучения и методов оптимизации предпочтений, поэтому базовая версия ACT остаётся сравнительно простой: прогрев токенов, затем совместное обучение с моделью через LoRA.
Источники
Иллюстрация: рисунок из статьи «Beyond Semantic IDs: Atomic Creator Tokens for Large-Scale Generative Recommendation», Zhuosheng Liu, Yihan Wu, Ziyun Xu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


