
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковую модель научили выбирать не только сколько информации брать у другого токена, но и какие части этой информации пропускать. В препринте Naveen Mysore из University of California, Santa Barbara и Dyssonance AI, который не прошёл рецензирование и содержит числа, полученные самим автором, перплексия снизилась примерно на два пункта. Подход открывает отдельный слой управления моделью, но пока требует менять сам механизм внимания.
Поверхность меняет содержимое, а не вес связи
Обычный механизм внимания вычисляет, насколько сильно один токен должен учитывать другой. Однако токен-источник передаёт всем получателям одинаковый вектор значения: запрос определяет объём внимания, но не то, какие компоненты вектора извлечь.
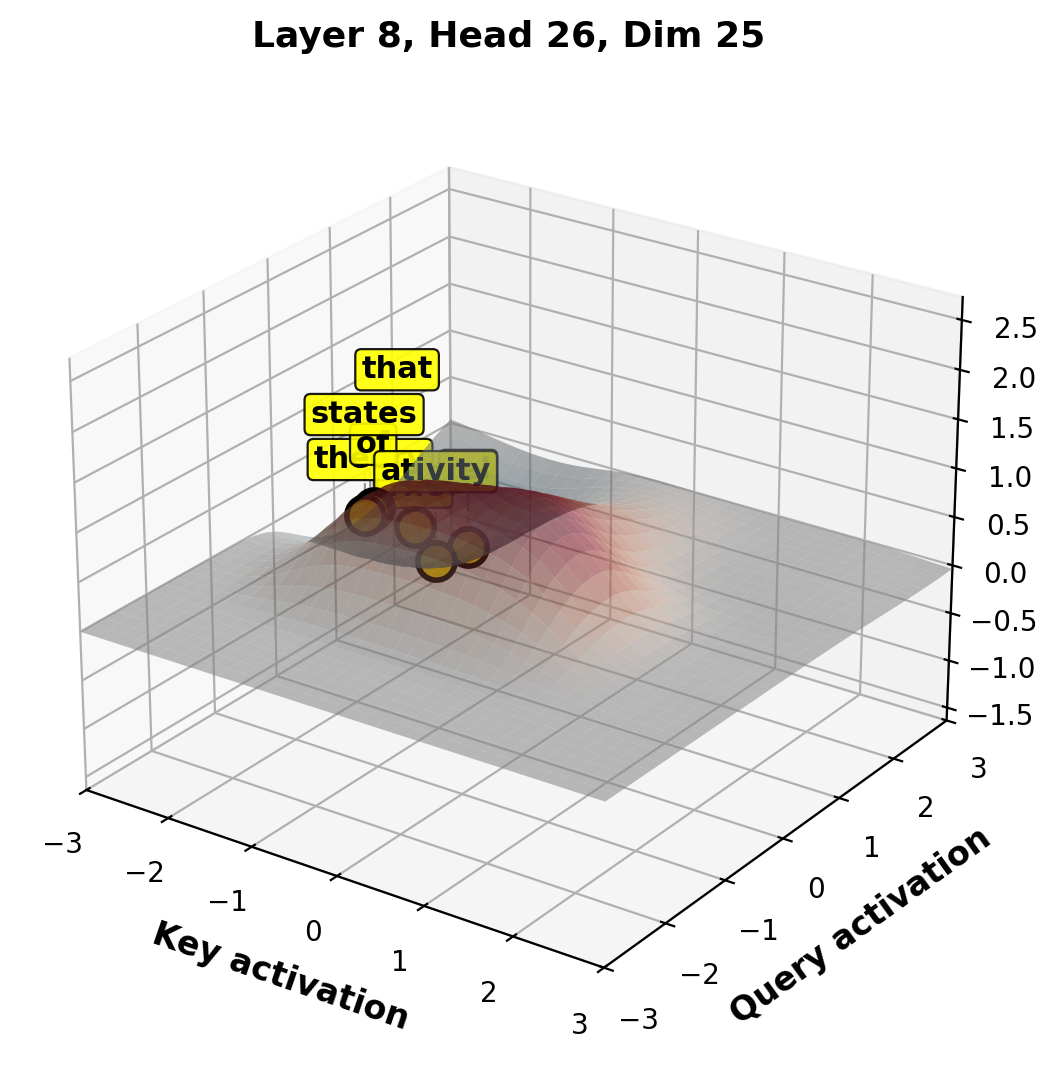
Attention manifolds добавляют к каждой компоненте вектора гладкую двумерную сплайн-поверхность. Её координаты задают соответствующие компоненты запроса и ключа, а высота определяет, усилить или ослабить передаваемое значение. Поэтому одна и та же информация может по-разному проходить к разным токенам-получателям.
Поверхность представлена сеткой обучаемых коэффициентов. Все коэффициенты сначала равны нулю, поэтому добавленный модуль не меняет поведение исходной модели до обучения. Затем обновляются только поверхности, а базовые веса остаются замороженными; дополнительные параметры занимают 0,3% от размера модели.
Прямой расчёт потребовал бы строить большой тензор для каждой пары токенов и каждой компоненты. Автор разложил операцию на признаки запроса и взвешенные признаки ключей со значениями. Такое разложение сохраняет точный результат, но не создаёт промежуточный тензор целиком.
Метод проверяли на LLaMA 3.2-1B-Instruct и 3B-Instruct. Поверхности обучали предсказывать следующий токен на WikiText-103, а перплексию измеряли на WikiText-2. Перплексия показывает, насколько хорошо модель предсказывает продолжение: чем она ниже, тем увереннее правильный следующий токен.
Неоднозначные фразы менялись чаще кода
На наборе из 112 запросов дополненные поверхности изменили жадно декодированный ответ, то есть наиболее вероятное продолжение без случайной выборки, в доле до 83%. Для неоднозначных фраз результат менялся в 94–100% случаев. Код оказался наименее чувствительной категорией, что связывает эффект прежде всего с маршрутизацией смысла, а не синтаксических шаблонов.
В отдельных примерах модель исправила содержательные ошибки. Ответ о CAP theorem перестал описывать согласованность, доступность и устойчивость к разделению как три одновременно достижимых компонента и сформулировал невозможность гарантировать их вместе. Объяснение принципа неопределённости вместо «некоторых свойств» стало прямо называть положение и импульс.
Сам факт изменения ответа ещё не доказывает улучшение. Систематический замер здесь показывает, как часто меняется текст, а вывод о качестве основан на разборе отдельных примеров. Проверка охватывает одну модельную семью и два её размера, поэтому перенос результата на другие архитектуры остаётся отдельной задачей.
Для продукта это пока инструмент архитектурных экспериментов
Обученные поверхности можно редактировать после обучения. Если инвертировать коэффициенты целого слоя, жадный ответ меняется для девяти из десяти проверенных запросов. Редактирование одной поверхности действует заметно слабее, поэтому обещание точного управления отдельными понятиями работа пока не подтверждает.
Другой вариант — выставить поверхность так, чтобы выбранный канал перестал передавать значение. Автор называет такую конструкцию стеной внимания. В предварительном опыте блокировка целого слоя перевела продолжение запроса о создании взрывного устройства от конкретных указаний к общему объяснению химии и физики.
Такая стена не избирательна: она меняла и безопасные ответы. Поверхности можно редактировать по отдельным компонентам и участкам сетки, но в работе ещё нет способа надёжно находить области для конкретной категории содержания. Поэтому attention manifolds пока дополняют обучение по человеческим предпочтениям и другие методы настройки, а не заменяют их.
Есть и инженерная цена. Реализация увеличивает задержку примерно в полтора раза и пока не поддерживает декодирование с кешем ключей и значений — стандартный способ ускорить последовательную генерацию. Для сервиса с жёсткими требованиями к задержке это важнее небольшого прироста качества.
Работа меняет планы команд, которые разрабатывают собственную архитектуру трансформера или исследуют управляемое внимание: здесь появился отдельный, визуализируемый и обратимо редактируемый модуль. Для команды, которая вызывает готовую LLM через API или дообучает её обычными адаптерами, практический стек пока остаётся прежним.
Источники
Иллюстрация: рисунок из статьи «Attention Manifolds: Steering or Blocking Language Models by Editing Learned B-Spline Surfaces», Naveen Mysore, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


