
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Для последовательных моделей выяснили, когда выгоднее хранить прошлое в сжатом состоянии, а когда — обращаться к прежним элементам напрямую. В препринте, который не проходил рецензирование и содержит замеры самих авторов, модели пространства состояний (SSM) лучше обновляют накопленную оценку и собирают данные по позиции, а внимание требует экспоненциально меньшей ширины при поиске по содержанию. Выбор зависит не от общего рейтинга архитектур, а от того, как задача использует историю.
Enes Arda, Semih Cayci и Atilla Eryilmaz построили общую схему для трёх операций: собрать свидетельства из входных данных, поддерживать на их основе оценку и выбрать нужную часть истории. Качество они измеряли накопленным байесовским сожалением — суммой дополнительных ошибок относительно оптимального предсказателя по мере роста контекста.
В простейшем случае SSM оптимально затухает вес старых наблюдений среди схем, где вес зависит только от давности. Линейное внимание усредняет наблюдения в окне и проигрывает из-за одинаковых весов. При маршрутизации по позиции свёртка и рекуррентное состояние дают SSM тот же темп снижения ошибки с меньшей памятью. При маршрутизации по содержанию соотношение меняется: внимание хранит элементы и выбирает нужный, а SSM приходится держать кандидатов раздельно. Поэтому представление для внимания растёт логарифмически, а состояние SSM — почти линейно.
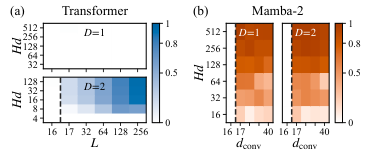
На задачах с кодовой книгой от 8 до 128 элементов минимальная суммарная ширина голов Transformer, достигавшая качества 0,8, оставалась в диапазоне 10–24; у Mamba-2 она быстро росла. Проверки охватывают обобщённую линейную регрессию, синтетические задачи с задержкой и маршрутизацией, а также LLaMA-type Transformers и Mamba-2. Результат задаёт карту механизмов в контролируемых условиях, но не сравнивает производственные LLM целиком.
Источники
Иллюстрация: рисунок из статьи «A Comparative Analysis of Attention versus State-Space Models for In-Context Learning», Enes Arda, Semih Cayci, Atilla Eryilmaz, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


