
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Повторно используемый контекст LLM можно кэшировать без заметной потери качества, если научить модель правильно выбирать сведения внутри кэша. В препринте команда EIT-NLP Lab, The Hong Kong Polytechnic University и Tencent Youtu Lab сократила время до первого токена до 3,73 раза; работа пока не рецензирована, а все числа получили сами авторы. Для агентных систем это открывает путь к повторному использованию документов, навыков и памяти без их пересчёта при каждом запросе.
Ошибка возникает при выборе фрагмента, а не внутри KV-кэша
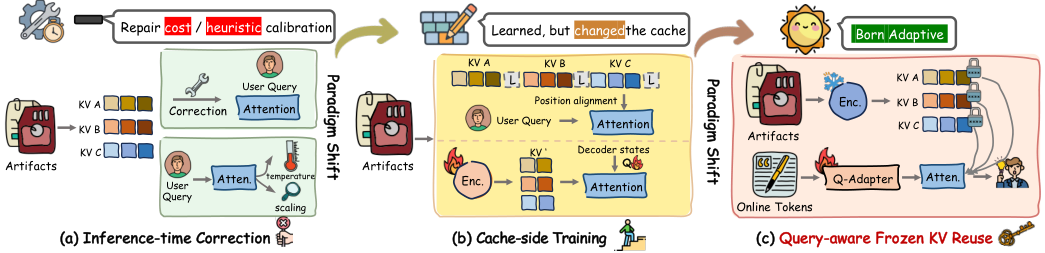
KV-кэш хранит ключи и значения, которые модель вычислила для токенов контекста. Обычный префиксный кэш работает, только если повторяется начало запроса: тот же текст должен находиться на том же месте. В агентной системе документы и записи памяти приходят в разном порядке, поэтому такое условие часто не выполняется.
Позиционно-независимое кэширование, или PIC, обрабатывает каждый повторно используемый фрагмент отдельно. Затем система собирает запрос из готовых блоков. Она экономит вычисления, но модель отвечает хуже, чем после полного прохода по контексту.
Работа разделяет две возможные причины. Первая — каждый блок кэшировали без соседних документов и его представление потеряло нужные сведения. Вторая — сведения сохранились, но механизм внимания неверно распределяет вес между блоками.
Эксперименты поддерживают второе объяснение. Когда модели давали один релевантный фрагмент, PIC почти не мешал прочитать его. Разрыв увеличивался, когда ответ требовал выбрать один источник среди нескольких или соединить сведения из разных источников. Простое восстановление исходных позиций блоков проблему не устраняло.
В контрольном опыте исследователи оставили кэшированные ключи и значения неизменными, но подставили распределение внимания из полного прохода. Качество вернулось примерно к уровню полного пересчёта. Значит, для восстановления ответа необязательно заново строить весь KV-кэш: достаточно изменить то, как текущий запрос его читает.
Attuner обучает запросы читать замороженные блоки
Attuner добавляет низкоранговые адаптеры в проекции запросов механизма внимания. Они корректируют запросы только для некэшированных и генерируемых токенов. Ключи и значения сохранённых документов остаются прежними, поэтому один кэш можно продолжать использовать между обращениями.
Для обучения нужен исходный вариант модели, который видит весь контекст целиком. Он формирует распределение вероятностей следующего токена, а версия с PIC учится его воспроизводить. После обучения эталонная модель не нужна: изменения объединяются с проекциями запросов и работают во время обычного вывода.
Обучается менее 0,05% параметров модели. Это не означает, что адаптер подходит любой LLM: в работе для каждой базовой модели готовили собственную версию. Зато менять формат существующего кэша или пересчитывать сохранённые блоки после подключения Attuner не требуется.
Метод проверяли на Qwen3-4B и Qwen3-8B, на семи наборах задач с навыками, документами, памятью и кодом. Один адаптер для каждой модели обучали на смеси из 12 000 примеров, а затем применяли как к знакомым, так и к не входившим в обучение задачам.
Когда Attuner меняет архитектурный план
На задачах из обучающих направлений средний результат вырос относительно обычного PIC на 5,13 пункта для Qwen3-4B и на 7,77 пункта для Qwen3-8B. Улучшение переносилось и на задачи, которых не было в обучающей смеси, хотя восстановление качества оказалось неполным на части проверок.
Среднее ускорение времени до первого токена относительно полного прохода составило 1,79 раза для младшей модели и 2,45 раза для старшей. Замер начинается с уже подготовленным KV-кэшем в памяти центрального процессора: он включает перенос на GPU, сборку блоков, обработку новых токенов и выбор первого токена ответа, но не создание кэша.
Работа меняет планы команд, у которых одни и те же крупные фрагменты входят во множество запросов, но постоянно меняют положение: это библиотеки инструментов агента, извлечённые документы и долговременная память. В такой архитектуре стоит отделить неизменяемое хранилище KV от обучаемого механизма чтения, а не закладывать пересчёт части документов как обязательный этап.
Если контекст редко повторяется, подготовка кэша и обучение адаптера не получают той же опоры. Результаты также относятся к двум моделям семейства Qwen3 и выбранным типам задач, поэтому перенос на другую LLM потребует отдельного обучения и собственного сравнения с полным проходом.
Источники
Иллюстрация: рисунок из статьи «ATTUNER: Recomputation-Free KV Cache Reuse via Query-Side Adaptation», Xinghao Chen, Junnan Dong, Cai Ke и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


