
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Ненадёжную расшифровку голосового запроса можно распознать до того, как аудио-LLM начнёт отвечать. В препринте Apple и University of California San Diego, который не проходил рецензирование, числа получили сами авторы: предложенный предиктор достиг макро-F1 81,10% на знакомом распределении и 78,09% при смене речи и акустики. Голосовой продукт может запросить повтор записи до того, как модель уверенно ответит на неверно понятый вопрос.
Надёжность измеряли для каждой пары речи и помехи
Обычная оценка качества записи не отвечает на главный вопрос: сможет ли конкретная аудио-LLM расшифровать конкретную фразу. Два файла с похожим уровнем шума могут дать разные результаты из-за содержания речи, характера помехи и особенностей модели.
Для разметки брали запись с эталонной расшифровкой, фиксировали источник шума и постепенно меняли отношение сигнала к шуму. После каждого изменения модель расшифровывала запись, а результат сравнивали с эталоном. Двоичный поиск находил границы, на которых менялась доля ошибочно распознанных слов.
Каждую запись относили к одному из четырёх состояний: расшифрована без ошибок, получила небольшие искажения, умеренные искажения или серьёзные искажения. Границы между последними состояниями проходили при доле ошибочных слов в 10% и 30%. Для каждой пары речи и помехи получался свой набор границ, который сохраняли в банке меток.
Такой способ требует эталонного текста и повторных запусков модели, но только на этапе подготовки данных. После этого из допустимых интервалов отношения сигнала к шуму собирают обучающие примеры, где класс отражает поведение целевой модели, а не условную громкость помехи.
Сигнал об ошибке находится внутри аудиокодера
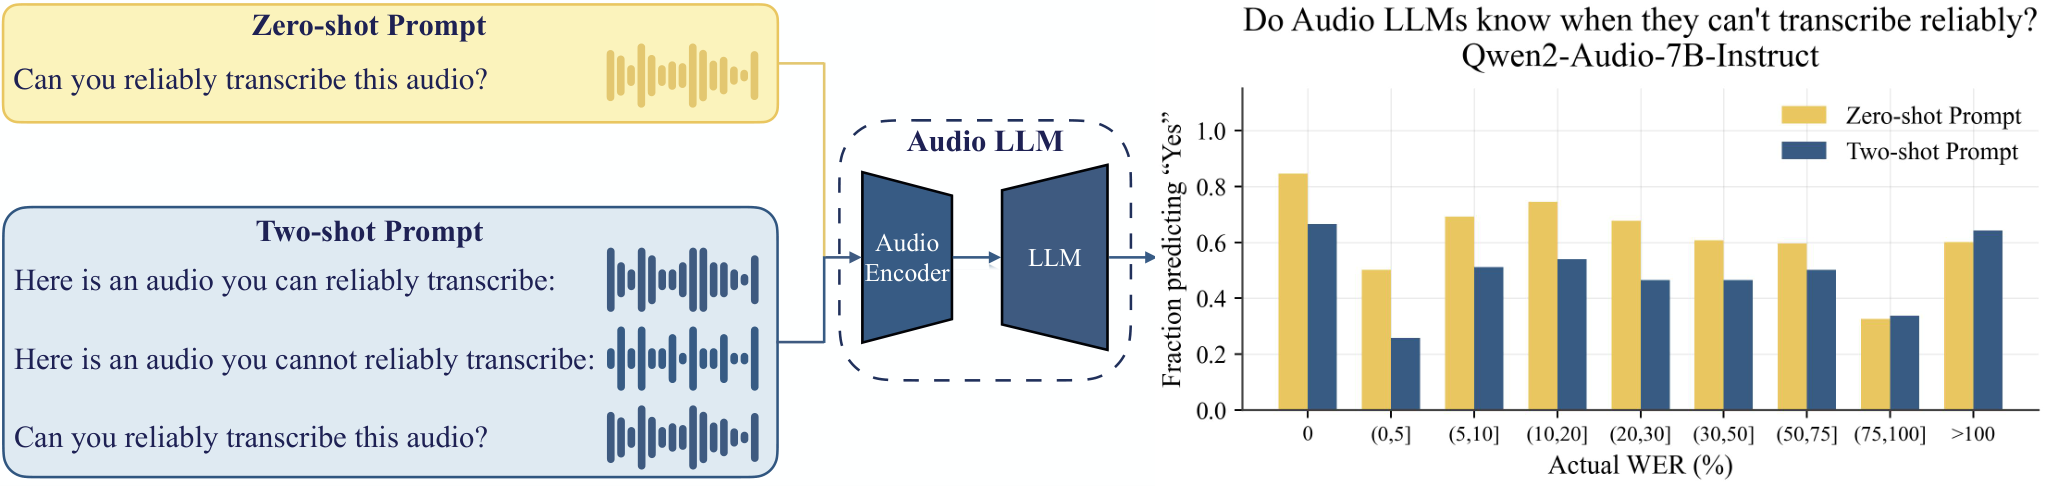
Самооценка через запрос к самой модели работала плохо: декодер склонялся к ответу, что запись будет расшифрована надёжно, даже когда фактическая ошибка была высокой. Примеры в контексте частично снижали эту уверенность, но не устраняли расхождение.
Авторы вместо декодера использовали скрытые представления аудиокодера. Он преобразует запись в последовательность признаков по времени. Обучаемый модуль назначает вес каждому фрагменту, сводит последовательность к одному представлению записи, а двухслойный классификатор выбирает класс надёжности.
Сам аудиокодер остаётся замороженным. Предиктор работает до генерации текста и не требует менять параметры аудио-LLM. В рабочем запросе кодер всё равно обрабатывает запись, поэтому поверх существующего пути добавляются только временное объединение признаков и классификатор.
Макро-F1 усредняет баланс точности и полноты по всем классам, чтобы частый класс не скрыл ошибки на редких. Предложенный метод обошёл сильнейшие альтернативы на 10,33 пункта внутри исходного распределения и на 11,93 пункта при переносе. Среди сравнений были модели качества речи, неопределённость токенов при генерации и оценка ошибки по уже созданной расшифровке.
Проверка охватывала Qwen2-Audio-7B-Instruct, Phi-4-Multimodal-Instruct и MOSS-Audio-8B. Для обучения использовали речь LibriSpeech, помехи DNS Challenge и MUSAN, а также моделируемую реверберацию OpenSLR26. При переносе речь заменили на LJSpeech, окружающие шумы — на SONYC-UST, а отклики помещений — на реальные записи OpenSLR28. Результат относится к контролируемым смесям речи, музыки, окружающего шума и реверберации.
Командам нужен отдельный контур перед генерацией
Работа меняет архитектурный план голосового продукта: проверку надёжности стоит ставить сразу после аудиокодера, а не после расшифровки или ответа. Система может пропустить уверенно распознанный запрос дальше, а для сомнительной записи попросить пользователя повторить фразу, подойти ближе к микрофону или убрать источник шума.
Такой контур не стоит считать универсальным фильтром, который одинаково работает с любой моделью. Метки строятся по ошибкам конкретной аудио-LLM, поэтому при замене семейства меняются границы между надёжной и ненадёжной записью. Перенос между Qwen2 и Phi-4 сохранил качество лучше, чем перенос на MOSS.
Полный банк меток для новой модели может не понадобиться. В одном из опытов границы скорректировали по 5% общих пар речи и помехи, после чего потеря точности при переносе с Phi-4 на MOSS сократилась с 12,9 до 2,1 пункта. Практический план — переиспользовать исходную разметку, измерить расхождение на небольшой общей части и сдвинуть границы классов под целевую модель.
Перед внедрением команде всё равно понадобится собственный набор характерных записей: звонки, голосовые команды или сообщения с теми микрофонами и шумами, которые встречаются в продукте. Работа показывает место для защитного механизма и способ его обучить, но порог запроса уточнения придётся выбирать вместе с продуктовой политикой: лишний повтор раздражает пользователя, а пропущенная ошибка запускает действие по неверно понятой команде.
Источники
Иллюстрация: рисунок из статьи «Audio LLMs Know When They Can't Hear You», Amirhosein Javadi, Richa Dixit, Mehrdad Farajtabar и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


