
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Проверка уже работающего сортировщика CV показала, что длина документа может выдать правильный порядок без понимания текста, метрика согласия — ухудшаться при обучении, а умная кнопка выбора следующего CV — увеличивать работу комиссии. Работа Utrecht University и AcademicTransfer пока не рецензирована, а все числа получили сами авторы; после исправления набора система всё равно находила 95% подходящих кандидатов примерно за половину стопки. Для подобных продуктов это меняет не столько модель, сколько оценку данных, интерфейс и подсчёт затрат человека.
Длина CV оказалась сильнее смысловой модели
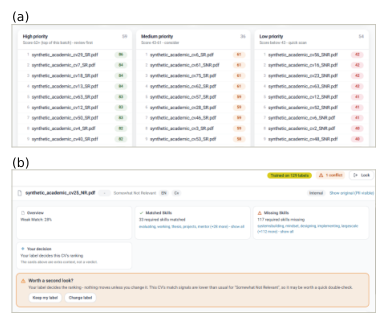
Сортировщик внедрён на национальной платформе академических вакансий. Он не принимает решения за комиссию, а предлагает порядок чтения: замороженная многоязычная модель превращает документы в числовые представления, а отдельная линейная модель подстраивается под оценки конкретной комиссии после каждого нового ответа.
Первую проверку проводили на наборе из 300 синтетических CV для одной вакансии. Генератор случайно сделал документы сильных кандидатов длиннее остальных. Простая сортировка по числу символов поставила все CV верхней категории в начало списка, поэтому точность на первых позициях и нормализованная совокупная полезность списка почти ничего не говорили о понимании содержания.
Авторы пересобрали набор с единым лимитом объёма для всех категорий. После 24 размеченных документов комиссия должна была прочитать 48,2% контрольной части, чтобы найти почти всех подходящих кандидатов; теоретический минимум составлял 47,5%. Основной эффект сохранился, но появился другой короткий путь: категории хорошо разделяло число упоминаний научных площадок, поскольку они входили в критерии вакансии.
Практический вывод для оценки синтетических данных прост: перед запуском моделей набор стоит отсортировать по длине, числу строк, ключевым словам и другим дешёвым признакам. Если такой признак решает задачу, высокий результат модели нельзя считать доказательством смыслового ранжирования. Удаление одного короткого пути тоже не делает набор нейтральным — на его место может выйти следующий.
Метрика согласия и кнопка подсказки считали не то
Интерфейс показывал четыре уровня соответствия кандидата вакансии, но отдельной четырёхклассовой модели под ними не было. Система брала вероятность бинарного решения и разрезала её фиксированными порогами. По мере обучения модель становилась увереннее, вероятности пересекали эти пороги, а коэффициент согласия сначала рос, затем падал, хотя порядок CV оставался почти неизменным.
Такую метрику нельзя использовать как самостоятельную кривую обучения. Она одновременно измеряет качество ранжирования и пригодность однажды выбранных порогов. Для контроля нужны метрика без порогов, например ранговая корреляция, и отдельная проверка того, соответствуют ли границы уровней оценкам текущей комиссии.
Вторая ошибка возникла в кнопке «предложить следующий CV». Система выбирала документ, в котором была наименее уверена. Это стандартный способ активного обучения, но здесь разметчик и конечный читатель — один человек: сначала комиссия читает CV ради метки, затем продолжает разбирать оставшуюся стопку.
При максимальном бюджете эксперимента такой выбор довёл общую долю прочитанных документов до 82%, тогда как случайная разметка требовала около 69%. Неопределённые CV часто находились среди документов, которые хороший порядок позволил бы пропустить до самого конца. Качество модели не компенсировало лишнее чтение, поэтому разработчики заменили выбор по неопределённости чередованием документов из разных диапазонов оценки.
Планы меняет учёт человеческой работы, а не выбор LLM
Командам, которые строят сортировку заявок, обращений или документов с человеком в контуре, стоит оптимизировать полную стоимость процесса. В неё входят документы, прочитанные ради меток, и остаток списка, который приходится проверить после переупорядочивания. Качество классификатора само по себе не показывает, экономит ли интерфейс время.
Замена модели представлений полезна главным образом до появления меток. Размещённая у внешнего поставщика LLM подняла ранговое различение до разметки с 0,66 до 0,80, но примерно после двух десятков ответов преимущество исчезло. Локальная модель, которая совместно оценивает вакансию и CV, дала сопоставимый выигрыш на старте без отправки документов внешнему сервису.
Из этого следует практический порядок работ: сначала проверить набор простыми правилами, затем считать общую нагрузку человека, после этого исправить пороги и логику подсказок. Более дорогую модель имеет смысл подключать, только если первые документы действительно определяют ценность продукта и выигрыш оправдывает требования к задержке и конфиденциальности.
Границы проверки узкие: использовались синтетические CV, одна вакансия по информатике, искусственно сбалансированные категории и автоматические эталонные метки. Пользователи в эксперименте не участвовали, поэтому работа измеряет качество порядка, а не реальное время чтения или готовность комиссии ему следовать. Абсолютная экономия на настоящем найме может отличаться, но ошибки в метриках и двойной учёт чтения возникают из самой конструкции таких систем.
Источники
Иллюстрация: рисунок из статьи «Prioritize, Don't Decide: What We Learned Auditing a Deployed Human-in-the-Loop CV Sorter», Hadi Mohammadi, Jeroen Sparla, Alexandros Paliouras и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


