
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
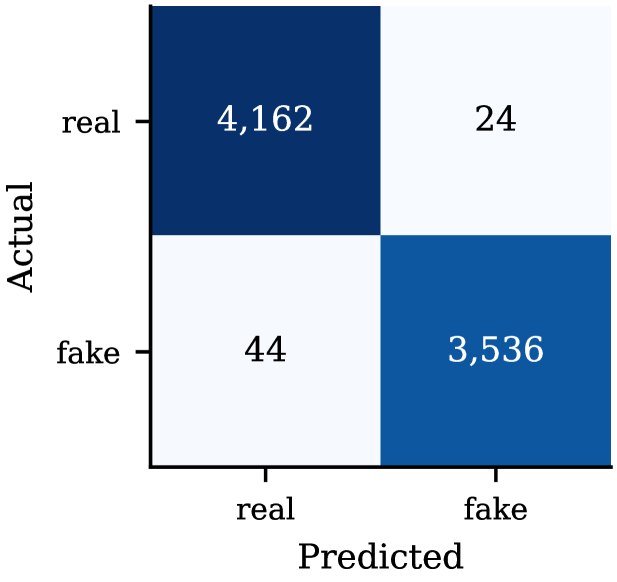
Аудит популярного корпуса ISOT/Kaggle показал: результат около 99% измеряет различия между источниками и темами, а не способность проверять факты. В препринте Yuvraj Verma, который не прошёл рецензирование и приводит числа из собственных замеров, модель только по метаданным получила F1 1,000. Случайное разделение такого корпуса на обучение и тест не показывает, как система поведёт себя на новых источниках.
Для аудита использовали признаки TF-IDF и четыре линейных классификатора, а затем по очереди меняли данные и схему проверки. Модель запускали только на поле с темой, удаляли метаданные и служебную отметку информационного агентства, убирали точные дубликаты, разделяли обучение и тест по темам и переносили классификатор на независимый корпус LIAR.
Тематические метки двух классов не пересекались, поэтому текст статьи не понадобился для идеальной классификации. Кроме того, 19,4% документов в обычной тестовой выборке имели точную копию в обучающей. После устранения трёх явных каналов утечки F1 снизилась лишь на 1,21 пункта: модель продолжила различать редакционный стиль источников. F1-мера сводит в один показатель долю верных срабатываний и долю найденных положительных примеров.
При разделении по темам F1 упала до 0,8067. DistilBERT лучше работал на случайном разделении, но при смене тем потерял 12,9 пункта качества ранжирования против 5,2 у линейной модели. На LIAR все три варианта показали ROC-AUC от 0,54 до 0,57 — близко к случайному ранжированию.
Проверка охватывает один англоязычный корпус статей о политике США за 2016–2017 годы; тематическое разделение одновременно меняет тему, происхождение и период текстов, а LIAR состоит из коротких утверждений, а не статей. Для аналогичных проектов вывод практический: до выбора архитектуры стоит обучить модель только на метаданных, удалить дубликаты до разделения данных, проверить малую обучающую выборку и вынести отдельные темы в тест. Такие проверки показывают утечку раньше, чем команда начинает улучшать уже завышенную метрику.
Источники
Иллюстрация: рисунок из статьи «What Does 99% Accuracy Measure? A Reproducible Audit of Shortcut Learning in a Widely Used Fake News Corpus», Yuvraj Verma, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


