
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Научились заранее выявлять суррогатные модели, которые хорошо предсказывают поток, но ведут оптимизацию контроллера не туда. В препринте Ruige Kong и Stefania Fresca, который не рецензирован и содержит замеры самих авторов, построенные таким способом контроллеры сравнялись с обучением без модели или превзошли его при 3–156-кратном сокращении обращений к точному решателю. Для проекта это меняет критерий приёмки суррогата: ошибки прогноза недостаточно, нужно отдельно проверять производную, по которой обучается контроллер.
Точный прогноз ещё не задаёт верное направление
Контроллер выбирает действие по текущему состоянию потока. При обучении через дифференцируемый суррогат алгоритм меняет параметры контроллера в направлении, которое должно улучшить целевую функцию: например, снизить сопротивление или интенсивность вихрей.
Направление задаёт градиент действия — производная целевой функции по управляющему действию. Суррогат может точно воспроизводить наблюдаемую траекторию, но ошибаться в ответе на малое изменение действия. Тогда прогноз выглядит убедительно, а каждый шаг оптимизации уводит контроллер в неверную сторону.
В одном эксперименте корреляция между предсказанным и точным значением целевой функции достигла 0,9996, тогда как корреляция градиентов составила только 0,459. Такой суррогат прошёл бы обычную проверку по ошибке прогноза, но не годился бы как источник обновлений для контроллера.
Обратное тоже не гарантирует результата. Другой суррогат показал корреляцию градиентов 0,996, однако оптимизация без привязки к исходному закону управления ухудшила целевую функцию на 0,52%. Верная локальная производная помогает выбрать следующий шаг, но не удерживает всю траекторию обучения в проверенной области.
Как аудируют градиент действия
Метод начинает с состояний, которые не использовали при обучении суррогата. Для каждого состояния выбирают опорное действие и один горизонт управления, после чего получают две оценки одной производной.
Суррогат вычисляет градиент автоматически через свою цепочку операций.
Точный решатель получает слегка увеличенное и слегка уменьшенное действие. Разница между целевыми функциями даёт независимую оценку производной центральной конечной разностью.
Оценки сравнивают по общей корреляции, доле совпавших знаков и медианной корреляции по отдельным исполнительным каналам.
Порог для каждой метрики фиксируют до оптимизации. Суррогат принимают, только если он проходит все проверки.
Если аудит пройден, по дешёвым градиентам суррогата подбирают низкоразмерный закон обратной связи. Если проверка провалена, закон строят по производным, измеренным точным решателем, либо обучают другой суррогат и проверяют заново. Так отказ суррогата не блокирует создание контроллера, но повышает вычислительную цену.
Полученный закон сначала переносят в нейросетевой контроллер, заставляя сеть воспроизводить его действия. Затем при оптимизации добавляют квадратичный штраф за отклонение от этого закона. Авторы проверяли как постоянную привязку, так и постепенное снятие штрафа.
Аудит действует только рядом с теми состояниями и действиями, где измеряли производную. Один суррогат прошёл проверку около фиксированного действия, но провалил её около действий готового контроллера. Поэтому проверку нужно повторять в рабочей области, а не считать бессрочным сертификатом модели.
В план разработки добавляется проверка производной
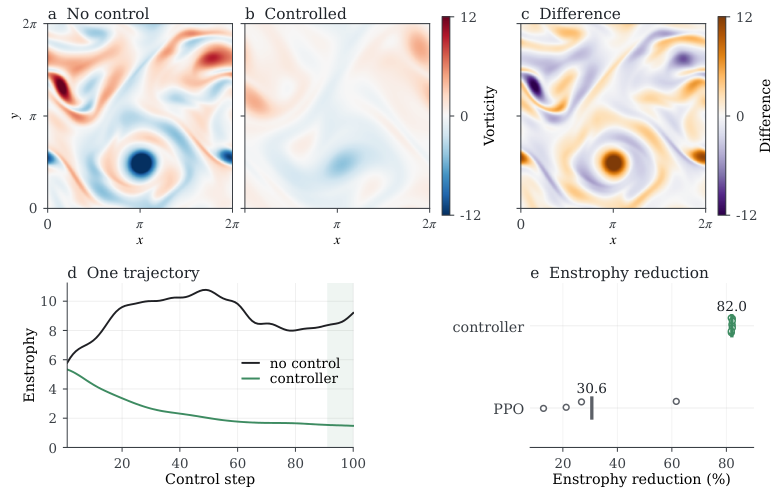
Работа охватывает четыре задачи управления потоками: след за вращающимся цилиндром, группу цилиндров, вынужденную двумерную турбулентность и хаотическую систему Kuramoto–Sivashinsky. Задачи включают граничное и объёмное управление, а число управляющих каналов меняется от одного до восьми. Все итоговые контроллеры оценивали прямым численным расчётом и сравнивали с обучением без модели по согласованному протоколу.
Метод подходит командам, которые обучают контроллер через дифференцируемую модель дорогого симулятора. Приёмочные испытания такого суррогата стоит разделить на два контура: качество прогноза отвечает за воспроизведение динамики, а аудит градиента — за пригодность модели для оптимизации действий.
Расходы точного решателя при этом не исчезают. Его прогоны нужны для независимой оценки производной, повторной проверки около рабочих действий и финальной оценки контроллера. Экономия появляется, когда эти ограниченные кампании заменяют основную часть обучения на точном симуляторе.
Привязка к простому закону управления также становится частью конструкции, а не дополнительной регуляризацией, которую можно убрать без проверки. Она задаёт нейросети исходное поведение и ограничивает уход в область, где аудит ничего не гарантирует. Снимать штраф разумно только после отдельного сравнения на точном решателе.
Результаты пока обосновывают такой процесс для задач управления динамическими системами через дорогой численный расчёт. Они не дают универсального сертификата суррогата: проверка относится к конкретной целевой функции, горизонту, состояниям и диапазону действий.
Источники
Иллюстрация: рисунок из статьи «Audited Gradients, Anchored Policies: Model-Based Reinforcement Learning for Efficient Flow Control», Ruige Kong, Stefania Fresca, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


