
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
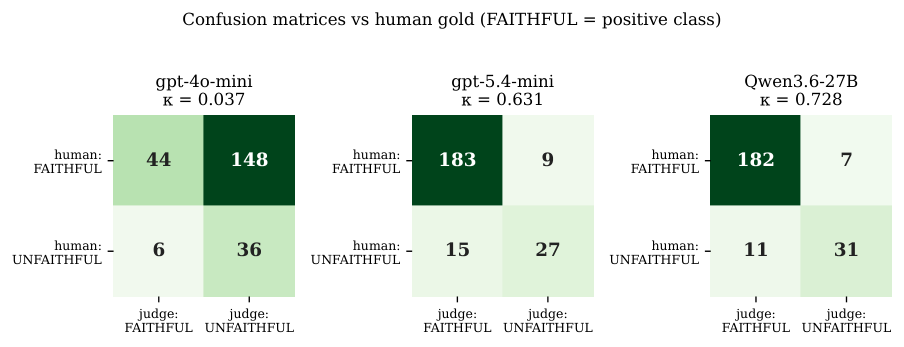
Проверка производственного конвейера text-to-SQL показала, что финальная модель-оценщик может почти случайно решать самые спорные случаи и систематически отклонять корректный SQL. Работа Santa Clara University и независимого исследователя пока не прошла рецензирование, и все числа получили сами авторы: у используемой gpt-4o-mini коэффициент каппа Коэна составил 0,04. Для команд это повод проверять оценщика на собственных данных до того, как его вердикты попадут в метрики продукта или обучающий набор.
Как измеряли согласие модели с людьми
Коэффициент каппа Коэна показывает, насколько две стороны согласны сверх совпадений, которые могли возникнуть случайно. В роли эталона выступили метки двух специалистов по SQL и предметной области; спорные случаи они разбирали совместно.
Основной набор включал 234 пары из вопроса и SQL. В него намеренно чаще попадали примеры, которые производственная модель уже сочла проблемными: такой отбор помогает искать поломку, но не показывает обычную частоту ошибок. На отдельной случайной проверке согласие gpt-4o-mini с людьми выросло до 0,42, поэтому результат основного набора нельзя переносить на весь поток без поправки на способ отбора.
Аудит не ограничивался итоговой метрикой. Для каждого ложного предупреждения разбирали текстовое объяснение модели, затем меняли отдельные части запроса и входных данных. Это позволило отличить общую слабость оценщика от повторяющейся причины ошибки.
Проверяли производственный англоязычный конвейер SynCA над одной телекоммуникационной базой SQLite. Он сформировал 1 482 принятые пары вопрос–SQL, которые использовались во внутреннем помощнике аналитика и системе непрерывной оценки моделей. Перенос подхода дополнительно проверили на BIRD-financial и нескольких базах Spider, но поведение конкретных оценщиков менялось вместе со схемой данных.
Почему исправление запроса не заменило новую модель
Главный сбой возникал при просмотре результата SQL. Увидев значения E, z или None, gpt-4o-mini придумывала ограничение, которого не было в вопросе: считала допустимыми только привычные категории и объявляла запрос неверным. В работе этот механизм назван галлюцинацией критерия.
Удаление предварительного просмотра строк подняло согласие до 0,37. Модель перестала цепляться за конкретные значения, но начала пропускать ошибки другого типа. Дополнительные инструкции, пошаговое рассуждение и более строгая формулировка критерия тоже меняли характер промахов, однако не закрывали разрыв с более подходящим оценщиком.
Самостоятельно развёрнутая Qwen3.6-27B достигла 0,72 и оказалась в том же диапазоне, что Claude Opus 4.7. Прямое сравнение этих моделей не позволило статистически подтвердить преимущество одной из них, но Qwen обходилась примерно в 300 раз дешевле за вызов при принятом в работе расчёте стоимости GPU. Поэтому команда заменила gpt-4o-mini на Qwen для обычного потока.
Практический порядок здесь важнее названия модели. Сначала нужен небольшой человеческий эталон из собственных спорных и обычных примеров, затем разбор причин ложных решений, после него — проверка нескольких кандидатов одним и тем же запросом. Исправлять только формулировку запроса имеет смысл, если эксперимент показывает, что ошибка связана с конкретным входом и не сменяется противоположной.
Ансамбль стоит добавлять только после отдельной проверки участников
Смешивание слабого оценщика с сильным ухудшило результат: их расхождения почти всегда означали ошибку слабой модели, а не полезное второе мнение. Поэтому простое голосование нескольких дешёвых моделей не даёт надёжности автоматически.
Иначе сработала схема из трёх компетентных оценщиков. Она принимала решение только при полном согласии, достигла каппы 0,79 и автоматически обработала 89,7% примеров. Остальные случаи уходили человеку; выигрыш возник именно из-за отказа решать спорные задачи, а не из-за усреднения вердиктов.
Для продуктовой команды работа меняет план внедрения в трёх местах. Модель-оценщик нужно считать отдельным компонентом с приёмочными испытаниями, а не объективной заменой ручной проверки. После смены схемы данных или версии модели её следует повторно сверять с доменными примерами. Ансамбль оправдан лишь тогда, когда каждый участник отдельно согласуется с людьми, а расхождения распределены между моделями, а не вызваны шумом одного слабого участника.
Для обычного потока достаточно одной проверенной и дешёвой модели. Маршрутизация по единогласию подходит для отбора обучающих данных и других сценариев, где ошибочный автоматический вердикт стоит дороже ручной проверки остатка.
Источники
Иллюстрация: рисунок из статьи «Auditing and Repairing LLM-as-Judge Failures in a Production Text-to-SQL Pipeline», Haowei Liu, Hsin-Tai Wu, Yi Fang, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


